Ratgeber
Wie funktioniert AI-Bilderzeugung? Einstieg in Diffusion
AI schneidet Bilder nicht aus einem Archiv zusammen: Sie beginnt mit zufälligem Rauschen und bereinigt es Schritt für Schritt. Lerne die Logik der Diffusion, die Rolle deines Prompts und was die Einstellungen tatsächlich verändern.
Zling AI Team9 Min. Lesezeit
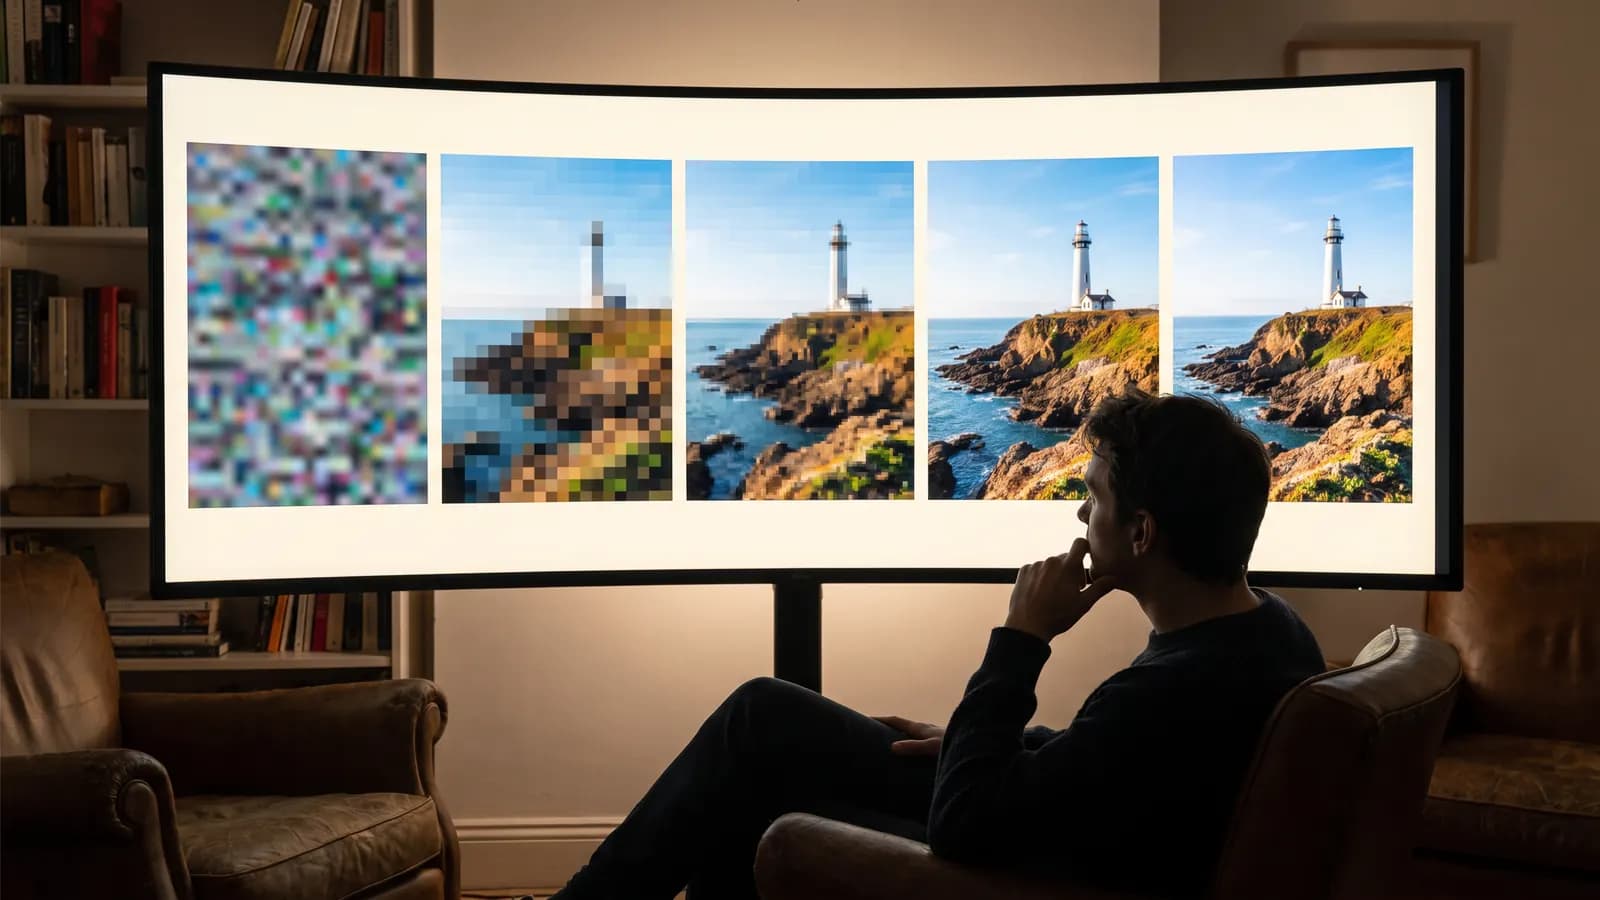
Kurze Antwort: Die meisten heutigen AI-Bildmodelle arbeiten mit einer Methode namens Diffusion. Das Modell beginnt mit einem Bild aus zufälligem Rauschen, das wie ein TV-Rauschen auf dem Bildschirm aussieht, und bereinigt dieses Rauschen in Dutzenden Schritten, während es deinen Satz berücksichtigt; mit jedem Schritt wird das Bild etwas schärfer. Dieser Artikel erklärt, wie der Prozess funktioniert, wo dein Prompt ins Spiel kommt und was die Einstellungen tatsächlich verändern, ohne dich mit Fachjargon zu überfordern.
Wie funktioniert AI-Bilderzeugung kurz gesagt?
Ein System, das Text in Bilder verwandelt, besteht aus drei Teilen, die zusammenarbeiten:
- Textkodierer: Wandelt deinen Prompt in eine Zahlendarstellung um, mit der das Modell arbeiten kann.
- Entrauschungsnetz: Betrachtet ein verrauschtes Bild und sagt das Rauschen darin voraus. Hier liegt die eigentliche Hauptlast.
- Decoder: Wandelt das Ergebnis, das das Modell in einem komprimierten Raum erzeugt hat, in die Pixel um, die du auf dem Bildschirm siehst.
Während der Erzeugung arbeitet das Entrauschungsnetz immer wieder am selben Bild. Bei jedem Durchgang berücksichtigt es die Informationen des Textkodierers und rückt das Bild ein Stück näher an deinen Prompt. Das Ergebnis ist kein fertiges Bild, das aus einem Archiv geholt wird, sondern ein neues Bild, das Schritt für Schritt genau in diesem Moment berechnet wird.
Was ist Diffusion? Vom Rauschen zum Bild
Die Idee der Diffusion geht auf eine Arbeit von Jascha Sohl-Dickstein und Kollegen aus dem Jahr 2015 zurück: Man definiert einen Prozess, der die Struktur in Daten langsam zerstört, und lernt dann, ihn umzukehren. Dass die Methode durch ihre Bildqualität auffiel, geschah 2020 mit dem Paper Denoising Diffusion Probabilistic Models (DDPM) von Jonathan Ho, Ajay Jain und Pieter Abbeel.
Training: Bilder zerstören und das Reparieren lernen
Beim Training werden dem Modell echte Bilder gezeigt, aber nicht in ihrer sauberen Form. Jedem Bild wird in kleinen Schritten zufälliges (Gauß-)Rauschen hinzugefügt. Im DDPM-Paper war dieser Zerstörungsprozess auf 1.000 Schritte eingestellt; beim letzten Schritt bleibt vom Bild fast nur reines Rauschen übrig. Die Aufgabe des Modells ist erstaunlich einfach: Es betrachtet das verrauschte Bild in einem beliebigen Schritt und sagt das Rauschen voraus, das hinzugefügt wurde. Indem es diese Vorhersage immer wieder für eine sehr große Zahl von Beispielen macht, lernt es indirekt, wie ein echtes Bild aussieht.
Erzeugung: Start aus reinem Rauschen
Beim Erzeugen eines Bildes läuft der Prozess umgekehrt. Das Modell startet mit reinem Rauschen, sagt das Rauschen darin voraus und entfernt einen Teil davon. Das daraus entstehende, etwas geordnetere Bild wird zur Eingabe des nächsten Schritts. In den ersten Schritten erscheinen grobe Farbflecken und die Komposition; in den mittleren Schritten setzen sich Formen; in den letzten Schritten werden feine Details wie Textur, Kanten und Licht scharf. Stell dir einen Bildhauer vor, der zuerst die groben Umrisse herausarbeitet und zuletzt die feinen Details.
Das Modell schneidet Bilder nicht aus einer Datenbank aus und klebt sie zusammen; es lernt allgemeine Muster aus den Beispielen, die es im Training gesehen hat, und berechnet bei jeder Erzeugung ein neues Bild. Forscher haben allerdings auch gezeigt, dass einige Bilder aus den Trainingsdaten fast genau reproduziert werden können. Deshalb ist es eine gute Gewohnheit, Prompts zu meiden, die ein bekanntes Kunstwerk oder eine Person Eins zu Eins nachahmen sollen.
Wie versteht das Modell deinen Satz?
Während das Rauschen entfernt wird, bestimmt dein Prompt, in welche Richtung sich das Bild entwickelt. Dafür durchläuft der Text zuerst einen Textkodierer. Ein wichtiger Schritt auf diesem Gebiet war CLIP, 2021 veröffentlicht: Es wurde auf 400 Millionen Bild-Text-Paaren aus dem Internet trainiert, um vorherzusagen, welche Beschreibung zu welchem Bild gehört. So kamen Wörter und visuelle Konzepte in denselben Zahlenraum.
Eine interessante Erkenntnis teilten die Google-Forscher bei ihrer Arbeit an Imagen: Ein großes Sprachmodell, das nur mit Text trainiert wurde (T5), als Textkodierer zu verwenden, liefert sehr gute Ergebnisse; den Kodierer zu vergrößern bringt außerdem mehr Qualität und Text-Bild-Übereinstimmung als das Vergrößern des Teils, der das Bild erzeugt. Das ist ein Grund, warum neuere Modelle lange, detaillierte Prompts besser verstehen.
Die Verbindung zwischen Text und Bild wird bei den meisten Modellen durch Cross-Attention-Schichten hergestellt: Bei jedem Schritt berechnet jeder Bereich des Bildes, auf welche Wörter des Prompts er „achten“ soll. Wenn du „eine Frau mit einem roten Regenschirm“ schreibst, sorgt genau diese Zuordnung dafür, dass das Rot zum Regenschirm wandert. Die Zuordnung ist nicht perfekt; deshalb rutscht manchmal eine Farbe oder Eigenschaft auf das falsche Objekt.
Warum nicht direkt mit Pixeln arbeiten? Der latente Raum
Ein Bild Pixel für Pixel über Dutzende Schritte zu verarbeiten ist sehr aufwendig. Das Paper Latent Diffusion Models (CVPR 2022) von Robin Rombach und Team machte den Ansatz populär, der dieses Problem löst: Zuerst wandelt ein Autoencoder das Bild in eine viel kleinere, komprimierte Darstellung (ein Latent) um; die Diffusion arbeitet auf dieser kleinen Darstellung; am Ende entpackt der Decoder das Ergebnis wieder zu einem Bild in voller Größe.
Ein konkretes Beispiel: Im Stable-Diffusion-Ablauf, der in der diffusers-Dokumentation von Hugging Face beschrieben wird, wird ein Bild mit 512×512 Pixeln als 64×64-Latent verarbeitet, das an jeder Kante achtmal kleiner ist. Die Rechenlast sinkt dadurch deutlich. Die meisten Modelle, die du heute nutzt, bauen auf einer Variante dieser Idee auf.
Wozu dienen die Einstellungen außer dem Prompt?
Die meisten Einstellungen, die du auf Erzeugungsbildschirmen siehst, steuern direkt einen Teil des oben beschriebenen Prozesses. Nicht jedes Modell zeigt alle, aber wenn du weißt, was sie bewirken, fällt es dir leichter, ein Ergebnis zu lesen und zu korrigieren.
| Einstellung | Teil des Prozesses | Praktische Wirkung |
|---|---|---|
| Seed (Startwert) | Das zufällige Rauschen am Anfang | Derselbe Seed, Prompt und dieselben Einstellungen ergeben meist dasselbe oder ein sehr ähnliches Ergebnis |
| Schrittzahl | Wie viele Entrauschungsdurchgänge laufen | Zu wenige Schritte ergeben ein unfertiges Bild; ab einem bestimmten Punkt wird der Unterschied kleiner und die Wartezeit länger |
| Guidance-Skala (CFG) | Wie stark der Prompt bei jedem Schritt gewichtet wird | Höhere Werte folgen dem Prompt strenger und verringern die Vielfalt; extreme Werte können künstlich wirken |
| Negativer Prompt | Konzepte, von denen sich das Modell entfernen soll | Hilft, unerwünschte Merkmale wie „unscharf“ oder „wenig Details“ zu verringern |
| Stärke (strength) | Wie viel Rauschen bei Bild-zu-Bild hinzugefügt wird | Niedrige Werte bleiben dem Foto treu, hohe Werte interpretieren es freier |
| Seitenverhältnis | Die Größe des Start-Rauschens | Bestimmt die Komposition; ein Hochformat passt zu Porträts, ein Querformat zu Landschaften |
Warum gibt es die Guidance-Skala?
Die Arbeit Classifier-Free Diffusion Guidance von Jonathan Ho und Tim Salimans beschrieb die Methode, die heute viele Modelle nutzen. Beim Training wird der Prompt von Zeit zu Zeit absichtlich leer gelassen, damit dasselbe Modell lernt, sowohl mit als auch ohne Prompt vorherzusagen. Bei der Erzeugung wird der Unterschied zwischen beiden Vorhersagen verstärkt, wodurch das Bild zum Prompt hin gedrängt wird. Die Erkenntnis des Papers erklärt auch, warum diese Einstellung ein Gleichgewicht ist: Steigt die Führung, werden einzelne Bilder treffsicherer, die Vielfalt aber sinkt. Das Imagen-Paper merkt außerdem an, dass sehr hohe Guidance-Werte übersättigte und unnatürliche Bilder erzeugen können.
Warum ergibt ein Seed dasselbe Ergebnis?
Der Seed ist der Startwert des Zufallszahlengenerators, der das Anfangsrauschen erzeugt. Derselbe Seed ergibt dasselbe Rauschen, und dasselbe Rauschen folgt mit demselben Prompt und denselben Einstellungen demselben Weg. Deshalb ist es der sauberste Weg, den Seed festzuhalten und im Prompt nur ein einziges Wort zu ändern, um dessen Wirkung zu sehen. Ein kleiner Hinweis: Wie auch die diffusers-Dokumentation feststellt, garantiert derselbe Seed auf anderer Hardware oder in einer anderen Softwareversion kein identisches Ergebnis.
Wie funktioniert Bild-zu-Bild?
Wenn du ein Foto hochlädst und „mach daraus ein Aquarellgemälde“ sagst, beginnt der Prozess nicht mit reinem Rauschen. Das Foto selbst wird in den latenten Raum umgewandelt, etwas Rauschen wird hinzugefügt, und die Entrauschung startet von diesem halb zerstörten Zustand. Diese Idee wurde 2021 im SDEdit-Paper beschrieben: Je mehr Rauschen du hinzufügst, desto freier wird das Ergebnis; je weniger, desto treuer bleibt es dem Foto.
Das Beispiel in der diffusers-Dokumentation zeigt das mit Zahlen: Bei 50 Schritten und einer Stärke von 0,8 werden dem Foto 40 Schritte Rauschen hinzugefügt und über 40 Schritte wieder entfernt. Nähert sich die Stärke 1,0, wird das Foto fast vollständig ignoriert. Wenn du ein Gesicht, ein Outfit oder ein Produkt erhalten willst, beginne mit einer niedrigen oder mittleren Stärke; wenn du die Szene komplett ändern willst, erhöhe sie.
Was hat sich bei neueren Modellen geändert?
Die Grundidee bleibt gleich, aber die Architektur verändert sich schnell:
- Transformer als Grundgerüst: Frühe Modelle nutzten ein faltendes Netz namens U-Net. Die Arbeit zu Diffusion Transformers (DiT) von William Peebles und Saining Xie zeigte, dass ein Transformer, der auf latenten Patches arbeitet, mit mehr Rechenleistung regelmäßig besser wird.
- Rectified Flow: Ein Paper von Patrick Esser und Team aus dem Jahr 2024 testete im großen Maßstab den Ansatz „Rectified Flow“, der Rauschen und Daten entlang einer geraden Linie verbindet. Die Autoren berichten, dass Transformer-Architekturen mit getrennten Gewichten für Text und Bild das Verständnis der Prompts und die Schrift im Bild (Typografie) verbessern.
- Weniger Schritte: Sampling-Methoden wie DDIM machten es möglich, aus demselben Modell 10- bis 50-mal schneller Proben zu ziehen, ohne das Training zu ändern. Sie gehören zu den Vorläufern der Methoden, die Ergebnisse mit weniger Schritten anstreben.
- Ansätze jenseits der Diffusion: Nicht jedes Bildmodell nutzt Diffusion. OpenAI hat erklärt, dass die eingebaute Bilderzeugung von GPT-4o ein autoregressives Modell ist, anders als DALL·E, das ein Diffusionsmodell ist.
Wie hilft dir dieses Wissen beim Schreiben von Prompts?
Wenn du die Logik der Diffusion kennst, kannst du deinen Prompt bewusster aufbauen. Da das Modell in den frühen Schritten die Komposition und in den späten die Details festlegt, sollte dein Prompt sowohl das große Ganze als auch die Details beschreiben. Du kannst diese Reihenfolge ausprobieren:
- Motiv: Was willst du sehen? Wähle ein Hauptelement.
- Umgebung und Licht: Wo, zu welcher Tageszeit, in welchem Licht?
- Bildausschnitt: Nahaufnahme, Weitwinkel oder Vogelperspektive?
- Stil: Foto, Aquarell, 3D-Illustration, alter Film ...
- Detail: Farbpalette, Textur, Materialien.
Ein schwacher Prompt:
ein schönes Café
Ein stärkerer Prompt:
Ein kleines Quartierscafé im Morgenlicht, eine dampfende Tasse Tee am Fenster, Holztisch, warme Töne, Weitwinkel, Stil einer Dokumentarfotografie
Beim zweiten Prompt bleibt dem Modell weniger zu raten: Licht, Ausschnitt und Stil sind festgelegt, daher drückt die Führung bei jedem Schritt in dieselbe Richtung. Wenn dir das Ergebnis nicht gefällt, halte den Seed fest und ändere immer nur eine Sache: zuerst das Licht, dann den Ausschnitt. So siehst du, welches Wort was verändert.
Häufige Fehler
- Widersprüchliche Wünsche: Ausdrücke wie „schlicht, aber sehr detailreich“ ziehen das Modell in zwei Richtungen zugleich.
- Lange Kommalisten: Unwichtige Wörter verwässern das Gewicht der wichtigen; schreibe zuerst die Hauptidee.
- Verneinungen im Hauptprompt: Viele Modelle verarbeiten verneinte Sätze schlecht, und „kein Hut“ kann den Hut erst recht ins Bild holen. Wenn das Modell es unterstützt, schreibe das in den negativen Prompt.
- Bei jedem Versuch alles ändern: Vergleiche ohne festgehaltenen Seed und feste Einstellungen sind irreführend.
- Perfekten Text im Bild erwarten: Neuere Modelle sind bei Schrift viel besser, aber in längeren Texten können noch Buchstabenfehler auftreten. Wenn du Text im Bild willst, halte ihn kurz.
Zusammenfassung
- Die meisten AI-Bildmodelle arbeiten mit Diffusion: Sie beginnen mit reinem Rauschen und bereinigen es Schritt für Schritt.
- Im Training lernt das Modell, Rauschen vorherzusagen; bei jeder Erzeugung berechnet es ein neues Bild.
- Dein Prompt läuft durch einen Textkodierer und lenkt bei jedem Schritt die Entrauschung.
- Dank des latenten Raums wird auf einer kleinen Darstellung gerechnet, die am Ende in Pixel umgewandelt wird.
- Der Seed legt das Startrauschen fest, die Guidance-Skala das Gewicht des Prompts, und die Stärke bestimmt, wie treu Bild-zu-Bild am Foto bleibt.
- Für gute Ergebnisse beschreibe Motiv, Licht, Ausschnitt und Stil klar und ändere bei jedem Versuch nur eine Sache.
Häufige Fragen
Kopieren AI-Bildmodelle Bilder aus dem Internet?
In der Regel nein: Das Modell lernt Muster aus den Beispielen, die es im Training gesehen hat, und berechnet bei jeder Erzeugung Schritt für Schritt ein neues Bild. Forscher haben jedoch gezeigt, dass einige Bilder aus den Trainingsdaten (darunter mehr als tausend Beispiele, etwa Personenfotos und Logos) fast genau reproduziert werden können. Deshalb ist es auch aus diesem Grund eine gute Gewohnheit, Prompts zu meiden, die bekannte Werke oder Personen Eins zu Eins kopieren.
Warum bekomme ich mit demselben Prompt jedes Mal ein anderes Bild?
Weil jede Erzeugung mit einem anderen zufälligen Rauschen beginnt. Wenn du den Seed festhältst, bleibt auch das Startrauschen gleich, und mit denselben Einstellungen erhältst du meist dasselbe oder ein sehr ähnliches Ergebnis; kleine Unterschiede können auf anderer Hardware oder in anderen Softwareversionen trotzdem auftreten.
Sind mehr Schritte immer besser?
Nein. Zu wenige Schritte ergeben ein unfertiges Bild, aber ab einem bestimmten Punkt machen zusätzliche Schritte keinen sichtbaren Unterschied und kosten nur Zeit. Sampling-Methoden wie DDIM wurden genau entwickelt, um mit weniger Schritten gute Ergebnisse zu erzielen.
Sollte ich die Guidance-Skala (CFG) ganz nach oben drehen?
Meist nicht. Hohe Werte binden das Ergebnis enger an den Prompt, verringern aber die Vielfalt, und sehr hohe Werte können übersättigte, künstlich wirkende Bilder erzeugen. Am sichersten ist es, mit dem Standardwert des Modells zu starten und ihn in kleinen Schritten zu verändern.
Wie verhindere ich bei Bild-zu-Bild, dass sich ein Gesicht verändert?
Halte die Stärke (strength), also die Einstellung, die steuert, wie viel Rauschen dem Foto hinzugefügt wird, niedrig und beschreibe im Prompt nur, was sich ändern soll. Mit steigender Stärke interpretiert das Modell das Foto freier, und Gesichtszüge können sich verändern.
Quellen
- Sohl-Dickstein et al. (2015), Deep Unsupervised Learning using Nonequilibrium Thermodynamics
- Ho, Jain, Abbeel (2020), Denoising Diffusion Probabilistic Models
- Song, Meng, Ermon (2020), Denoising Diffusion Implicit Models
- Radford et al. (2021), Learning Transferable Visual Models From Natural Language Supervision (CLIP)
- Meng et al. (2021), SDEdit: Guided Image Synthesis and Editing with Stochastic Differential Equations
- Rombach et al. (2022), High-Resolution Image Synthesis with Latent Diffusion Models
- Saharia et al. (2022), Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding (Imagen)
- Ho, Salimans (2022), Classifier-Free Diffusion Guidance
- Peebles, Xie (2022), Scalable Diffusion Models with Transformers
- Carlini et al. (2023), Extracting Training Data from Diffusion Models
- Esser et al. (2024), Scaling Rectified Flow Transformers for High-Resolution Image Synthesis
- OpenAI (2025), Addendum to GPT-4o System Card: Native image generation
- Hugging Face Diffusers: Understanding pipelines, models and schedulers
- Hugging Face Diffusers: Image-to-image
- Hugging Face Diffusers: Reproducibility
Ähnliche Beiträge
Ratgeber
Wie funktioniert AI-Videogenerierung? Die Idee hinter der Bewegung
Ein AI-Videomodell zeichnet Frames nicht einzeln, sondern baut die Bewegung als Ganzes auf. Wir erklären die Erweiterung der Diffusion auf die Zeit, warum Clips kurz bleiben und den Unterschied zwischen Text- und Fotoeingabe.
7 Min. Lesezeit
Ratgeber
KI-Generierungskosten: Wie funktionieren Kredit- und Tokensysteme?
KI-Tools berechnen die Generierung in Tokens oder Krediten, weil jede Erzeugung echte Rechenarbeit ist. Auflösung, Dauer und Modell bestimmen die Kosten; außerdem haben wir Wege gesammelt, weniger auszugeben.
7 Min. Lesezeit
Ratgeber
Browser oder App? Worauf du bei einem AI-Tool achten solltest
Der Browser eignet sich für detaillierte Arbeit auf großem Bildschirm, die App für schnelle Erzeugung vom Smartphone. Wir erklären die Unterschiede bei Bildschirm, Uploads, Datenschutz, Zahlung, Benachrichtigungen und Offline-Nutzung.
7 Min. Lesezeit