Ratgeber
Wie funktioniert AI-Videogenerierung? Die Idee hinter der Bewegung
Ein AI-Videomodell zeichnet Frames nicht einzeln, sondern baut die Bewegung als Ganzes auf. Wir erklären die Erweiterung der Diffusion auf die Zeit, warum Clips kurz bleiben und den Unterschied zwischen Text- und Fotoeingabe.
Zling AI Team7 Min. Lesezeit
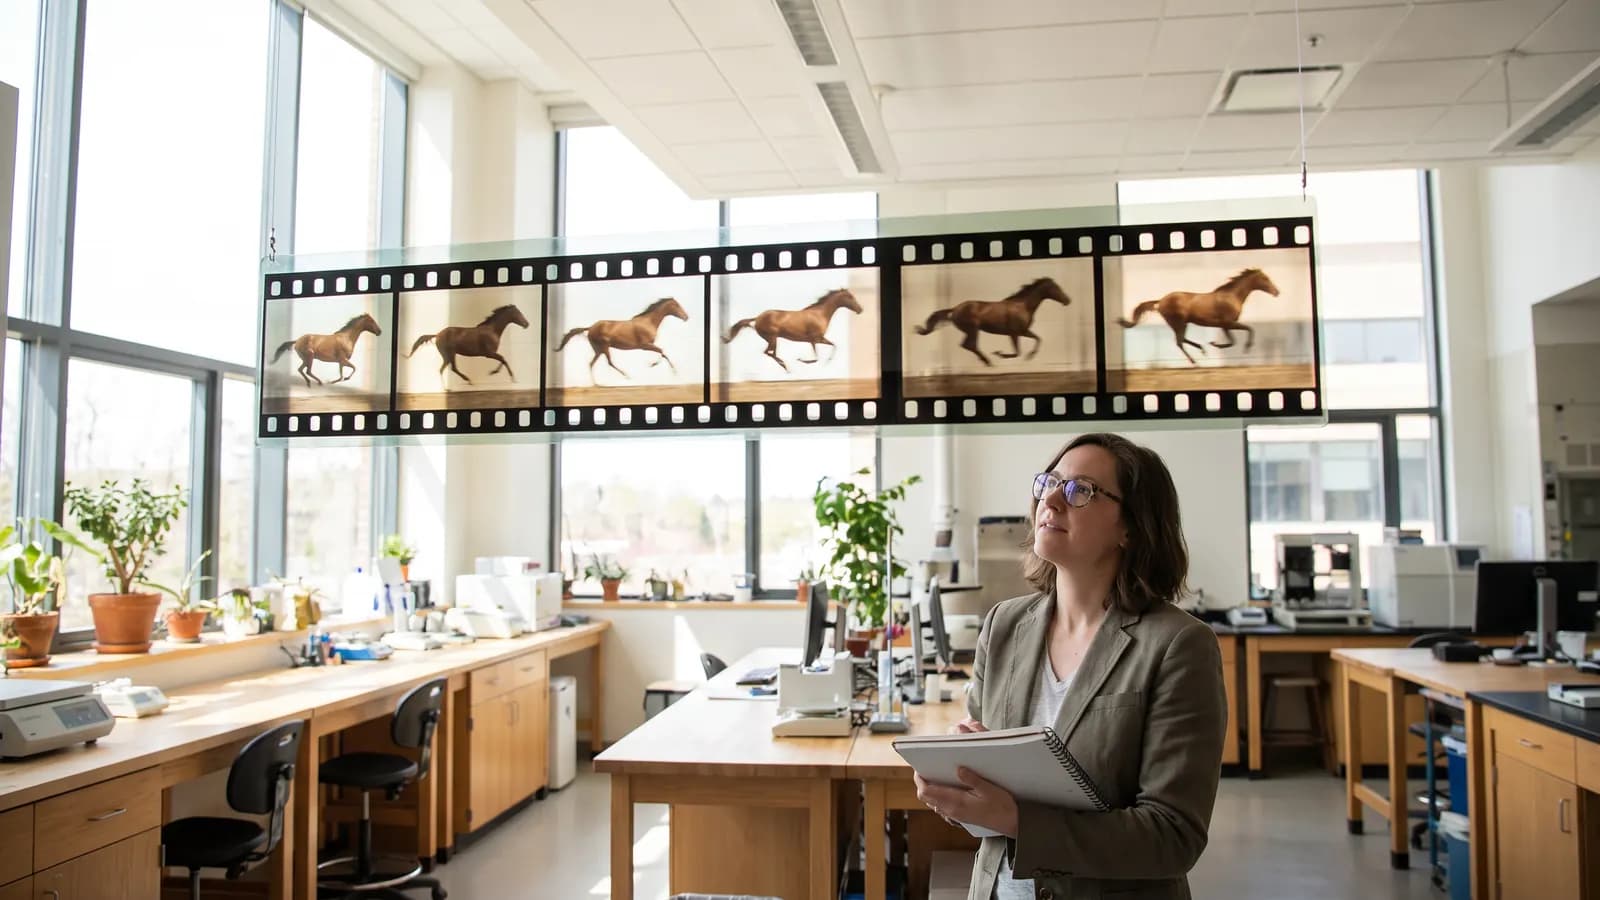
Kurze Antwort: Ein AI-Videomodell zeichnet ein Video nicht als einzelne Bilder, Frame für Frame. Es erzeugt die Frames gemeinsam, als ein Paket, das Bewegung und Zeit zusammen berücksichtigt. Die Diffusionsidee aus der Bildgenerierung steht weiterhin im Mittelpunkt, aber die Daten sind kein einzelnes Bild mehr, sondern eine über die Zeit verteilte Folge von Frames. Dieser Artikel erklärt, wie das gemacht wird, warum Clips kurz bleiben und worin sich Text- und Fotoeingaben unterscheiden. Grundlage sind die Aussagen der einschlägigen Fachartikel.
Was ist ein Video, und wie sieht das Modell es?
Ein Video ist eine feste Anzahl von Frames, die pro Sekunde nacheinander gezeigt werden. Für ein Modell ist das ein Datenblock mit Höhe, Breite und einer Zeitachse. Eine einfache Einführung in die Bildgenerierung findest du in unserem Artikel Wie funktioniert AI-Bildgenerierung?; die dort beschriebene Logik, vom Rauschen ausgehend Schritt für Schritt zu bereinigen, gilt auch hier. Der Unterschied: Bereinigt wird ein ganzer Block, der auch die Beziehungen zwischen den Frames enthält, nicht ein einzelnes Bild.
Wie wurde Diffusion auf die Zeit erweitert?
Die Arbeit von Ho und Kollegen zur Video-Diffusion beschreibt den Ansatz als natürliche Erweiterung der üblichen Bild-Diffusionsarchitektur. Sie hebt zwei Dinge hervor: Das gemeinsame Training des Modells mit Bildern und Videos beschleunigt die Optimierung und verringert die Varianz der Gradienten. Außerdem kann eine neue Technik des bedingten Samplings ein Video sowohl räumlich als auch zeitlich verlängern. Dieselbe Arbeit berichtet über die ersten Ergebnisse der textgesteuerten Videogenerierung in großem Maßstab.
Imagen Video setzt nicht auf ein einziges riesiges Modell, sondern auf eine Kette. Zuerst erzeugt ein Basismodell ein Video in niedriger Auflösung, danach vergrößern Super-Resolution-Modelle das Ergebnis im Wechsel räumlich (schärfere Frames) und zeitlich (flüssigere Bewegung). Auflösung und Flüssigkeit lassen sich so in getrennten Stufen lösen.
Neuere Modelle: Raum-Zeit-Patches
Der technische Bericht von OpenAI zu Sora fasst eine Idee zusammen, die viele aktuelle Systeme teilen: Text-konditionierte Diffusionsmodelle werden gemeinsam mit Videos und Bildern unterschiedlicher Dauer, Auflösung und Seitenverhältnisse trainiert, und zwar mit einem Transformer, der auf Raum-Zeit-Patches der latenten Codes von Video und Bild arbeitet. Zuerst reduziert ein Kompressionsnetz das Video in einen kleinen latenten Raum, und die aus diesem Raum ausgeschnittenen Patches dienen dem Transformer als Token. Am Ende überführt ein Decoder die latenten Codes zurück in Pixel. Der Bericht sagt außerdem, dass das größte Modell etwa eine Minute Video erzeugen kann. Er liefert qualitative Ergebnisse und teilt keine Modelldetails.
Das Movie-Gen-Paper von Meta weist in eine ähnliche Richtung: Das größte Videomodell ist ein Transformer mit 30 Milliarden Parametern, der 1080p-HD-Video mit synchronem Ton erzeugt. Außerdem kann es aus dem Bild eines Nutzers personalisierte Videos erstellen und anweisungsbasiert bearbeiten.
Was ist zeitliche Konsistenz, und warum ist sie schwer?
Konsistenz bedeutet, dass Gesicht, Kleidung und Szene einer Figur über alle Frames gleich bleiben und dass die Bewegung physikalisch plausibel wirkt. Würde man Frames unabhängig voneinander erzeugen, gäbe es in jedem Frame kleine Unterschiede und das Video würde flimmern. Genau deshalb verarbeiten Modelle die Frames gemeinsam: Jeder Frame entsteht, während das Modell berücksichtigt, was seine Nachbarn enthalten.
Konsistenz ist trotzdem nicht garantiert. Bei langen oder komplexen Bewegungen kann sich die Fingerzahl einer Hand ändern, Objekte können verschwinden oder ein Objekt kann sich in ein anderes verwandeln. Das liegt daran, dass das Modell die Physikregeln nicht kennt. Es lernt nur Muster aus seinen Trainingsdaten und macht im besten Fall eine sehr gute Schätzung.
Warum sind AI-Videoclips kurz?
Die offiziellen Quellen geben dafür keine Erklärung in einem Satz, aber die Zahlen geben Hinweise. Das Movie-Gen-Paper schreibt, der Kontext des Modells umfasse höchstens 73.000 Videotoken, was bei 16 Frames pro Sekunde etwa 16 Sekunden entspricht. Die Vergleichsnotiz auf Googles Veo-Seite nennt außerdem eine Länge von 8 Sekunden für Veo-Videos. Als allgemeiner Hintergrund gilt: Jede zusätzliche Sekunde erhöht sowohl die Zahl der zu verarbeitenden Token als auch den Speicher- und Rechenaufwand. Bei der Aufmerksamkeit (Attention) wächst der Aufwand mit der Länge der Sequenz schnell. Auch Fehler summieren sich: Ein Gesicht, das in der ersten Sekunde stimmt, kann zehn Sekunden später abdriften.
Die gängige Lösung für eine längere Szene ist, den vorhandenen Clip fortzusetzen. Die bedingte Sampling-Methode von Ho und Kollegen zeigt die wissenschaftliche Grundlage dafür, ein Video zeitlich zu verlängern, indem es an einen vorherigen Teil anknüpft. Auch die Veo-Seite sagt, dass Clips mit einer Szenenverlängerung erweitert werden können. In der Praxis heißt das: mehrere kurze Clips hintereinander erzeugen und zusammenschneiden.
Text-zu-Video und Foto-zu-Video im Vergleich
| Eingabe | Was macht das Modell? | Stärke | Achtung |
|---|---|---|---|
| Nur Text | Baut Szene, Person und Bewegung von Grund auf | Freie Kreativität | Komposition und Figur sind schwer vorherzusagen |
| Foto (+ Text) | Nimmt dein Bild als Start und fügt Bewegung hinzu | Aussehen bleibt fix, mehr Kontrolle | Das Modell erfindet neue Bereiche außerhalb des Fotos |
| Erster und letzter Frame | Erzeugt den Übergang zwischen zwei Frames | Start und Ende bestimmst du | Nicht jedes Modell unterstützt das |
Das Paper zu Stable Video Diffusion sagt, dass das Basismodell eine starke Bewegungsrepräsentation lernt, die sich an nachgelagerte Aufgaben wie Foto-zu-Video anpassen lässt. Die Veo-Seite nennt neben Text-zu-Video auch Foto-zu-Video, erster und letzter Frame sowie Referenzbilder als Eingaben. Kurz gesagt: Das Foto beantwortet die Frage „Wie soll es aussehen?“, der Text die Frage „Was soll passieren?“.
Warum sind die Trainingsdaten so wichtig?
Das Paper zu Stable Video Diffusion nennt drei Stufen beim Training von Videomodellen: Vortraining auf Text-zu-Bild, Vortraining auf Video und Feintuning mit hochwertigen Videos. Die Autoren betonen, dass ein gut kuratierter Vortrainingsdatensatz für ein gutes Modell notwendig ist und dass Beschriften und Filtern Teil dieses Prozesses sind. Das Ergebnis: Was ein Modell gut kann, hängt davon ab, welche Arten von Bewegung es gesehen hat. Bei seltenen Bewegungen oder ungewöhnlichen Szenen sinkt die Qualität.
Was kannst du tun, um die Ergebnisse zu verbessern?
- Verlange eine einzelne Bewegung: Wähle eine einzige Aktion statt „Die Frau dreht sich, lächelt, winkt und geht weg“.
- Benenne die Kamera: statische Einstellung, langsames Heranfahren, seitliches Mitfahren und so weiter.
- Gib das Startbild selbst vor: Wenn Konsistenz wichtig ist, probiere den Modus Foto-zu-Video.
- Kurz erzeugen, dann zusammensetzen: lieber kontrollierte kurze Clips als eine lange Anfrage.
- Mache mehrere Versuche: Dieselbe Anfrage führt zu unterschiedlichen Ergebnissen.
Beispielanfrage: Statische Kamera, eine Frau im roten Mantel geht am Abend an einer Küstenpromenade entlang, ihre Haare wehen leicht im Wind, langsames und natürliches Tempo.
Wie spielen Ton und Kamerabewegung hinein?
Manche Modelle erzeugen nicht nur Bild, sondern auch Ton. Das Movie-Gen-Paper sagt, es erzeuge zu 1080p-HD-Video synchronen Ton; auch die Veo-Seite erklärt, dass der Ton nativ erzeugt wird und Soundeffekte, Umgebungsgeräusche und Dialoge hinzugefügt werden können. Weil der Ton zusammen mit dem Bild geplant wird, lassen sich Lippenbewegungen und der Moment eines Ereignisses leichter abstimmen als mit einer nachträglich hinzugefügten Tonspur. Trotzdem schreibt die Seite deutlich, dass konsistente Sprache noch ein Feld aktiver Entwicklung ist.
Bei der Kamerabewegung nennt das Paper zu Stable Video Diffusion ein interessantes Detail: Das Basismodell lässt sich an kleine LoRA-Module anpassen, die für kameraspezifische Bewegungen trainiert wurden. Bewegungen wie „langsames Heranfahren“ oder „seitliches Gleiten“ sind also eine eigene Fähigkeit, die das Modell lernen kann. Deshalb hilft es, die Kamera in der Anfrage ausdrücklich zu benennen, damit das Modell diese Fähigkeit einsetzt.
Häufige Fehler
- Viele Aktionen in einer Anfrage: Das Modell vermischt die Bewegungen oder lässt sie aus.
- Keine Kamerabewegung angeben: Das Modell wählt eine zufällige Kamera.
- Perfekte Physik erwarten: Sieh dir das Ergebnis immer Frame für Frame an.
- Einen langen Clip auf einmal verlangen: Mit wachsender Dauer sinkt die Konsistenz.
- Sprache für garantiert halten: Die Veo-Seite sagt, dass konsistente Sprachausgabe besonders bei kurzen Abschnitten noch ein Feld aktiver Entwicklung ist.
- Das Ergebnis für echt halten oder unmarkiert teilen: Einige Systeme, etwa Veo, geben an, ihre Ausgaben mit SynthID zu markieren; beim Teilen solltest du selbst angeben, dass es KI-generiert ist.
Zusammenfassung
- Videomodelle erzeugen Frames gemeinsam und berücksichtigen dabei die Zeit; Grundlage ist Diffusion, die meisten nutzen einen Transformer.
- Konsistenz zwischen Frames ist das Ziel, keine Garantie.
- Die Längenbegrenzung kommt aus Rechenaufwand und Fehlerakkumulation; längere Szenen entstehen durch Verlängern oder Kombinieren von Clips.
- Der Text bestimmt, was passiert, das Foto, wie es aussieht; erster und letzter Frame verbinden beides.
- Eine Bewegung, eine klare Kamera und einige Versuche liefern meist das beste Ergebnis.
Häufige Fragen
Zeichnet ein AI-Videomodell jeden Frame als eigenes Bild?
Nein. Das Paper zur Video-Diffusion beschreibt den Ansatz als Erweiterung der Bild-Diffusion und verarbeitet Frames gemeinsam. So soll Konsistenz zwischen den Frames erreicht werden, garantiert ist das aber nicht.
Warum sind Videos meist nur wenige Sekunden lang?
Die offiziellen Quellen nennen keinen einzelnen Grund. Das Movie-Gen-Paper sagt, der Kontext sei auf 73.000 Token begrenzt, etwa 16 Sekunden, und die Veo-Seite nennt 8 Sekunden Länge für Veo-Videos. Allgemein steigen Rechenaufwand und Fehlerakkumulation mit der Dauer.
Wie bekommt man ein längeres Video?
Der übliche Weg ist, einen vorhandenen Clip fortzusetzen oder kurze Clips hintereinander zu erzeugen und zu kombinieren. Die Veo-Seite sagt, Clips lassen sich mit einer Szenenverlängerung erweitern.
Ist Foto-zu-Video oder Text-zu-Video besser?
Wenn das Aussehen konstant bleiben soll, ist Foto-zu-Video meist kontrollierter, weil du den Startframe vorgibst. Für eine freie Szene reicht Text-zu-Video.
Gilt das Modell aus dem Sora-Bericht für alle Systeme?
Nein. Der Bericht beschreibt eine Methode und qualitative Ergebnisse und teilt keine Modelldetails. Ein Transformer auf Raum-Zeit-Patches ist ein verbreiteter Ansatz, aber im Inneren unterscheiden sich die Systeme.
Quellen
- Ho ve ark.: Video Diffusion Models (arXiv:2204.03458)
- Ho ve ark.: Imagen Video: High Definition Video Generation with Diffusion Models
- Blattmann ve ark.: Stable Video Diffusion (arXiv:2311.15127)
- Meta: Movie Gen: A Cast of Media Foundation Models (arXiv:2410.13720)
- OpenAI: Video generation models as world simulators
- Google DeepMind: Veo
Ähnliche Beiträge
Ratgeber
Wie funktioniert AI-Bilderzeugung? Einstieg in Diffusion
AI schneidet Bilder nicht aus einem Archiv zusammen: Sie beginnt mit zufälligem Rauschen und bereinigt es Schritt für Schritt. Lerne die Logik der Diffusion, die Rolle deines Prompts und was die Einstellungen tatsächlich verändern.
9 Min. Lesezeit
Ratgeber
KI-Generierungskosten: Wie funktionieren Kredit- und Tokensysteme?
KI-Tools berechnen die Generierung in Tokens oder Krediten, weil jede Erzeugung echte Rechenarbeit ist. Auflösung, Dauer und Modell bestimmen die Kosten; außerdem haben wir Wege gesammelt, weniger auszugeben.
7 Min. Lesezeit
Ratgeber
Browser oder App? Worauf du bei einem AI-Tool achten solltest
Der Browser eignet sich für detaillierte Arbeit auf großem Bildschirm, die App für schnelle Erzeugung vom Smartphone. Wir erklären die Unterschiede bei Bildschirm, Uploads, Datenschutz, Zahlung, Benachrichtigungen und Offline-Nutzung.
7 Min. Lesezeit