Prompts
Produire le même personnage dans des scènes différentes avec l'IA
Pour un personnage cohérent : des images de référence nettes, une description détaillée et la retouche plutôt que la génération à partir de zéro. Chiffres, limites et règle d'autorisation des personnes réelles.
Équipe Zling AI8 min de lecture
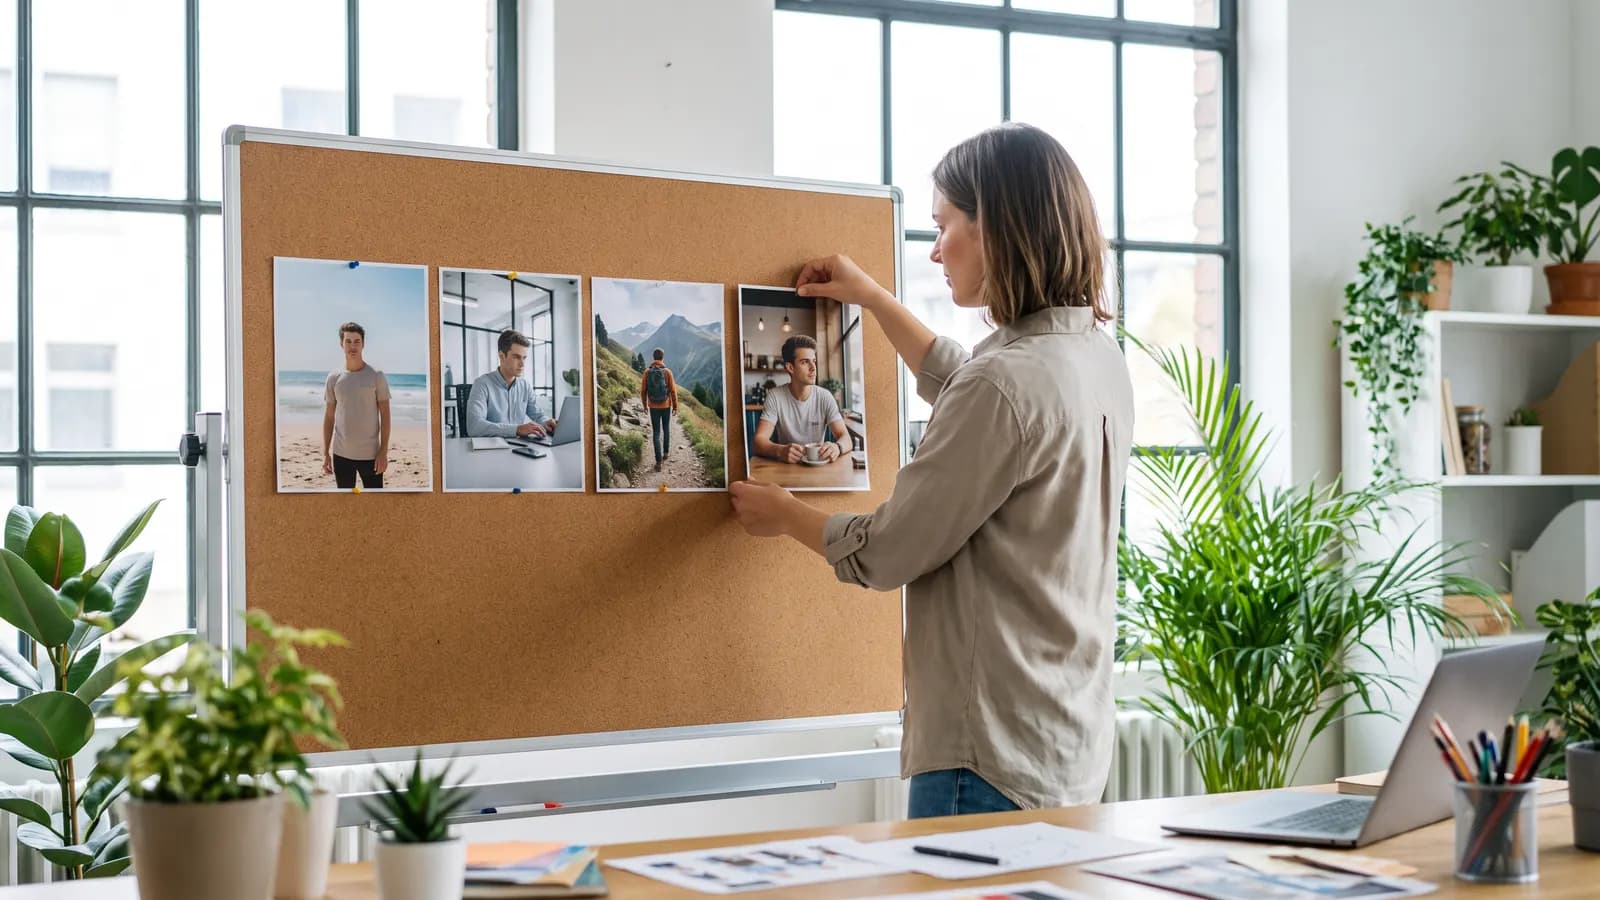
Réponse courte : la méthode la plus fiable pour garder un même personnage d'une scène à l'autre repose sur des images de référence nettes, une description détaillée identique dans chaque prompt et, si possible, la retouche plutôt que la génération à partir de zéro. Aucun modèle ne promet une cohérence parfaite ; la fiche modèle de Nano Banana de Google elle-même indique que la cohérence des personnages ne peut pas toujours être totalement assurée. Dans cet article, nous présentons les méthodes décrites dans la documentation officielle, les chiffres et les limites, ainsi que la règle d'autorisation pour les personnes réelles.
Pourquoi est-il difficile de garder un personnage cohérent ?
Les modèles génératifs produisent chaque résultat à partir de zéro ; même en relançant exactement le même prompt, le visage, les cheveux ou les vêtements varient légèrement. Pour dire au modèle « la même personne », il n'y a que deux moyens : lui montrer cette personne, ou la décrire avec une grande précision. C'est pourquoi toutes les méthodes reposent sur deux idées : fournir des références et garder la description stable.
Étape par étape : construire un personnage cohérent
1. Préparez une fiche de personnage
Commencez par produire un jeu de références propre pour un seul personnage : de face, de profil et en plan américain, avec un fond sobre et la même lumière. Le guide Veo de Google suggère aussi cette approche : générer d'abord les images de référence avec un modèle d'image (Nano Banana), puis les donner au modèle vidéo. Montrer un personnage sous plusieurs angles plutôt qu'avec une seule image puissante aide le modèle à en extraire les détails.
2. Rédigez une description détaillée et réutilisez-la à l'identique
Considérez la description comme une « fiche d'identité » du personnage, que vous copiez au début de chaque prompt. Ce qui doit rester stable : la tranche d'âge, la forme du visage, la couleur et la coupe des cheveux, le teint, les traits distinctifs, les vêtements et les accessoires.
Karakter: a man in his early thirties, short wavy dark-brown hair, light stubble, warm olive skin, round tortoiseshell glasses, a mustard-yellow knit sweater over a white shirt.
Sahne: [karakter künyesi] sits at a window table in a small café, reading a paperback, soft morning light, medium shot.
Employez les mêmes mots, dans le même ordre, à chaque prompt ; passer à des synonymes (« brun » au lieu de « châtain ») peut suffire à provoquer une dérive, même légère.
3. Nommez les références par leur rôle dans le prompt
D'après la documentation de l'API Gemini, les images de référence peuvent aller jusqu'à 14 au total ; la répartition dépend du modèle : Nano Banana Pro accepte 6 objets et 5 personnages, Nano Banana 2.1 accepte 10 objets et 4 personnages. La documentation de BFL indique aussi que FLUX.2 accepte plusieurs références (jusqu'à 8 via l'API) et recommande de citer les références dans l'ordre (« image 1 ») en précisant leur rôle.
Use the man from image 1 as the main character, keep his face, hairstyle and glasses exactly the same. Place him on a mountain trail at golden hour, wearing a dark green jacket.
4. Retouchez au lieu de regénérer
La documentation Gemini recommande d'itérer dans une conversation à plusieurs tours et montre comment préciser, dans une demande de retouche, ce qui ne doit pas changer. Si le personnage est juste sur une image, demandez la nouvelle scène comme une retouche : « place ce personnage dans tel décor, conserve son visage et ses vêtements à l'identique ». Une retouche introduit moins de dérive qu'une génération complète de la scène.
Keep the man's face, hair and clothing exactly the same. Change only the setting to a sunny beach and his pose to walking along the shoreline.
5. Utilisez les fonctions de référence dans la vidéo
La fonction « Ingredients to Video » de Google accepte jusqu'à trois images de référence ; selon la documentation de l'API Gemini, elles doivent représenter une même personne, un même personnage ou un même produit. L'annonce de janvier 2026 indique une amélioration de la cohérence des personnages d'une scène à l'autre, ainsi que de l'arrière-plan, et la première prise en charge de la vidéo verticale 9:16 dans ce mode. Pour le modèle H3 de MiniMax, la génération avec références accepte jusqu'à 9 images, 3 vidéos et 3 fichiers audio ; l'objectif est de garder cohérents un personnage, un mouvement, une caméra, un style ou un son. ByteDance a aussi présenté Seedance 2.5 avec une large prise en charge des références. Quel que soit l'outil, indiquez dans le prompt ce que représente chaque référence.
6. Utilisez la seed comme un appui, non comme une solution
Fixer la seed peut rendre les résultats plus semblables, mais la documentation ne garantit pas un résultat identique, même avec la même seed, et certains modèles n'ont pas de champ seed. Pour un personnage, la référence et la description restent le socle ; la seed n'est qu'un petit renfort.
Où la cohérence se dégrade-t-elle ? Les limites connues
- Aucune cohérence parfaite : la fiche modèle de Nano Banana 2.1 indique que la cohérence des personnages n'est pas toujours totalement assurée.
- Nombre de références limité : selon la documentation Gemini, le nombre de personnages acceptés dépend du modèle, soit 4 ou 5 ; au-delà, dans les scènes très peuplées, une dérive est à prévoir. La version Lite n'est pas optimisée pour plusieurs références.
- Changement d'angle : sur un profil ou une prise de dos, le détail du visage diminue souvent ; ajoutez alors des références prises sous ces angles.
- Vêtements et petits détails : motifs, écritures et bijoux peuvent varier d'une image à l'autre ; simplifier le détail améliore la cohérence.
- Durée de la vidéo : plus le clip s'allonge, plus le visage peut dériver ; produisez des clips courts et partez d'une première image cohérente.
- Langue du prompt : la description en anglais est en général plus prévisible avec la plupart des modèles.
Personnes réelles et règle d'autorisation
Utiliser comme référence votre propre photo ou celle de quelqu'un d'autre est techniquement possible ; la responsabilité éthique et juridique, elle, vous incombe. Une règle simple : n'utilisez pas la photo d'une personne sans son autorisation explicite. Montrer une personne disant ou faisant ce qu'elle n'a pas fait constitue un contenu trompeur. Pour les photos d'enfants, il faut en outre l'accord des parents. N'utilisez pas non plus l'image de personnalités connues ou de personnages reconnaissables comme référence. Marquez les images produites comme étant générées par IA ; de nombreuses plateformes l'exigent déjà.
Les personnages purement fictifs que vous avez créés vous-même peuvent être utilisés librement. Si vous préparez un projet avec une personne réelle, obtenez son accord écrit.
Exemple de flux de travail : une mini-histoire en trois scènes
Pour illustrer la méthode, produisons trois scènes d'un personnage, propriétaire d'un café. L'objectif est que la même personne apparaisse le matin, à midi et le soir.
- Fiche de personnage : produisez d'abord trois images nettes, de face, de profil et en plan américain ; fond sobre, même lumière.
- Description : écrivez la fiche du personnage dans un fichier texte et collez-la au début de chaque prompt.
- Scène 1 (matin) : donnez les images de référence et montrez le personnage devant la porte du café.
- Scène 2 (midi) : utilisez la scène 1 comme base de retouche : « conserve son visage et ses vêtements, change seulement le décor en un comptoir animé ».
- Scène 3 (soir) : même méthode, en ne changeant que la lumière et l'heure.
- Contrôle : placez les trois images côte à côte ; vérifiez que la coiffure, les lunettes et les vêtements restent identiques, et corrigez un détail qui dérive par une seule retouche.
Sahne 3: Keep the man from image 1 exactly the same, face, glasses, hair and mustard sweater. Change only the setting to the same café at night, warm lamp light, rain on the window, he is stacking chairs.
Cette méthode n'offre pas une cohérence parfaite, mais elle réduit la dérive ; lorsqu'un détail s'écarte, une seule retouche suffit souvent, sans tout recommencer.
Erreurs fréquentes
- Se fier à une seule référence : donnez des références nettes sous plusieurs angles.
- Modifier la description à chaque prompt : copiez la fiche à l'identique.
- Ne pas attribuer de rôle aux références : précisez quelle image représente le personnage et laquelle le décor.
- Tout regénérer : si le personnage est juste, demandez une retouche.
- Demander trop de personnages dans une scène : ne dépassez pas le nombre de personnages indiqué par la documentation.
- Utiliser la photo d'une personne réelle sans autorisation : demandez toujours l'accord avant.
En résumé
- La cohérence repose sur trois piliers : des références nettes, une même description, la retouche.
- Les nombres de références varient selon le modèle (par exemple 4 ou 5 personnages pour Nano Banana, trois images pour la fonction Ingredients to Video de Veo).
- Aucun modèle ne promet une cohérence parfaite ; la seed n'est qu'un petit appui.
- En vidéo, préférez des clips courts et les fonctions de référence.
- Pour une personne réelle, obtenez une autorisation explicite, celle des parents pour un enfant ; marquez les images comme produites par IA.
Questions fréquentes
Comment garder le même personnage avec l'IA ?
Combinez trois éléments : des images de référence nettes sous plusieurs angles, une description détaillée recopiée à l'identique dans chaque prompt, et la retouche plutôt que la génération complète. Aucun modèle ne promet une cohérence parfaite ; vérifiez chaque résultat.
Combien d'images de référence puis-je fournir ?
D'après la documentation de l'API Gemini, jusqu'à 14 au total : Nano Banana Pro accepte 5 personnages, Nano Banana 2.1 en accepte 4. La fonction « Ingredients to Video » de Veo accepte jusqu'à trois images, et H3 de MiniMax jusqu'à neuf.
La seed permet-elle de garder le personnage identique ?
Elle aide un peu, mais elle ne garantit pas le résultat : la documentation indique que même avec la même seed, le résultat peut différer, et certains modèles n'ont pas de champ seed. Les références et la description restent l'essentiel.
Pourquoi le visage du personnage change-t-il dans une vidéo ?
Plus le clip est long et plus l'angle change, plus les détails du visage peuvent dériver. Produisez des clips courts, partez d'une première image cohérente, utilisez les fonctions de référence et précisez dans le prompt le rôle de chaque image.
Puis-je utiliser la photo de quelqu'un d'autre comme référence ?
Seulement avec son autorisation explicite ; pour un enfant, l'accord des parents est nécessaire. Montrer une personne disant ou faisant ce qu'elle n'a pas fait est trompeur. Marquez les images comme produites par IA.
Sources
- Google AI for Developers: Image generation with Gemini (Nano Banana)
- Google DeepMind (2026), Nano Banana 2.1 model card
- Google (2026), Veo 3.1 Ingredients to Video: more consistency, creativity and control
- Google Cloud Blog (2025), The ultimate prompting guide for Veo 3.1
- MiniMax API Docs: Video Generation
- ByteDance Seed (2026), One-take Creation, Flexible Referencing: Introducing Seedance 2.5
- Black Forest Labs documentation: FLUX.2 overview
Articles similaires
Prompts
Bien rédiger un prompt : 12 règles pour les images IA
Un bon prompt d'image décrit la scène par des phrases concrètes et visibles, pas par une liste de mots. Nous réunissons 12 règles, chacune avec un exemple avant-après, et les recommandations de la documentation officielle.
8 min de lecture
Prompts
Bien rédiger un prompt vidéo : caméra, lumière et rythme
Un bon prompt vidéo décrit un seul plan continu : ce que fait la caméra, d'où vient la lumière, comment le sujet bouge. Règles pratiques et exemples tirés des guides de Veo, Wan et MiniMax.
8 min de lecture
Prompts
Seed, format, résolution : à quoi servent les réglages de l'IA ?
La seed reproduit un résultat, le format fixe le cadrage, le guidage et la force règlent l'adhérence au prompt et la fidélité à la photo. Comportement de chaque réglage selon la documentation officielle.
8 min de lecture