Guides
Comment marche la génération d'images IA ? Introduction à la diffusion
L'IA ne découpe pas des images dans une archive : elle part d'un bruit aléatoire et le nettoie étape par étape. Découvrez la logique de la diffusion, la place du prompt dans ce processus et ce que changent les réglages.
Équipe Zling AI11 min de lecture
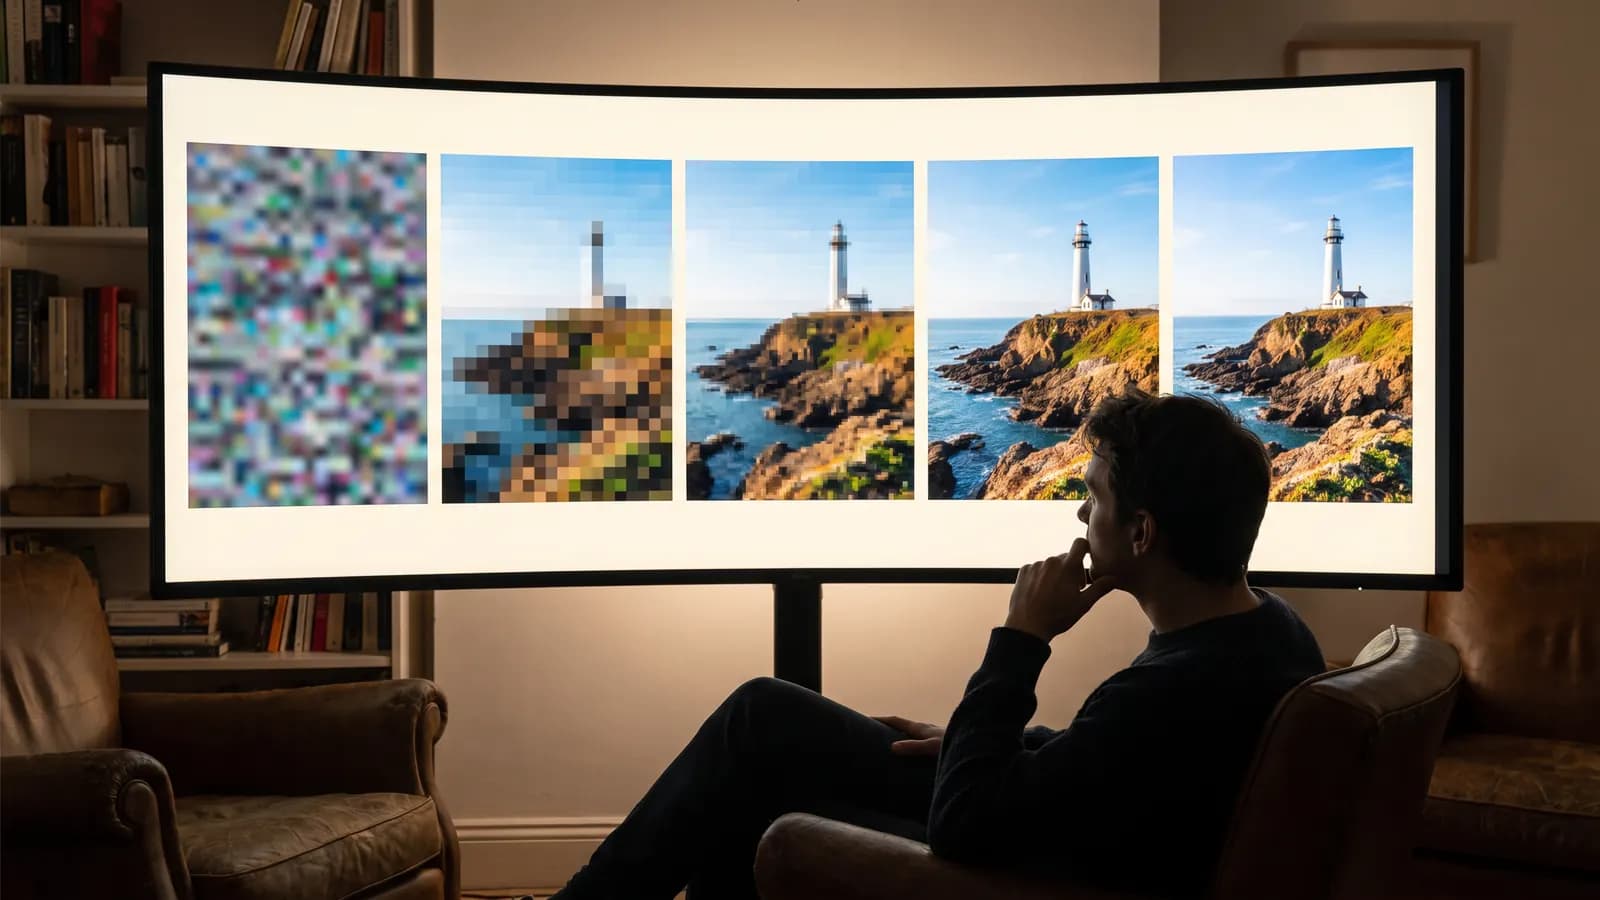
Réponse courte : la plupart des modèles d'image IA actuels fonctionnent avec une méthode appelée diffusion. Le modèle part d'un écran de « neige » fait de bruit aléatoire, puis, en lisant la phrase que vous avez écrite, il nettoie ce bruit en plusieurs dizaines d'étapes ; à chaque étape, l'image gagne en netteté. Dans cet article, nous expliquons comment ce processus fonctionne, où intervient le prompt et ce que changent réellement les réglages, sans jargon inutile.
Comment la génération d'image par IA fonctionne-t-elle en bref ?
Un système qui génère une image à partir de texte est composé de trois éléments qui travaillent ensemble :
- Encodeur de texte : il transforme votre prompt en une représentation numérique que le modèle peut traiter.
- Réseau de débruitage : il observe une image bruitée et estime le bruit qu'elle contient. C'est là que se situe l'essentiel du calcul.
- Décodeur : il convertit le résultat, calculé dans un espace compressé, en pixels que vous voyez à l'écran.
Pendant la génération, le réseau de débruitage travaille à plusieurs reprises sur la même image. À chaque tour, il consulte l'information fournie par l'encodeur de texte et rapproche l'image de votre prompt. Le résultat n'est donc pas une image toute faite, retrouvée dans une archive, mais une nouvelle image calculée pas à pas.
Qu'est-ce que la diffusion ? Du bruit à l'image
L'idée de la diffusion est apparue en 2015 avec l'article de Jascha Sohl-Dickstein et de ses collègues : définir un processus qui détruit peu à peu la structure des données, puis apprendre à inverser ce processus. Cette méthode s'est imposée pour la qualité visuelle en 2020, avec l'article de Jonathan Ho, Ajay Jain et Pieter Abbeel Denoising Diffusion Probabilistic Models (DDPM).
L'entraînement : apprendre à abîmer puis à réparer une image
Pendant l'entraînement, le modèle reçoit de vraies images, mais pas dans leur état propre. Un bruit aléatoire gaussien est ajouté à chaque image par petites étapes. Dans l'article DDPM, ce processus de dégradation comptait 1 000 étapes ; à la dernière, il ne reste pratiquement que du bruit pur. La tâche du modèle est étonnamment simple : à partir d'une image bruitée, à n'importe quelle étape, il doit deviner le bruit qui y a été ajouté. En répétant cette prédiction sur un très grand nombre d'exemples, le modèle apprend indirectement à quoi ressemble une véritable image.
La génération : partir d'un bruit pur
Lorsque vous générez une image, le processus fonctionne à l'envers. Le modèle part d'un bruit pur, estime le bruit qu'il contient et en retire une partie. L'image un peu plus ordonnée qui en résulte devient l'entrée de l'étape suivante. Dans les premières étapes apparaissent des taches de couleur grossières et la composition ; dans les étapes intermédiaires, les formes se fixent ; dans les dernières, la texture, les contours et la lumière deviennent nets. Pensez à un sculpteur qui dégrossit d'abord le bloc, puis affine les détails.
Le modèle ne découpe pas et ne colle pas des images extraites d'une base de données ; il apprend à partir des exemples vus pendant l'entraînement des régularités générales, puis calcule une image nouvelle à chaque génération. Cela dit, des chercheurs ont montré que certaines images du jeu d'entraînement pouvaient être reproduites presque à l'identique. Éviter les prompts qui cherchent à imiter une œuvre célèbre ou une personne à l'identique reste donc une bonne habitude.
Comment le modèle comprend-il la phrase que vous écrivez ?
Pendant le débruitage, le prompt détermine la direction que prend l'image. Pour cela, le texte passe d'abord par un encodeur de texte. Une étape importante dans ce domaine a été CLIP, publié en 2021 : entraîné sur 400 millions de paires image-texte collectées sur Internet, il devait prédire quelle légende correspond à quelle image. Les mots et les notions visuelles se sont ainsi retrouvés dans le même espace numérique.
Le travail de Google sur Imagen a apporté un résultat intéressant : utiliser comme encodeur de texte un grand modèle de langage entraîné uniquement sur du texte (T5) donne de très bons résultats ; agrandir cet encodeur améliore davantage la qualité et l'accord entre texte et image que d'agrandir la partie qui génère l'image. C'est l'une des raisons pour lesquelles les modèles récents comprennent mieux les prompts longs et détaillés.
Le lien entre texte et image s'établit, dans la plupart des modèles, par des couches d'attention croisée (cross-attention) : à chaque étape, chaque zone de l'image calcule les mots du prompt auxquels elle doit « prêter attention ». Lorsque vous écrivez « une femme avec un parapluie rouge », c'est ce mécanisme qui fait passer le rouge au parapluie. Cette correspondance n'est pas parfaite : une couleur ou un attribut qui passe sur le mauvais objet en est la conséquence.
Pourquoi ne pas travailler directement sur les pixels ? L'espace latent
Traiter une image pixel par pixel, à travers des dizaines d'étapes, coûte très cher. L'article Latent Diffusion Models de Robin Rombach et de son équipe (CVPR 2022) a popularisé la solution : un auto-encodeur commence par convertir l'image en une représentation compressée, beaucoup plus petite (le latent) ; la diffusion travaille sur cette petite représentation ; à la fin, le décodeur la reconvertit en image pleine taille.
Un exemple concret : dans le processus de Stable Diffusion décrit dans la documentation diffusers de Hugging Face, une image de 512 × 512 pixels est traitée sous la forme d'un latent de 64 × 64, dont chaque côté est réduit d'un facteur 8. La charge de calcul baisse ainsi fortement. La plupart des modèles que vous utilisez aujourd'hui reposent sur une variante de cette idée.
À quoi servent les réglages en dehors du prompt ?
La plupart des réglages affichés dans les écrans de génération contrôlent directement une partie du processus décrit plus haut. Chaque modèle ne montre pas tous ces réglages, mais savoir ce qu'ils font facilite la lecture et la correction des résultats.
| Réglage | Partie du processus | Effet pratique |
|---|---|---|
| Seed (graine) | Bruit aléatoire de départ | Avec la même seed, le même prompt et les mêmes réglages, on obtient en général un résultat identique ou très proche |
| Nombre d'étapes | Nombre de passes de débruitage | Trop peu d'étapes donnent une image inachevée ; au-delà d'un certain seuil, la différence diminue et le temps augmente |
| Échelle de guidage (CFG) | Poids du prompt à chaque étape | Plus il est élevé, plus le résultat suit le prompt de près, au détriment de la variété ; des valeurs extrêmes donnent un aspect artificiel |
| Prompt négatif | Notions dont le modèle doit s'éloigner | Aide à réduire des défauts indésirables comme « flou » ou « peu de détails » |
| Force (strength) | Quantité de bruit ajoutée à la photo | Une valeur faible reste fidèle à la photo, une valeur élevée l'interprète plus librement |
| Ratio | Taille du bruit de départ | Détermine la composition ; le format vertical convient aux portraits, l'horizontal aux paysages |
À quoi sert l'échelle de guidage ?
L'étude de Jonathan Ho et Tim Salimans Classifier-Free Diffusion Guidance a décrit la méthode utilisée aujourd'hui par de nombreux modèles. Pendant l'entraînement, le prompt est parfois volontairement laissé vide ; le même modèle apprend ainsi à prédire avec et sans prompt. Pendant la génération, l'écart entre les deux prédictions est amplifié, et l'image est poussée vers le prompt. Les résultats de cette étude expliquent pourquoi ce réglage est un compromis : plus le guidage augmente, plus chaque image est fidèle au prompt, mais la variété diminue. L'article sur Imagen note aussi que des valeurs de guidage très élevées peuvent produire des images trop saturées et peu naturelles.
Pourquoi la seed donne-t-elle le même résultat ?
La seed est la valeur initiale du générateur de nombres aléatoires qui produit le bruit de départ. La même seed donne le même bruit ; et le même bruit, avec le même prompt et les mêmes réglages, suit le même chemin. Fixer la seed puis ne modifier qu'un seul mot du prompt est donc la façon la plus nette de voir l'effet de ce mot. Petite précision : comme le précise la documentation diffusers, une même seed ne garantit pas un résultat strictement identique sur un autre matériel ou avec une autre version du logiciel.
Comment la photo devient-elle une image (image-to-image) ?
Lorsque vous importez une photo et demandez « transforme-la en aquarelle », le processus ne part pas d'un bruit pur. La photo elle-même est convertie dans l'espace latent, une certaine quantité de bruit y est ajoutée, puis le débruitage part de cette version partiellement dégradée. Cette idée a été décrite en 2021 dans l'article SDEdit : plus on ajoute de bruit, plus le résultat est libre ; moins on en ajoute, plus il reste fidèle à la photo.
L'exemple de la documentation diffusers chiffre ce mécanisme : avec 50 étapes et une force de 0,8, 40 étapes de bruit sont ajoutées à la photo, puis nettoyées pendant 40 étapes. Plus la force se rapproche de 1,0, plus la photo est presque entièrement ignorée. Si vous voulez conserver le visage, un vêtement ou un produit, commencez avec une force faible ou moyenne ; si vous voulez changer la scène entière, augmentez-la.
Qu'est-ce qui a changé dans les modèles récents ?
Le principe reste le même, mais l'architecture évolue rapidement :
- Un squelette transformer : les premiers modèles utilisaient U-Net, un réseau convolutif. Le travail de William Peebles et Saining Xie sur les Diffusion Transformers (DiT) a montré qu'un transformer travaillant sur des fragments du latent s'améliore régulièrement quand on augmente le calcul.
- Rectified flow : l'article de Patrick Esser et de son équipe, publié en 2024, a testé à grande échelle l'approche « rectified flow », qui relie le bruit et les données par une trajectoire droite. Les auteurs indiquent que des architectures transformer utilisant des poids distincts pour le texte et l'image progressent dans la compréhension du prompt et dans l'écriture de texte dans l'image (typographie).
- Moins d'étapes : des méthodes d'échantillonnage comme DDIM ont permis d'obtenir des exemples 10 à 50 fois plus rapidement à partir du même modèle, sans le réentraîner. Elles comptent parmi les précurseurs des méthodes qui cherchent à obtenir un bon résultat en peu d'étapes.
- Des approches sans diffusion : tous les modèles d'image n'utilisent pas la diffusion. OpenAI a expliqué que la génération d'images intégrée à GPT-4o est un modèle autorégressif, à la différence de DALL·E, qui est un modèle de diffusion.
En quoi cette connaissance vous aide-t-elle à rédiger un prompt ?
Comprendre la logique de la diffusion permet de construire un prompt plus réfléchi. Comme le modèle fixe la composition dans les premières étapes et le détail dans les dernières, votre prompt doit décrire à la fois l'ensemble et les détails. Vous pouvez suivre cet ordre :
- Le sujet : que voulez-vous voir ? Choisissez un seul élément principal.
- Le décor et la lumière : où, à quelle heure de la journée, dans quelle lumière ?
- Le cadrage : gros plan, plan large, vue en plongée ?
- Le style : photo, aquarelle, dessin 3D, film ancien…
- Les détails : palette de couleurs, textures, matériaux.
Un prompt faible :
un joli café
Un prompt plus solide :
Un petit café de quartier à la lumière du matin, une tasse de thé fumante près de la fenêtre, table en bois, tons chauds, grand angle, style photo documentaire
Dans le second prompt, le modèle a moins de vide à combler : la lumière, le cadrage et le style étant définis, le guidage pousse à chaque étape dans la même direction. Si le résultat ne vous convient pas, fixez la seed et ne modifiez qu'un seul élément : d'abord la lumière, puis le cadrage. Vous verrez ainsi quel mot change quoi.
Erreurs fréquentes
- Demandes contradictoires : des expressions comme « sobre mais très détaillé » tirent le modèle dans deux directions à la fois.
- Longues listes séparées par des virgules : les mots secondaires diluent l'importance des mots essentiels ; commencez par l'idée principale.
- Écrire la négation dans le prompt principal : de nombreux modèles comprennent mal les phrases négatives, et « pas de chapeau » peut faire penser au chapeau. Si le modèle le permet, placez cela dans le prompt négatif.
- Changer tout à chaque essai : sans seed fixe ni réglages constants, les comparaisons sont trompeuses.
- Attendre une perfection dans le texte de l'image : les nouveaux modèles écrivent bien mieux, mais des fautes de lettres subsistent dans les textes longs. Si vous voulez du texte dans l'image, gardez-le court.
En résumé
- La plupart des modèles d'image IA utilisent la diffusion : ils partent d'un bruit pur et le nettoient étape par étape.
- Pendant l'entraînement, le modèle apprend à deviner le bruit ; à chaque génération, il calcule une image nouvelle.
- Le prompt passe par un encodeur de texte et guide chaque étape de débruitage.
- L'espace latent permet de faire le calcul sur une petite représentation ; le résultat est décodé en pixels à la fin.
- La seed fixe le bruit de départ, l'échelle de guidage pèse le prompt, la force détermine la fidélité à la photo.
- Pour un bon résultat, décrivez le sujet, la lumière, le cadrage et le style ; modifiez une seule chose à la fois.
Questions fréquentes
Les modèles d'image IA copient-ils les images sur Internet ?
En général non : le modèle apprend des régularités à partir des exemples d'entraînement et calcule une image nouvelle à chaque génération. Des chercheurs ont toutefois montré que certaines images du jeu d'entraînement pouvaient être reproduites presque à l'identique. Évitez donc les prompts qui cherchent à imiter une œuvre célèbre ou une personne.
Pourquoi le même prompt donne-t-il des images différentes ?
Chaque génération part d'un bruit aléatoire différent. Si vous fixez la seed, le bruit de départ est identique et, avec les mêmes réglages, vous obtenez en général le même résultat ou un résultat très proche ; un autre matériel ou une autre version du logiciel peut toutefois produire de petites différences.
Augmenter le nombre d'étapes améliore-t-il toujours le résultat ?
Non. Trop peu d'étapes donnent une image inachevée, mais au-delà d'un certain seuil, les étapes supplémentaires ne changent presque rien et allongent le temps de calcul. Des méthodes comme DDIM ont justement été conçues pour obtenir un bon résultat avec moins d'étapes.
Faut-il régler l'échelle de guidage (CFG) au maximum ?
En général non. Une valeur élevée attache davantage le résultat au prompt mais réduit la variété, et des valeurs très élevées peuvent produire des images trop saturées et artificielles. Partez de la valeur par défaut du modèle et modifiez-la par petites étapes.
Comment éviter que le visage change quand je transforme une photo ?
Réglez la force (strength) sur une valeur faible et ne décrivez dans le prompt que ce que vous voulez modifier. Plus la force augmente, plus le modèle interprète librement la photo et plus les traits du visage peuvent changer.
Sources
- Sohl-Dickstein et al. (2015), Deep Unsupervised Learning using Nonequilibrium Thermodynamics
- Ho, Jain, Abbeel (2020), Denoising Diffusion Probabilistic Models
- Song, Meng, Ermon (2020), Denoising Diffusion Implicit Models
- Radford et al. (2021), Learning Transferable Visual Models From Natural Language Supervision (CLIP)
- Meng et al. (2021), SDEdit: Guided Image Synthesis and Editing with Stochastic Differential Equations
- Rombach et al. (2022), High-Resolution Image Synthesis with Latent Diffusion Models
- Saharia et al. (2022), Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding (Imagen)
- Ho, Salimans (2022), Classifier-Free Diffusion Guidance
- Peebles, Xie (2022), Scalable Diffusion Models with Transformers
- Carlini et al. (2023), Extracting Training Data from Diffusion Models
- Esser et al. (2024), Scaling Rectified Flow Transformers for High-Resolution Image Synthesis
- OpenAI (2025), Addendum to GPT-4o System Card: Native image generation
- Hugging Face Diffusers: Understanding pipelines, models and schedulers
- Hugging Face Diffusers: Image-to-image
- Hugging Face Diffusers: Reproducibility
Articles similaires
Guides
Comment marche la génération vidéo IA ? L'idée derrière le mouvement
Un modèle vidéo IA ne dessine pas les images une à une, il construit le mouvement dans son ensemble. Nous expliquons comment la diffusion s'étend au temps, pourquoi les clips restent courts et la différence entre texte et photo en entrée.
8 min de lecture
Guides
Coût de la génération IA : comment fonctionnent jetons et crédits ?
Les outils IA facturent la génération en jetons ou en crédits, car chaque création représente un calcul réel. Le coût dépend de la résolution, de la durée et du modèle ; nous avons aussi rassemblé les moyens de dépenser moins.
8 min de lecture
Guides
Navigateur ou application ? Comment choisir un outil IA
Le navigateur est plus confortable pour les travaux détaillés sur grand écran, l'application pour les créations rapides depuis le téléphone. Nous comparons écran, import, confidentialité, paiement, notifications et hors connexion.
8 min de lecture