Guides
Comment marche la génération vidéo IA ? L'idée derrière le mouvement
Un modèle vidéo IA ne dessine pas les images une à une, il construit le mouvement dans son ensemble. Nous expliquons comment la diffusion s'étend au temps, pourquoi les clips restent courts et la différence entre texte et photo en entrée.
Équipe Zling AI8 min de lecture
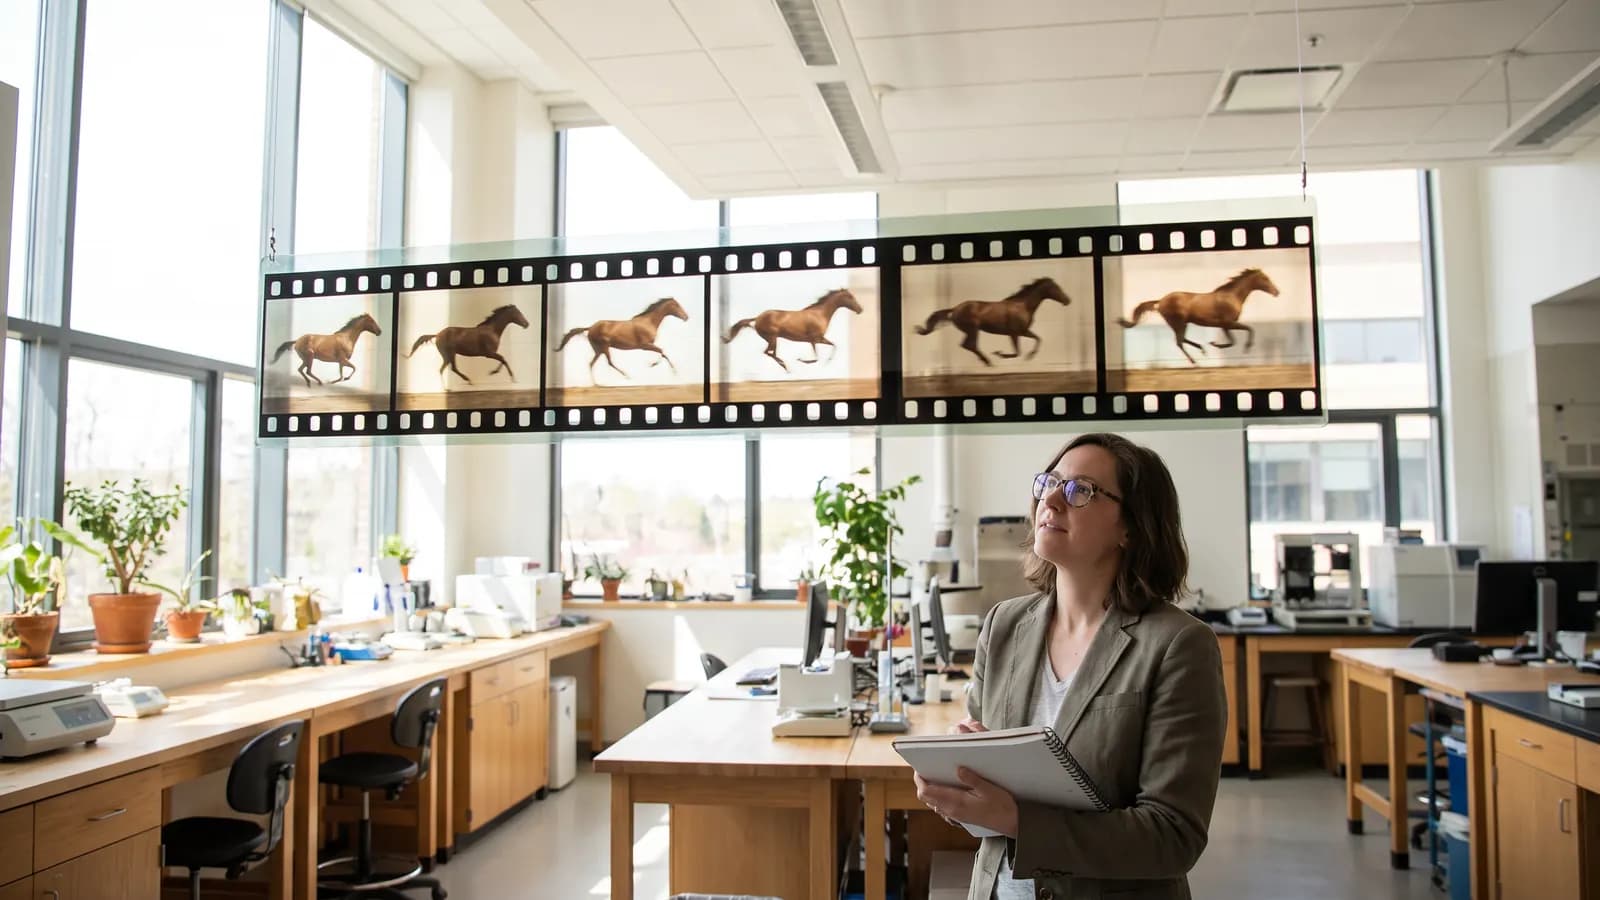
Réponse courte : un modèle vidéo IA ne dessine pas la vidéo image par image comme des dessins séparés ; il génère les images comme un seul ensemble, en tenant compte à la fois du mouvement et du temps. Le principe de diffusion utilisé pour la génération d'images est toujours là, mais la donnée n'est plus une image : c'est une suite d'images répartie dans le temps. Dans cet article, nous expliquons comment cela se fait, pourquoi les clips restent courts et quelle est la différence entre une entrée texte et une entrée photo, en nous appuyant sur ce que disent les articles de recherche.
Qu'est-ce qu'une vidéo pour un modèle, et comment la voit-il ?
Une vidéo est une succession d'images affichées à une cadence donnée, par exemple 24 images par seconde. Pour un modèle, c'est un bloc de données à trois dimensions : hauteur, largeur et un axe temporel. Pour une introduction à la génération d'images, lisez notre article Comment marche la génération d'images IA ? ; la logique de passer du bruit à l'image par petites étapes s'applique ici aussi. La différence est que ce qui est nettoyé n'est pas une image unique, mais un bloc entier qui contient aussi les relations entre les images.
Comment la diffusion s'est-elle étendue au temps ?
L'article de Ho et de ses collègues sur la diffusion vidéo présente cette approche comme une extension naturelle de l'architecture de diffusion pour les images. Il met en avant deux points : entraîner le modèle à la fois sur des images et sur des vidéos accélère l'apprentissage et réduit la variabilité des gradients ; une nouvelle méthode d'échantillonnage conditionnel permet d'étendre une vidéo dans l'espace comme dans le temps. Le même article rapporte les premiers résultats de génération de vidéo à partir de texte à grande échelle.
Imagen Video, de son côté, n'utilise pas un seul grand modèle mais une chaîne. Un modèle de base produit d'abord une vidéo à basse résolution, puis des modèles de super-résolution spatiale (qui affinent les images) et temporelle (qui rendent le mouvement plus fluide) agrandissent le résultat en alternance. La résolution et la fluidité peuvent ainsi être traitées dans des étapes distinctes.
Les modèles récents : patchs espace-temps
Le rapport technique de Sora d'OpenAI résume une idée partagée par beaucoup de systèmes actuels : des modèles de diffusion conditionnés par le texte sont entraînés sur des vidéos et des images de durées, résolutions et formats variés ; le modèle est un transformer qui travaille sur des patchs espace-temps issus des codes latents de la vidéo et de l'image. Un réseau de compression fait d'abord descendre la vidéo dans un petit espace latent ; les patchs découpés dans cet espace servent de « jetons » au transformer. En fin de génération, un décodeur reconvertit les codes latents en pixels. Le rapport indique aussi que le plus grand modèle peut produire une vidéo d'environ une minute. Il présente surtout des résultats qualitatifs et ne détaille pas le modèle.
L'article Movie Gen de Meta va dans le même sens : son plus grand modèle vidéo, un transformer de 30 milliards de paramètres, produit de la vidéo HD 1080p avec un son synchrone ; il permet aussi de générer une vidéo personnalisée à partir de l'image d'un utilisateur et de faire des modifications guidées par une consigne.
Qu'est-ce que la cohérence temporelle, et pourquoi est-elle difficile ?
La cohérence temporelle désigne le fait que le visage, les vêtements et le décor d'un personnage restent identiques d'une image à l'autre, et que le mouvement paraisse physiquement plausible. Si vous génériez chaque image séparément, de petites différences apparaîtraient à chaque image et la vidéo scintillerait. C'est la raison principale pour laquelle les modèles traitent les images ensemble : chaque image est produite en « voyant » ce que contiennent les images voisines.
Cela ne garantit pas la cohérence pour autant. Dans les mouvements longs ou complexes, le nombre de doigts d'une main peut changer, des objets peuvent disparaître, ou un objet peut se transformer en un autre. Cela tient au fait que le modèle ne connaît pas les lois de la physique ; il a appris des régularités à partir des données d'entraînement, ce qui donne au mieux une très bonne estimation.
Pourquoi les clips vidéo IA sont-ils courts ?
Les sources officielles n'ont pas d'explication en une phrase ; les chiffres, en revanche, donnent un indice. L'article Movie Gen indique que le contexte du modèle est limité à 73 000 jetons vidéo, soit environ 16 secondes à 16 images par seconde. La page de comparaison de Google sur Veo précise que les vidéos Veo durent 8 secondes. En règle générale, chaque seconde supplémentaire augmente à la fois le nombre de jetons à traiter et les besoins en mémoire et en calcul ; dans le mécanisme d'attention, le coût croît très vite avec la longueur de la séquence. Les erreurs s'accumulent aussi : un visage juste à la première seconde peut se déformer dix secondes plus tard.
La solution courante pour une scène plus longue consiste à prolonger le clip existant. La méthode d'échantillonnage conditionnel de Ho et de ses collègues illustre le fondement académique de l'extension temporelle d'une vidéo, en la reliant à la partie précédente ; la page de Veo indique que les clips peuvent être prolongés grâce à la fonction d'extension de scène. En pratique, cela revient à produire plusieurs courts clips à la suite et à les monter.
Entrée texte ou entrée photo : quelle différence ?
| Entrée | Ce que fait le modèle | Point fort | Point de vigilance |
|---|---|---|---|
| Texte seul | Construit la scène, la personne et le mouvement à partir de zéro | Liberté créative | Composition et personnage difficiles à prévoir |
| Photo (+ texte) | Prend l'image comme point de départ et ajoute le mouvement | L'apparence reste stable, contrôle accru | Le modèle invente les zones situées hors du cadre de la photo |
| Première et dernière image | Génère la transition entre les deux images | Vous fixez le début et la fin | Tous les modèles ne le proposent pas |
L'article Stable Video Diffusion explique que le modèle de base apprend une représentation solide du mouvement, et que celle-ci peut être adaptée à des tâches comme la génération à partir d'une photo. La page de Veo, de son côté, énumère en plus de la génération à partir de texte la génération à partir d'une photo, à partir de la première et de la dernière image, et à partir d'images de référence. La photo dit donc au modèle « à quoi ça doit ressembler », et le texte « ce qui doit se passer ».
Pourquoi les données d'entraînement comptent-elles autant ?
L'article Stable Video Diffusion décrit trois étapes pour entraîner un modèle vidéo : pré-entraînement sur les images à partir de texte, pré-entraînement sur la vidéo, puis affinage avec des vidéos de haute qualité. Les auteurs soulignent qu'un bon modèle suppose un jeu de données de pré-entraînement bien sélectionné, et que le sous-titrage et le filtrage en font partie. Le résultat : ce qu'un modèle fait bien dépend des mouvements qu'il a vus. Les mouvements rares ou les scènes inhabituelles donnent en général une qualité moindre.
Comment améliorer le résultat ?
- Demandez un seul mouvement : plutôt que « la femme tourne, sourit, salue et s'éloigne », choisissez une seule action.
- Nommez la caméra : plan fixe, lent rapprochement, travelling latéral…
- Fournissez vous-même l'image de départ : si la cohérence compte, essayez le mode photo vers vidéo.
- Générez court, puis assemblez : plusieurs clips contrôlés plutôt qu'une longue demande unique.
- Faites plusieurs essais : la même demande donne des résultats différents.
Exemple de demande : Plan fixe, une femme en veste rouge marche sur une plage au coucher du soleil, ses cheveux bougent légèrement au vent, rythme lent et naturel.
Le son et le mouvement de caméra entrent-ils en jeu ?
Certains modèles génèrent aussi le son, pas seulement l'image. L'article Movie Gen indique que la vidéo HD 1080p est accompagnée d'un son synchrone ; la page de Veo précise que le son est généré localement et qu'il peut comporter des effets sonores, une ambiance et des dialogues. Comme le son est planifié avec l'image, la synchronisation des lèvres et des événements est plus facile à obtenir qu'avec un son ajouté après coup. La page souligne toutefois que la parole cohérente reste un domaine en progrès.
Pour le mouvement de caméra, l'article Stable Video Diffusion donne un détail intéressant : le modèle de base peut être adapté à des mouvements de caméra spécifiques au moyen de petits modules LoRA entraînés pour cela. Autrement dit, des mouvements comme « rapprochement lent » ou « glissement latéral » sont une compétence distincte que le modèle peut apprendre. Nommer la caméra dans la demande aide donc le modèle à activer cette compétence.
Erreurs fréquentes
- Écrire plusieurs actions dans une même demande : le modèle mélange ou saute des mouvements.
- Ne pas préciser la caméra : le modèle en choisit une au hasard.
- Attendre une physique parfaite : vérifiez le résultat image par image.
- Demander un long clip d'un seul coup : plus la durée augmente, plus la cohérence baisse.
- Considérer la parole comme acquise : la page de Veo indique que la parole cohérente, surtout dans les courts passages, reste un domaine en progrès.
- Publier une création sans la signaler : Veo, par exemple, marque ses sorties avec SynthID ; de votre côté, indiquez aussi que la vidéo est produite par IA.
En résumé
- Les modèles vidéo génèrent les images ensemble, en tenant compte du temps ; le fondement est souvent la diffusion, et de nombreux systèmes utilisent un transformer.
- La cohérence entre les images est visée, mais elle n'est pas garantie.
- La durée limitée vient du coût de calcul et de l'accumulation des erreurs ; les scènes longues se construisent en prolongeant ou en assemblant des clips.
- Le texte définit ce qui se passe, la photo définit l'apparence ; la première et la dernière image relient les deux.
- Un seul mouvement, une caméra nommée et quelques essais donnent souvent le meilleur résultat.
Questions fréquentes
Un modèle vidéo IA dessine-t-il chaque image séparément ?
Non. L'article sur la diffusion vidéo présente l'approche comme une extension de la diffusion d'images, et les images sont traitées ensemble. La cohérence entre elles est recherchée, mais elle n'est pas garantie.
Pourquoi les vidéos IA ne durent-elles que quelques secondes ?
Les sources officielles ne donnent pas une seule cause. L'article Movie Gen indique un contexte limité à 73 000 jetons vidéo, soit environ 16 secondes, et la page de Veo mentionne des vidéos de 8 secondes. En général, plus la durée augmente, plus le coût de calcul et l'accumulation des erreurs augmentent.
Comment obtenir une vidéo plus longue ?
La méthode courante consiste à prolonger le clip existant ou à produire plusieurs courts clips puis à les monter. La page de Veo indique que les clips peuvent être prolongés grâce à la fonction d'extension de scène.
La génération à partir d'une photo est-elle meilleure que celle à partir de texte ?
Si vous voulez garder une apparence stable, la photo donne en général plus de contrôle, puisque vous fournissez l'image de départ. Pour une scène plus libre, la génération à partir de texte suffit.
Le rapport Sora décrit-il tous les modèles vidéo ?
Non. Le rapport décrit une méthode et des résultats qualitatifs, sans détailler le modèle. L'approche par patchs espace-temps dans un transformer est courante, mais l'architecture interne de chaque système peut différer.
Sources
- Ho ve ark.: Video Diffusion Models (arXiv:2204.03458)
- Ho ve ark.: Imagen Video: High Definition Video Generation with Diffusion Models
- Blattmann ve ark.: Stable Video Diffusion (arXiv:2311.15127)
- Meta: Movie Gen: A Cast of Media Foundation Models (arXiv:2410.13720)
- OpenAI: Video generation models as world simulators
- Google DeepMind: Veo
Articles similaires
Guides
Comment marche la génération d'images IA ? Introduction à la diffusion
L'IA ne découpe pas des images dans une archive : elle part d'un bruit aléatoire et le nettoie étape par étape. Découvrez la logique de la diffusion, la place du prompt dans ce processus et ce que changent les réglages.
11 min de lecture
Guides
Coût de la génération IA : comment fonctionnent jetons et crédits ?
Les outils IA facturent la génération en jetons ou en crédits, car chaque création représente un calcul réel. Le coût dépend de la résolution, de la durée et du modèle ; nous avons aussi rassemblé les moyens de dépenser moins.
8 min de lecture
Guides
Navigateur ou application ? Comment choisir un outil IA
Le navigateur est plus confortable pour les travaux détaillés sur grand écran, l'application pour les créations rapides depuis le téléphone. Nous comparons écran, import, confidentialité, paiement, notifications et hors connexion.
8 min de lecture