Photo
Texte vers image ou image vers image ? Choisir le bon mode
Si vous avez une idée, partez du texte ; si vous voulez garder quelque chose, partez d'une photo. Nous présentons ce que chaque mode conserve ou modifie, le rôle des images de référence et des prompts d'exemple.
Équipe Zling AI8 min de lecture
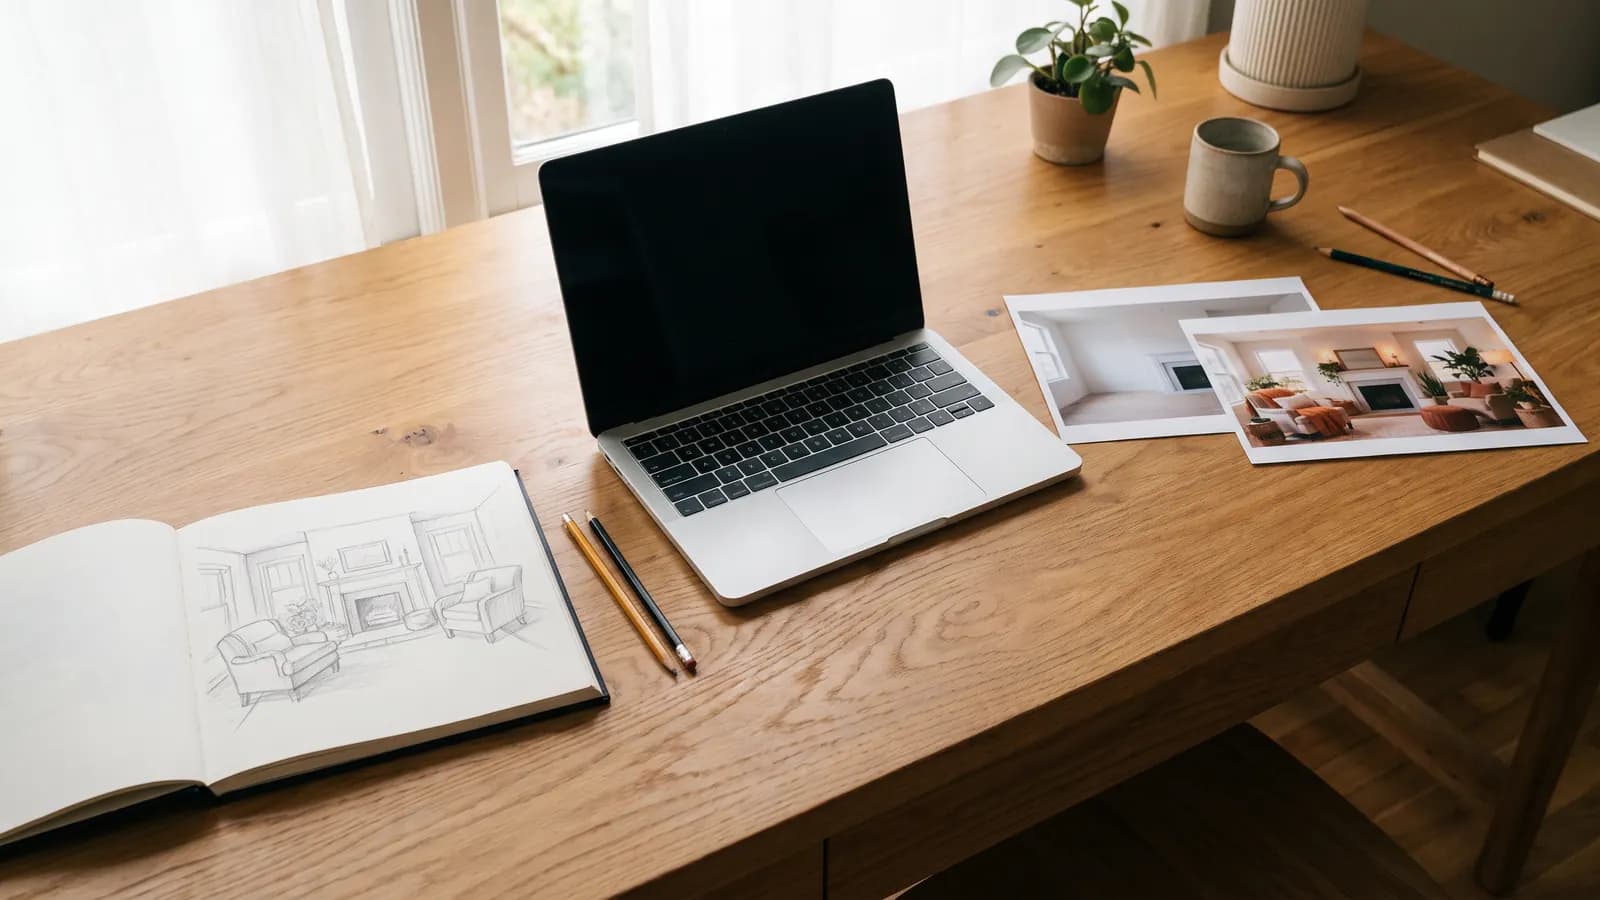
Réponse courte : si vous n'avez qu'une idée, commencez par le texte vers l'image ; si vous avez un élément à conserver (une pièce, un visage, un produit), commencez par l'image vers l'image. En texte vers image, le modèle construit tout à partir de zéro ; en image vers image, votre photo sert de point de départ et le modèle a pour tâche de la modifier. Dans cet article, nous expliquons quand utiliser chaque mode, ce qu'il conserve et ce qu'il change, et comment les combiner, avec des exemples.
Que signifient texte vers image et image vers image ?
Le texte vers image (text-to-image) produit une image à partir de la seule description que vous écrivez. L'image vers image (image-to-image) est le mode dans lequel vous fournissez une image et un texte : l'image sert de point de départ, et le texte indique ce qu'il faut faire. La documentation de l'API Gemini décrit précisément ce cas : à partir d'une image et d'une instruction, vous pouvez ajouter, retirer ou remplacer un élément, ajuster le style ou les tons de couleur. Cette même documentation recommande de procéder par conversation à plusieurs tours, en améliorant le résultat étape par étape.
En pratique, la différence tient à ceci : en texte vers image, la question « que faut-il conserver ? » ne se pose pas, puisqu'il n'y a rien à conserver. En image vers image, chaque prompt répond implicitement à une question : que vais-je conserver dans cette image, et que vais-je modifier ?
Quand commencer par le texte ?
Lorsque vous n'avez pas de référence, ou lorsqu'une référence risquerait de vous enfermer. Quelques situations typiques :
- La phase d'idée : un fond pour une invitation, une couverture d'article, une esquisse de personnage. Vous décrivez la scène que vous imaginez et comparez plusieurs propositions.
- Quelque chose qui n'existe pas : une scène impossible à photographier ou un lieu imaginaire.
- La découverte d'un style : écrire la même phrase en aquarelle, en dessin vectoriel ou en photo, et observer la différence.
La faiblesse du texte vers image vient de la même caractéristique : le modèle comble les vides lui-même. Si vous écrivez « une petite cuisine », vous ne choisissez pas la cuisine dessinée ; en ajoutant des détails, vous la précisez. Deux résultats issus du même prompt peuvent donc être très différents, et c'est normal.
A small kitchen with white tiles, a copper kettle on the stove, and a bowl of lemons on a wooden counter, soft morning light from a window on the left.
Quand partir d'une image ?
Lorsque vous avez un élément qui ne doit pas changer. Une vraie pièce, votre propre visage, un produit à vendre, une photo de famille : tenter de les décrire par le texte pour obtenir exactement la même chose n'est pas réaliste. Donner la photo est le moyen le plus direct de dire au modèle « prends cela comme référence ».
- Réaménager un lieu réel : donnez la photo de la pièce, et changez le mobilier ou les couleurs.
- Changer la lumière et l'ambiance : transformer une photo prise en plein jour en une scène du soir.
- Petites corrections : ajouter un objet, effacer une tache, réchauffer les couleurs.
- Changer de style : présenter la même photo sous forme de dessin.
Using the provided photo of my living room, keep the walls, windows and sofa exactly as they are. Change only the lighting to warm evening light and add two potted plants near the window.
Que conserve et que modifie chaque mode ?
| Caractéristique | Texte vers image | Image vers image |
|---|---|---|
| Point de départ | Votre description seule | La photo et votre description |
| Contrôle | Faible : le modèle comble les vides | Plus élevé : la composition et le contenu viennent de la photo |
| Diversité | Élevée : chaque essai peut être différent | Plus restreinte : le résultat reste autour de la photo |
| Conserver un élément réel | Impossible : le modèle le devine | Possible, mais des dérives peuvent apparaître |
| Usage idéal | Idée, esquisse, scène imaginaire | Retouche, cohérence, image personnelle |
La ligne « des dérives peuvent apparaître » est importante. L'image vers image n'est pas une garantie de conservation totale : le modèle peut redessiner l'expression d'un visage, les lettres d'un logo ou les doigts d'une main. C'est pourquoi il faut indiquer explicitement ce qui doit rester.
Le réglage de « force » et la phrase « garde le reste »
Certains outils proposent, en mode image vers image, un curseur de « force », de « fidélité » ou de « ressemblance ». Le principe est simple : avec une valeur basse, le résultat reste proche de la photo ; avec une valeur élevée, le prompt a davantage d'influence. Tous les outils n'en ont pas. Dans les modèles de retouche conversationnelle, comme les modèles d'image de Gemini décrits dans la documentation, c'est le prompt qui fait ce travail : une phrase du type « change uniquement ceci, le reste reste identique » remplit la même fonction. Un des exemples de la documentation demande d'ailleurs explicitement que les autres éléments ne soient pas modifiés.
Un bon prompt de retouche comporte donc deux parties :
- Ce qui change : « transforme le ciel en un coucher de soleil chaud ».
- Ce qui reste : « la personne, les vêtements et le cadrage restent identiques ».
Change only the sky to a warm sunset. Keep the person, clothing, framing and image sharpness exactly the same.
Comment utiliser les images de référence ?
L'image vers image ne se limite pas à une seule photo. Selon la documentation Gemini, les modèles acceptent jusqu'à 14 images de référence au total, réparties entre objets, personnages et styles ; le nombre exact dépend du modèle. Il faut donc consulter les limites de l'outil que vous utilisez.
Lorsque vous fournissez plusieurs images, le guide de BFL recommande de les citer dans l'ordre (« image 1 », « image 2 ») et d'indiquer le rôle de chacune. Sans rôle, le modèle devine lequel représente la personne, lequel représente le lieu.
Place the person from image 1 into the room from image 2. Keep the room's lighting and furniture; keep the person's face and clothing from image 1.
Comment combiner les deux modes ?
Le flux le plus efficace est souvent mixte. Commencez par produire quelques propositions en texte vers image, choisissez celle qui vous plaît, puis corrigez-la en image vers image. Vous trouvez ainsi l'idée rapidement, puis vous peaufinez le détail de façon contrôlée.
- Exploration : testez trois ou quatre directions en texte vers image.
- Choix : gardez la plus proche de ce que vous voulez, mettez les autres de côté.
- Correction : utilisez l'image retenue comme entrée et ne changez qu'une chose (la lumière, la couleur, un objet).
- Répétition : une seule modification par tour ; si le résultat dérive, revenez à la version précédente.
La documentation Gemini recommande aussi la conversation à plusieurs tours. Au lieu de demander cinq choses à la fois, demandez-en une à chaque tour.
Exemple concret : un salon
Supposons que vous vouliez réaménager votre salon. Vous avez une idée, mais vous avez aussi une photo.
Voie 1 : texte seul
A cozy living room with a green sofa, warm wooden floor, large plants near the window and soft evening light.
Le résultat peut être très beau, mais ce n'est pas votre salon : la place de la fenêtre, la couleur des murs et la forme du canapé diffèrent. C'est une bonne source d'inspiration, mais insuffisante pour décider.
Voie 2 : photo et texte
Using the provided photo, keep the room layout, walls and windows unchanged. Replace the sofa with a green one, add two large plants by the window, and make the light warmer.
Le résultat est un essai sur votre propre pièce : dimensions, perspective et fenêtre restent les mêmes. Il devient beaucoup plus utile pour décider.
À quoi s'attendre selon le mode ?
Ajustez vos attentes selon le mode. En texte vers image, obtenir exactement ce que vous imaginez dès le premier essai est rare ; trois ou quatre essais et des corrections du prompt sont courants. En image vers image, le résultat est en général proche de la source, mais de petites dérives apparaissent : l'expression d'un visage, les lettres d'un texte, les doigts d'une main. Dans les deux cas, comparez le résultat à la source ou à votre demande, côte à côte, pour repérer ce qui a bougé.
Erreurs fréquentes
- Tenter de décrire un élément réel par le texte : si vous voulez votre propre pièce ou produit, donnez la photo.
- Fournir une photo sans dire ce qui doit rester : le modèle peut changer le visage, le texte ou le cadrage.
- Demander plusieurs changements en un tour : avancez par étapes.
- Ne pas attribuer de rôle aux références : indiquez quelle image est la personne et laquelle est le lieu.
- Utiliser une photo de mauvaise qualité : une image floue ou sombre donne un résultat flou.
- Se fier à un seul résultat : essayez la même demande plusieurs fois.
En résumé
- Si vous avez une idée, partez du texte ; si vous voulez garder quelque chose, partez d'une photo.
- En image vers image, indiquez à la fois ce qui change et ce qui reste identique.
- Le nombre de références varie selon le modèle ; attribuez un rôle à chaque image.
- Explorez par texte, puis retouchez par image, avec une seule modification par tour.
- Comparez toujours le résultat à la source ou à votre demande.
Questions fréquentes
Quelle est la différence essentielle entre texte vers image et image vers image ?
En texte vers image, le modèle produit une image à partir de votre seule description. En image vers image, vous fournissez une photo et une instruction ; la photo sert de point de départ et l'instruction indique ce qu'il faut modifier.
Comment empêcher le visage de changer en image vers image ?
Précisez dans le prompt que le visage, les vêtements et le cadrage doivent rester identiques, et ne demandez qu'un changement à la fois. Ce n'est pas une garantie : comparez toujours le résultat à la photo d'origine.
Combien d'images de référence puis-je utiliser ?
Cela dépend du modèle. D'après la documentation Gemini, jusqu'à 14 images au total peuvent être acceptées, réparties entre objets, personnages et styles selon les limites propres à chaque modèle. Consultez la documentation de l'outil que vous utilisez.
Dois-je régler un curseur de force ?
Seulement si votre outil en propose un. Avec une valeur basse, le résultat reste proche de la photo ; avec une valeur élevée, le prompt a plus d'influence. Dans les modèles de retouche conversationnelle, une phrase « change uniquement ceci, le reste reste identique » fait un travail similaire.
Par quel mode commencer ?
Si votre idée n'est pas encore précise, explorez en texte vers image et retouchez le résultat retenu en image vers image. Si vous avez déjà une photo à conserver, partez directement de celle-ci.
Sources
Articles similaires
Photo
Photo de profil professionnelle avec l'IA : guide pour CV et LinkedIn
Une bonne photo de profil montre votre visage, sans vous faire paraître quelqu'un d'autre. Nous expliquons comment choisir la photo source, les prompts de lumière, de tenue et de fond, et les règles pour rester honnête.
8 min de lecture
Photo
Photo produit e-commerce sans studio : étapes avec l'IA
Un produit photographié proprement avec un téléphone peut être replacé dans différentes scènes grâce à l'IA. Nous expliquons la photo source, les prompts de mise en scène, la cohérence du catalogue et la règle de ne pas tromper l'acheteur.
8 min de lecture
Photo
Restaurer et coloriser de vieilles photos avec l'IA
Une bonne numérisation fait la moitié de la restauration par IA. Nous expliquons comment numériser une ancienne photo, ce que l'IA récupère ou invente, comment rester fidèle aux visages et comment étiqueter le résultat.
7 min de lecture