Guias
Como funciona a geração de imagens com IA? Introdução à difusão
A IA não recorta imagens prontas: ela começa com ruído aleatório e o limpa passo a passo. Explicamos a lógica da difusão, o lugar do prompt nesse processo e o que cada ajuste altera no resultado.
Equipe Zling AI10 min de leitura
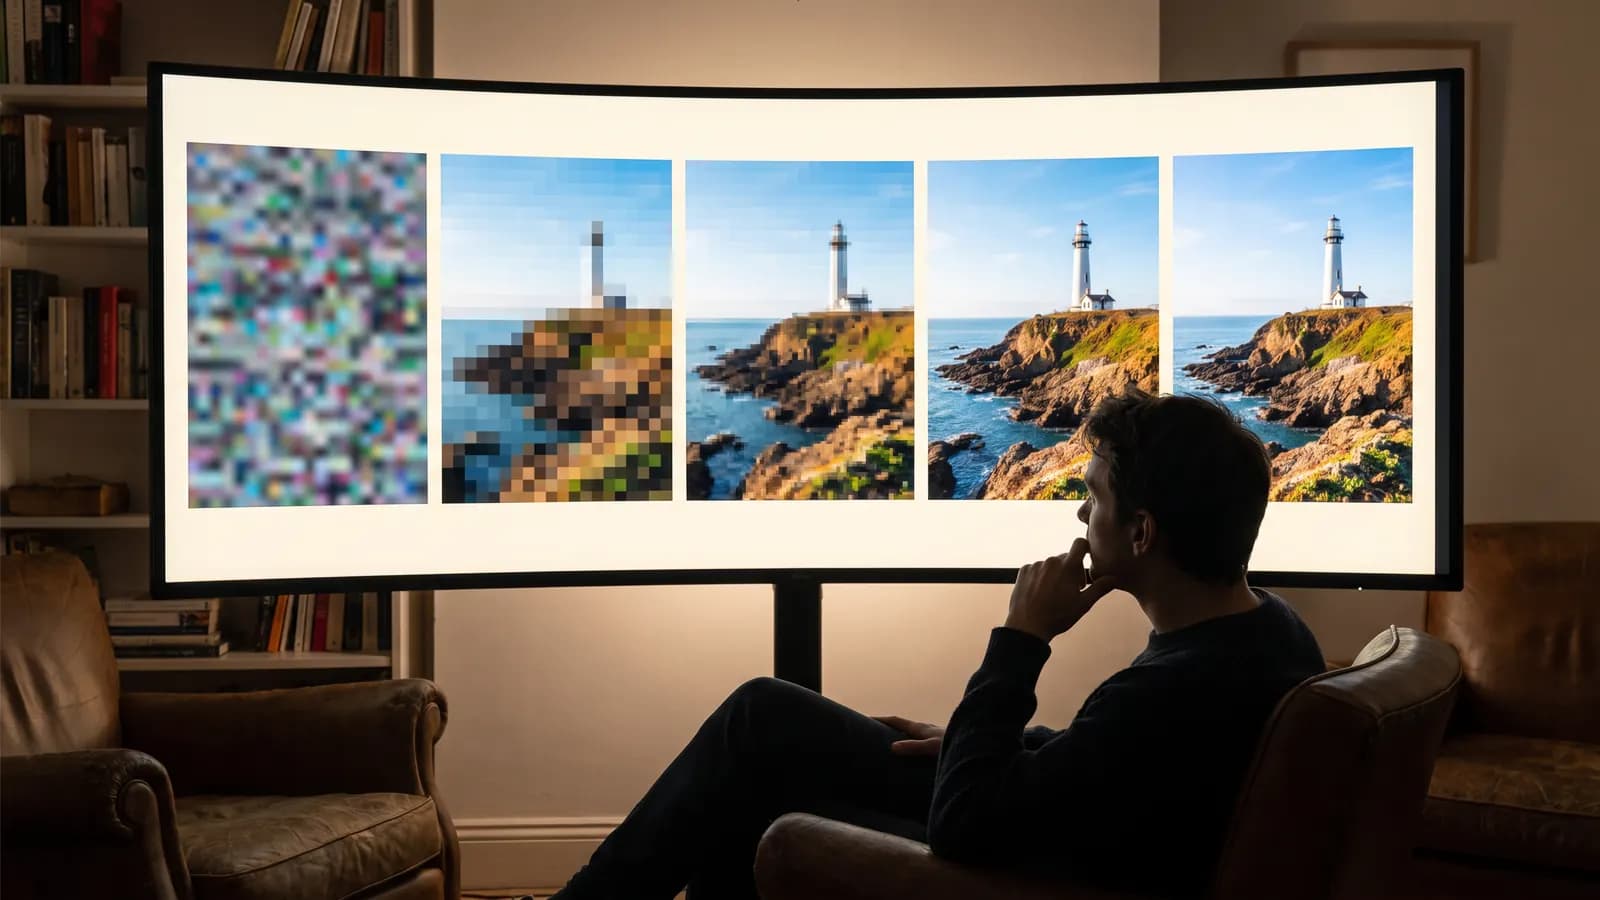
Resposta curta: a maioria dos modelos de imagem com IA atuais funciona por um método chamado difusão. O modelo começa com uma tela de “chuvisco”, feita de ruído aleatório, e, observando a frase que você escreveu, remove esse ruído em dezenas de passos; a cada passo, a imagem fica um pouco mais nítida. Neste texto, explicamos como o processo funciona, onde o prompt entra em cena e o que os ajustes realmente alteram, sem jargão.
Como a geração de imagens com IA funciona, em linhas gerais?
Um sistema que gera imagens a partir de texto é formado por três partes que trabalham juntas:
- Codificador de texto: transforma o seu prompt em uma representação numérica que o modelo consegue processar.
- Rede de remoção de ruído: observa uma imagem com ruído e estima qual é o ruído presente. É aqui que está a maior parte do trabalho.
- Decodificador: converte o resultado, produzido em um espaço comprimido, nos pixels que você vê na tela.
Durante a geração, a rede de remoção de ruído atua repetidas vezes sobre a mesma imagem. A cada rodada, ela consulta a informação do codificador de texto e aproxima a imagem do seu prompt. O resultado não é uma figura pronta retirada de um arquivo, mas uma imagem nova, calculada passo a passo.
O que é difusão? O caminho do ruído até a imagem
A ideia da difusão apareceu em 2015, com o artigo de Jascha Sohl-Dickstein e colegas: definir um processo que destrói, aos poucos, a estrutura dos dados e aprender a reverter esse processo. O método ganhou destaque pela qualidade visual em 2020, com o artigo Denoising Diffusion Probabilistic Models (DDPM), de Jonathan Ho, Ajay Jain e Pieter Abbeel.
Treinamento: aprender a estragar e a restaurar
No treinamento, o modelo recebe imagens reais, mas não em sua forma limpa. A cada imagem, é acrescentado ruído gaussiano aos poucos. No artigo DDPM, esse processo de degradação foi configurado com 1.000 passos; no último, o que resta da imagem é praticamente ruído puro. A tarefa do modelo é surpreendentemente simples: olhar uma imagem com ruído, em qualquer passo, e estimar o ruído que foi acrescentado. Ao repetir essa estimativa em muitos exemplos, o modelo aprende indiretamente como é uma imagem real.
Geração: começar do ruído puro
Ao gerar uma imagem, o processo acontece ao contrário. O modelo começa com ruído puro, estima o ruído que existe ali e remove parte dele. O resultado, um pouco mais organizado, serve de entrada para o passo seguinte. Nos primeiros passos, aparecem manchas grosseiras de cor e a composição; nos passos do meio, as formas se definem; nos últimos, surgem textura, bordas e luz. Pense em um escultor que primeiro marca as linhas gerais do bloco de pedra e só depois trabalha os detalhes finos.
O modelo não recorta e cola imagens de um banco de dados; durante o treinamento, ele aprende padrões gerais a partir dos exemplos e calcula uma imagem nova a cada geração. Ainda assim, pesquisadores mostraram que algumas imagens do conjunto de treinamento podem ser reproduzidas quase exatamente. Por isso, é uma boa prática evitar prompts que tentem imitar de forma literal uma obra conhecida ou uma pessoa.
Como o modelo entende a frase que você escreveu?
Enquanto o ruído é removido, o prompt determina em que direção a imagem vai. Para isso, o texto passa antes por um codificador de texto. Um dos marcos dessa área foi o CLIP, publicado em 2021: ele foi treinado com 400 milhões de pares de imagem e texto coletados da internet, aprendendo a prever qual descrição corresponde a qual imagem. Assim, palavras e conceitos visuais passaram a compartilhar um mesmo espaço numérico.
Uma pesquisa do Google, sobre o Imagen, trouxe um achado interessante: usar, como codificador de texto, um modelo de linguagem grande treinado apenas com texto (o T5) rende ótimos resultados; além disso, aumentar esse codificador traz mais qualidade e mais aderência ao texto do que aumentar a parte que gera a imagem. Essa é uma das razões pelas quais os modelos mais novos entendem melhor prompts longos e detalhados.
A ligação entre texto e imagem, na maioria dos modelos, é feita por camadas de atenção cruzada (cross-attention): em cada passo, cada região da imagem calcula a quais palavras do prompt deve “prestar atenção”. Quando você escreve “uma mulher com guarda-chuva vermelho”, é esse mecanismo que faz o vermelho ir para o guarda-chuva. A correspondência não é perfeita: uma cor ou uma característica que escorrega para o objeto errado é um erro comum por causa disso.
Por que não trabalhar diretamente com pixels? O espaço latente
Processar uma imagem pixel a pixel, em dezenas de passos, custa muito caro. O artigo Latent Diffusion Models, de Robin Rombach e equipe (CVPR 2022), popularizou a solução: primeiro, um codificador automático converte a imagem em uma representação muito menor e comprimida, chamada latente; a difusão trabalha sobre essa representação pequena; e, no final, um decodificador a transforma novamente em uma imagem de tamanho completo.
Um exemplo concreto: no fluxo do Stable Diffusion descrito na documentação da biblioteca diffusers, da Hugging Face, uma imagem de 512×512 pixels é processada como um latente de 64×64, reduzido 8 vezes em cada lado. Assim, a carga de cálculo cai de forma significativa. Boa parte dos modelos que você usa hoje é derivada dessa ideia.
Para que servem os ajustes além do prompt?
Muitos dos ajustes das telas de geração controlam diretamente uma parte do processo descrito acima. Nem todo modelo mostra todos eles, mas saber o que cada um faz ajuda a interpretar e corrigir o resultado.
| Ajuste | Parte do processo | Efeito prático |
|---|---|---|
| Seed (semente) | Ruído aleatório inicial | Com a mesma seed, prompt e ajustes, em geral se obtém o mesmo resultado ou um muito parecido |
| Número de passos | Quantidade de rodadas de remoção de ruído | Poucos passos deixam a imagem inacabada; a partir de certo ponto a diferença diminui e o tempo aumenta |
| Escala de guidance (CFG) | Peso do prompt em cada passo | Quanto maior, mais o resultado segue o prompt, mas a variedade diminui; valores exagerados podem deixar a imagem artificial |
| Prompt negativo | Conceitos dos quais o modelo deve se afastar | Ajuda a reduzir características indesejadas, como “desfocado” ou “pouco detalhe” |
| Força (strength) | Quantidade de ruído acrescentada à foto na geração de imagem a partir de imagem | Valor baixo mantém a fidelidade à foto; valor alto permite interpretações mais livres |
| Proporção | Tamanho do ruído inicial | Define a composição; o enquadramento vertical combina com retratos e o horizontal com paisagens |
Por que existe a escala de guidance?
O trabalho de Jonathan Ho e Tim Salimans, Classifier-Free Diffusion Guidance, definiu o método usado em muitos modelos atuais. Durante o treinamento, o prompt é deixado vazio de tempos em tempos; assim, o mesmo modelo aprende a prever tanto com prompt quanto sem ele. Na geração, a diferença entre as duas previsões é amplificada, e a imagem é empurrada na direção do prompt. O próprio artigo mostra por que esse ajuste é um equilíbrio: quanto maior o guidance, mais fiel é cada imagem ao prompt, mas a variedade diminui. O artigo do Imagen também observa que valores de guidance muito altos podem gerar imagens supersaturadas e pouco naturais.
Por que a seed produz o mesmo resultado?
A seed é o valor inicial do gerador de números aleatórios que cria o ruído de partida. A mesma seed gera o mesmo ruído, e o mesmo ruído, com o mesmo prompt e os mesmos ajustes, percorre o mesmo caminho. Por isso, fixar a seed e trocar uma única palavra do prompt é a forma mais limpa de ver o efeito dessa palavra. Um detalhe: como indica a documentação do diffusers, a mesma seed não garante um resultado idêntico em outro hardware ou em outra versão do software.
Como a geração a partir de uma foto (image-to-image) funciona?
Quando você envia uma foto e pede “transforme isto em uma pintura em aquarela”, o processo não começa do ruído puro. A própria foto é convertida para o espaço latente, acrescenta-se uma quantidade de ruído e a remoção de ruído começa a partir dessa versão parcialmente degradada. A ideia foi definida em 2021, no artigo SDEdit: quanto mais ruído é acrescentado, mais livre é o resultado; quanto menos, mais fiel à foto ele fica.
A documentação do diffusers ilustra isso com números: em uma configuração de 50 passos, com força de 0,8, são acrescentados 40 passos de ruído à foto, e a remoção ocorre ao longo de 40 passos. Quando a força se aproxima de 1,0, a foto é quase totalmente ignorada. Se você quer preservar o rosto, a roupa ou o produto, comece com uma força baixa ou média; se quer mudar a cena por completo, aumente a força.
O que mudou nos modelos mais novos?
A ideia central continua a mesma, mas a arquitetura muda rapidamente:
- Espinha dorsal com transformer: os primeiros modelos usavam uma rede convolucional chamada U-Net. O trabalho Diffusion Transformers (DiT), de William Peebles e Saining Xie, mostrou que um transformer que opera sobre partes do latente melhora de forma consistente com mais capacidade de cálculo.
- Rectified flow: o artigo de 2024 de Patrick Esser e equipe testou em larga escala a abordagem de rectified flow, que liga o ruído aos dados por uma linha reta. Segundo os autores, arquiteturas de transformer com pesos separados para texto e imagem melhoraram a compreensão do prompt e a escrita dentro da imagem (tipografia).
- Menos passos: métodos de amostragem como o DDIM permitiram obter amostras de 10 a 50 vezes mais rápidas com o mesmo modelo, sem treiná-lo de novo. Eles são um dos antecedentes dos métodos que buscam bons resultados com poucos passos.
- Abordagens que não são difusão: nem todo modelo de imagem usa difusão. A OpenAI explicou que a geração de imagens integrada ao GPT-4o é um modelo autorregressivo, diferente do DALL·E, que é um modelo de difusão.
Como esse conhecimento ajuda a escrever prompts?
Entender a lógica da difusão ajuda a montar o prompt com mais intenção. Como o modelo define a composição nos primeiros passos e o detalhe nos últimos, o prompt deve descrever tanto o conjunto quanto os detalhes. Você pode seguir esta ordem:
- Assunto: o que você quer ver? Escolha um elemento principal.
- Ambiente e luz: onde, em que hora do dia, com que tipo de luz?
- Enquadramento: primeiro plano, plano aberto ou vista de cima?
- Estilo: fotografia, aquarela, modelagem 3D, filme antigo...
- Detalhe: paleta de cores, textura, material.
Um prompt fraco:
um café bonito
Um prompt mais forte:
Um pequeno café de bairro sob a luz da manhã, uma xícara de chá fumegante junto à janela, mesa de madeira, tons quentes, lente grande angular, estilo de fotografia documental
No segundo prompt, o espaço que o modelo precisa preencher é menor: luz, enquadramento e estilo estão definidos, então a orientação empurra sempre na mesma direção a cada passo. Se o resultado não agradar, fixe a seed e mude uma coisa de cada vez: primeiro a luz e depois o enquadramento. Assim, você descobre qual palavra causou cada mudança.
Erros comuns
- Pedidos contraditórios: expressões como “simples, mas com muitíssimos detalhes” puxam o modelo para duas direções.
- Listas longas separadas por vírgulas: palavras pouco importantes diluem as que pesam mais; escreva primeiro a ideia principal.
- Colocar a negação no prompt principal: muitos modelos entendem mal frases negativas, e “sem chapéu” pode trazer o chapéu para a imagem. Se o modelo aceitar, use o prompt negativo.
- Mudar tudo em cada tentativa: comparações feitas sem fixar a seed e os ajustes enganam.
- Esperar perfeição em textos dentro da imagem: os modelos novos escrevem muito melhor, mas textos longos ainda podem ter erros de letra. Se precisar de texto na imagem, mantenha-o curto.
Resumo
- A maioria dos modelos de imagem com IA usa difusão: começa com ruído puro e o limpa passo a passo.
- No treinamento, o modelo aprende a estimar o ruído; em cada geração, calcula uma imagem nova.
- O prompt, por meio do codificador de texto, orienta a remoção de ruído em cada passo.
- O espaço latente torna o cálculo viável, e o resultado final é decodificado em pixels.
- A seed controla o ruído inicial, o guidance controla o peso do prompt e a força controla o quanto a foto original é preservada.
- Para um bom resultado, descreva com clareza o assunto, a luz, o enquadramento e o estilo, e mude uma coisa de cada vez.
Perguntas frequentes
Os modelos de IA para imagens copiam fotos da internet?
Em geral, não: o modelo aprende padrões a partir dos exemplos e calcula uma imagem nova a cada geração. Ainda assim, pesquisadores mostraram que algumas imagens do conjunto de treinamento (entre elas fotos de pessoas e logotipos, em mais de mil exemplos) podem ser reproduzidas quase exatamente. Por isso, evite prompts que imitem de forma literal obras ou pessoas conhecidas.
Por que o mesmo prompt gera imagens diferentes a cada vez?
Porque cada geração começa com um ruído aleatório diferente. Se você fixar a seed, o ruído inicial fica igual e, com os mesmos ajustes, em geral obtém um resultado igual ou muito parecido; em outro hardware ou versão de software, pequenas diferenças ainda podem aparecer.
Aumentar o número de passos sempre melhora a imagem?
Não. Poucos passos deixam a imagem inacabada, mas a partir de certo ponto os passos extras quase não mudam o resultado e apenas aumentam o tempo. Métodos como o DDIM foram criados justamente para obter bons resultados com menos passos.
Devo aumentar a escala de guidance (CFG) ao máximo?
Em geral, não. Valores altos prendem mais o resultado ao prompt, mas reduzem a variedade; valores muito altos podem gerar imagens supersaturadas e de aparência artificial. Comece com o valor padrão do modelo e altere em pequenos passos.
Como evitar que o rosto mude ao gerar uma imagem a partir de uma foto?
Use um valor baixo para a força (strength), que define a quantidade de ruído acrescentada à foto, e descreva no prompt apenas o que deve mudar. Quanto maior a força, mais livre é a interpretação do modelo, e os traços do rosto podem mudar.
Fontes
- Sohl-Dickstein et al. (2015), Deep Unsupervised Learning using Nonequilibrium Thermodynamics
- Ho, Jain, Abbeel (2020), Denoising Diffusion Probabilistic Models
- Song, Meng, Ermon (2020), Denoising Diffusion Implicit Models
- Radford et al. (2021), Learning Transferable Visual Models From Natural Language Supervision (CLIP)
- Meng et al. (2021), SDEdit: Guided Image Synthesis and Editing with Stochastic Differential Equations
- Rombach et al. (2022), High-Resolution Image Synthesis with Latent Diffusion Models
- Saharia et al. (2022), Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding (Imagen)
- Ho, Salimans (2022), Classifier-Free Diffusion Guidance
- Peebles, Xie (2022), Scalable Diffusion Models with Transformers
- Carlini et al. (2023), Extracting Training Data from Diffusion Models
- Esser et al. (2024), Scaling Rectified Flow Transformers for High-Resolution Image Synthesis
- OpenAI (2025), Addendum to GPT-4o System Card: Native image generation
- Hugging Face Diffusers: Understanding pipelines, models and schedulers
- Hugging Face Diffusers: Image-to-image
- Hugging Face Diffusers: Reproducibility
Posts relacionados
Guias
Como funciona a geração de vídeo com IA? A ideia por trás do movimento
Um modelo de vídeo com IA não desenha os quadros um a um; ele constrói o movimento como um todo. Explicamos como a difusão se estendeu ao tempo, por que os clipes são curtos e a diferença entre a entrada de texto e a de foto.
8 min de leitura
Guias
Custo de geração com IA: como funcionam tokens e créditos
As ferramentas de IA cobram a geração em tokens ou créditos porque cada criação é um cálculo real. O custo depende de resolução, duração e modelo; reunimos também formas de gastar menos.
8 min de leitura
Guias
Navegador ou app? O que observar ao escolher uma ferramenta de IA
O navegador é mais confortável para trabalhos detalhados em tela grande; o aplicativo, para criações rápidas pelo celular. Explicamos as diferenças de tela, envio, privacidade, pagamento, notificações e uso offline.
7 min de leitura