Guias
Como funciona a geração de vídeo com IA? A ideia por trás do movimento
Um modelo de vídeo com IA não desenha os quadros um a um; ele constrói o movimento como um todo. Explicamos como a difusão se estendeu ao tempo, por que os clipes são curtos e a diferença entre a entrada de texto e a de foto.
Equipe Zling AI8 min de leitura
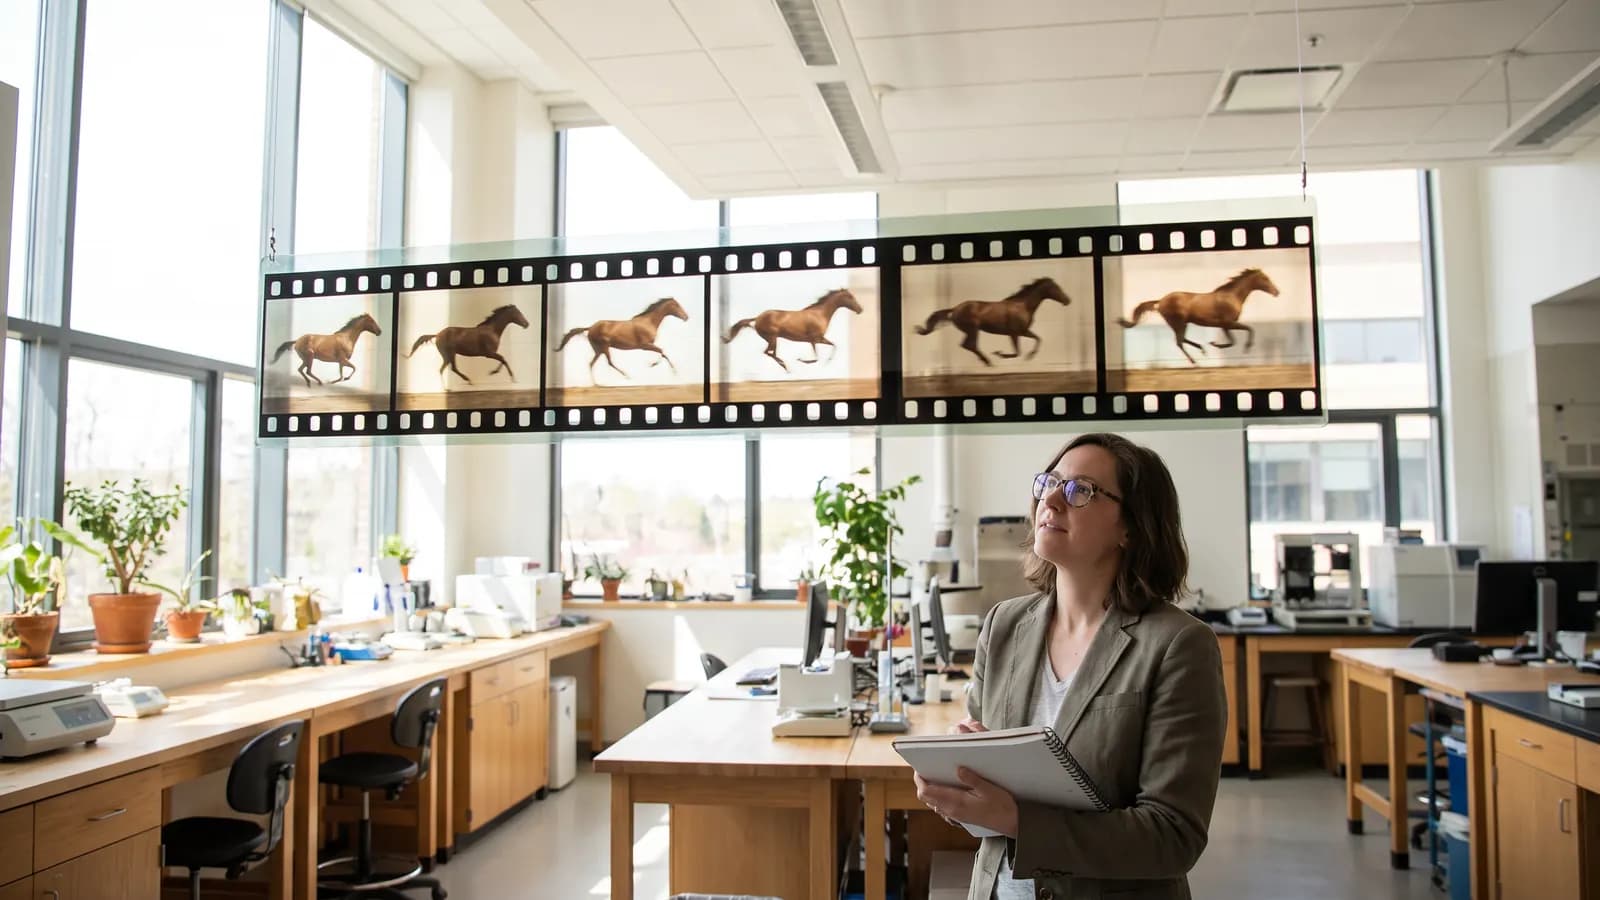
Resposta curta: um modelo de vídeo com IA não desenha o vídeo quadro a quadro, como imagens separadas; ele gera os quadros em conjunto, levando em conta o movimento e o tempo ao mesmo tempo. A base é a mesma ideia de difusão usada na geração de imagens, mas o dado já não é uma imagem, e sim uma sequência de quadros espalhada no tempo. Neste texto, explicamos como isso é feito, por que os clipes são curtos e qual é a diferença entre a entrada de texto e a entrada de foto, com base no que dizem os artigos e relatórios técnicos sobre o tema.
O que é um vídeo para o modelo?
Um vídeo é uma sequência de quadros exibidos um após o outro, em uma quantidade fixa por segundo. Para o modelo, isso é um bloco de dados com altura, largura e um eixo de tempo. Para uma introdução simples à geração de imagens, veja o nosso texto Como funciona a geração de imagens com IA?; a lógica de começar com ruído e limpá-lo passo a passo também vale aqui. A diferença é que o que se limpa não é um único quadro, e sim um bloco que inclui a relação entre os quadros.
Como a difusão foi estendida ao tempo?
O artigo de Ho e colegas sobre difusão de vídeo apresenta a abordagem como uma extensão natural da arquitetura de difusão para imagens. Ele destaca dois pontos: treinar o modelo com imagens e vídeos ao mesmo tempo acelera o treinamento e reduz a variabilidade do gradiente; além disso, um novo método de amostragem condicional permite estender o vídeo tanto no espaço quanto no tempo. O mesmo artigo relata os primeiros resultados de geração de vídeo a partir de texto em larga escala.
Já o Imagen Video organiza o processo em uma cadeia, em vez de um único modelo gigante. Primeiro, um modelo base gera um vídeo de baixa resolução; depois, modelos de super-resolução espacial (que nitidez os quadros) e temporal (que deixam o movimento mais fluido) ampliam o resultado em etapas alternadas. Assim, resolução e fluidez são resolvidas em estágios separados.
Modelos mais recentes: patches de espaço-tempo
O relatório técnico do Sora, da OpenAI, resume uma ideia comum a muitos sistemas atuais: modelos de difusão condicionados por texto são treinados com vídeos e imagens de diferentes durações, resoluções e proporções; o modelo é um transformer que opera sobre patches de espaço-tempo extraídos de códigos latentes de vídeos e imagens. Primeiro, uma rede de compressão reduz o vídeo a um espaço latente pequeno; os patches cortados desse espaço funcionam como “tokens” para o transformer. No final, um decodificador converte os códigos latentes de volta em pixels. O relatório afirma que o maior modelo consegue gerar cerca de um minuto de vídeo. Ele apresenta resultados qualitativos e não detalha a arquitetura do modelo.
O artigo Movie Gen, da Meta, segue uma linha parecida: o maior modelo de vídeo é um transformer de 30 bilhões de parâmetros, que gera vídeo em HD 1080p com som sincronizado. Além disso, pode criar vídeos personalizados a partir da foto de um usuário e fazer edições guiadas por instruções.
O que é consistência temporal e por que é difícil?
Consistência significa que o rosto, a roupa e o cenário de um personagem permanecem os mesmos ao longo dos quadros, e que o movimento parece fisicamente plausível. Se você gerasse cada quadro de forma independente, surgiriam pequenas diferenças em cada um, e o vídeo tremeria. A principal razão para os modelos processarem os quadros em conjunto é justamente essa: cada quadro é produzido “vendo” o que os quadros vizinhos contêm.
Mesmo assim, a consistência não é garantida. Em movimentos longos ou complexos, o número de dedos de uma mão pode mudar, objetos podem desaparecer ou um objeto pode se transformar em outro. Isso acontece porque o modelo não conhece as leis da física: ele aprende padrões dos dados de treinamento, o que, na melhor das hipóteses, é uma previsão muito boa.
Por que os clipes de IA são curtos?
As fontes oficiais não trazem uma explicação de uma frase só, mas os números dão uma pista. O artigo Movie Gen informa que o contexto do modelo é de no máximo 73 mil tokens de vídeo, o que, com 16 quadros por segundo, equivale a cerca de 16 segundos. A página do Veo, do Google, na comparação entre modelos, indica que os vídeos do Veo têm 8 segundos. Como informação geral, cada segundo a mais aumenta o número de tokens a processar e o custo de memória e de cálculo; no mecanismo de atenção, o custo cresce rapidamente à medida que a sequência se alonga. Além disso, os erros se acumulam: um rosto correto no primeiro segundo pode ir se desviando depois de dez segundos.
Uma solução comum para cenas mais longas é continuar o clipe existente. A amostragem condicional de Ho e colegas oferece a base acadêmica para estender um vídeo no tempo, condicionando a geração à parte anterior; a página do Veo também informa que os clipes podem ser estendidos com o recurso de extensão de cena. Na prática, isso significa gerar alguns clipes curtos em sequência e montá-los.
Diferença entre texto para vídeo e foto para vídeo
| Entrada | O que o modelo faz | Ponto forte | Atenção |
|---|---|---|---|
| Somente texto | Constrói a cena, a pessoa e o movimento do zero | Liberdade criativa | Composição e personagem são difíceis de prever |
| Foto (+ texto) | Usa o quadro enviado como início e acrescenta o movimento | A aparência se mantém; mais controle | Partes fora da foto são inventadas pelo modelo |
| Primeiro e último quadro | Gera a transição entre os dois quadros | Você define início e fim | Nem todo modelo oferece |
O artigo Stable Video Diffusion afirma que o modelo base aprende uma representação forte de movimento e que ela pode ser adaptada a tarefas derivadas, como a foto para vídeo. A página do Veo, por sua vez, lista, além do texto para vídeo, a foto para vídeo, o primeiro e o último quadro e imagens de referência como entradas. Ou seja, a foto define “como deve aparecer”, e o texto define “o que deve acontecer”.
Por que os dados de treinamento são tão importantes?
O artigo Stable Video Diffusion descreve três etapas para treinar um modelo de vídeo: pré-treinamento com texto e imagem, pré-treinamento com vídeo e ajuste fino com vídeos de alta qualidade. Os autores afirmam que um bom modelo depende de um conjunto de pré-treinamento bem selecionado, e que legendagem automática e filtragem fazem parte desse processo. Em resumo: o que o modelo faz bem depende do tipo de movimento que ele viu. Em movimentos raros ou cenas pouco comuns, a qualidade cai.
O que você pode fazer para melhorar o resultado?
- Peça um único movimento: em vez de “a mulher gira, sorri, acena e se afasta”, escolha uma ação.
- Nomeie a câmera: plano fixo, aproximação lenta, acompanhamento lateral.
- Forneça o quadro inicial: se a consistência for importante, experimente o modo de foto para vídeo.
- Gere curto e depois una: clipes controlados em vez de um pedido longo.
- Faça várias tentativas: o mesmo pedido gera resultados diferentes.
Exemplo de pedido: Câmera fixa, uma mulher de casaco vermelho caminhando em uma praia ao entardecer, o cabelo balançando levemente com a brisa, ritmo lento e natural.
Som e movimento de câmera entram em jogo como?
Alguns modelos geram também o som, não apenas a imagem. O artigo Movie Gen afirma que, além do vídeo HD 1080p, o modelo produz áudio sincronizado; a página do Veo informa que o som é gerado nativamente e que é possível incluir efeitos sonoros, sons ambientes e diálogos. Como o som é planejado junto com a imagem, o movimento dos lábios e o momento do acontecimento ficam mais fáceis de alinhar do que quando se acrescenta um áudio separado. A própria página, porém, deixa claro que a fala consistente ainda é uma área em desenvolvimento.
No caso do movimento de câmera, o artigo Stable Video Diffusion traz um detalhe interessante: o modelo base pode ser adaptado a movimentos específicos da câmera por meio de pequenos módulos LoRA treinados para isso. Ou seja, movimentos como “aproximação lenta” ou “deslizamento lateral” são uma habilidade separada que o modelo pode aprender. Por isso, nomear a câmera no pedido ajuda a ativar essa habilidade.
Erros comuns
- Colocar muitas ações em um único pedido: o modelo mistura ou deixa de lado alguns movimentos.
- Não especificar a câmera: o modelo escolhe um enquadramento aleatório.
- Esperar física perfeita: observe o resultado quadro a quadro.
- Pedir um clipe longo de uma vez: quanto maior a duração, menor a consistência.
- Tratar a fala como garantida: a página do Veo indica que a fala consistente, sobretudo em trechos curtos, ainda está em evolução.
- Apresentar a geração como real ou publicar sem identificação: alguns sistemas, como o Veo, marcam o conteúdo com SynthID; ao publicar, indique você mesmo que o vídeo é feito com IA.
Resumo
- Modelos de vídeo geram os quadros em conjunto, considerando o tempo; em geral, combinam difusão com transformers.
- A consistência entre quadros é um objetivo, não uma garantia.
- A limitação de duração vem do custo de cálculo e do acúmulo de erros; cenas longas são montadas com clipes encadeados ou estendidos.
- O texto define o que acontece, a foto define como a cena aparece, e o primeiro e último quadro conectam os dois.
- Um único movimento, uma câmera nomeada e algumas tentativas costumam trazer o melhor resultado.
Perguntas frequentes
Um modelo de vídeo com IA desenha cada quadro como uma imagem separada?
Não. O artigo de difusão de vídeo apresenta a abordagem como uma extensão da difusão de imagens, processando os quadros em conjunto. Assim, busca-se consistência entre os quadros, mas ela não é garantida.
Por que os vídeos costumam ter poucos segundos?
As fontes oficiais não dão uma única razão. O artigo Movie Gen informa que o contexto do modelo é limitado a 73 mil tokens de vídeo, o equivalente a cerca de 16 segundos, e a página do Veo indica que os vídeos do Veo têm 8 segundos. Em geral, quanto mais longo o vídeo, maiores o custo de cálculo e o acúmulo de erros.
Como obter um vídeo mais longo?
O caminho mais comum é continuar o clipe existente ou gerar vários clipes curtos em sequência e montá-los. A página do Veo informa que os clipes podem ser estendidos com o recurso de extensão de cena.
Foto para vídeo ou texto para vídeo: qual é melhor?
Se a aparência precisa se manter, a foto para vídeo costuma ser mais controlada, porque você define o quadro inicial. Se quer uma cena livre, o texto para vídeo basta.
Posso afirmar que todos os sistemas funcionam como o modelo descrito no relatório do Sora?
Não. O relatório descreve um método e resultados qualitativos, sem detalhar o modelo. A abordagem com transformer sobre patches de espaço-tempo é comum, mas o funcionamento interno de cada sistema não é o mesmo.
Fontes
- Ho ve ark.: Video Diffusion Models (arXiv:2204.03458)
- Ho ve ark.: Imagen Video: High Definition Video Generation with Diffusion Models
- Blattmann ve ark.: Stable Video Diffusion (arXiv:2311.15127)
- Meta: Movie Gen: A Cast of Media Foundation Models (arXiv:2410.13720)
- OpenAI: Video generation models as world simulators
- Google DeepMind: Veo
Posts relacionados
Guias
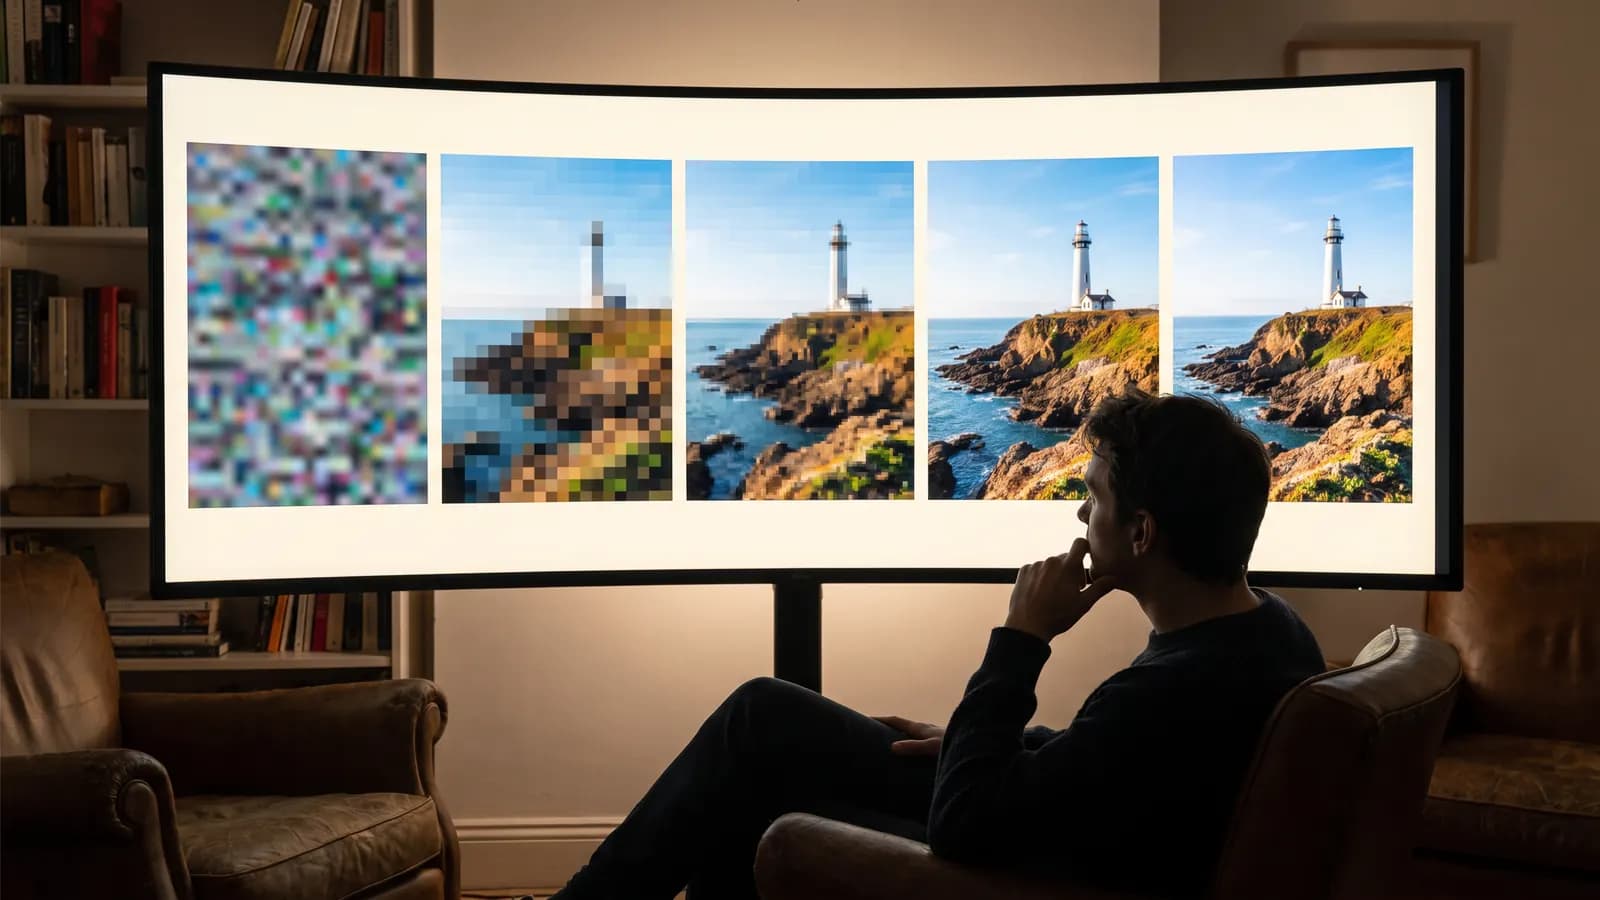
Como funciona a geração de imagens com IA? Introdução à difusão
A IA não recorta imagens prontas: ela começa com ruído aleatório e o limpa passo a passo. Explicamos a lógica da difusão, o lugar do prompt nesse processo e o que cada ajuste altera no resultado.
10 min de leitura
Guias
Custo de geração com IA: como funcionam tokens e créditos
As ferramentas de IA cobram a geração em tokens ou créditos porque cada criação é um cálculo real. O custo depende de resolução, duração e modelo; reunimos também formas de gastar menos.
8 min de leitura
Guias
Navegador ou app? O que observar ao escolher uma ferramenta de IA
O navegador é mais confortável para trabalhos detalhados em tela grande; o aplicativo, para criações rápidas pelo celular. Explicamos as diferenças de tela, envio, privacidade, pagamento, notificações e uso offline.
7 min de leitura