Руководства
Как работает генерация изображений AI: простое введение в диффузию
ИИ не вырезает картинки из архива: он начинает со случайного шума и шаг за шагом его очищает. Объясняем логику диффузии, место промпта в этом процессе и то, что меняют настройки.
Команда Zling AI8 мин чтения
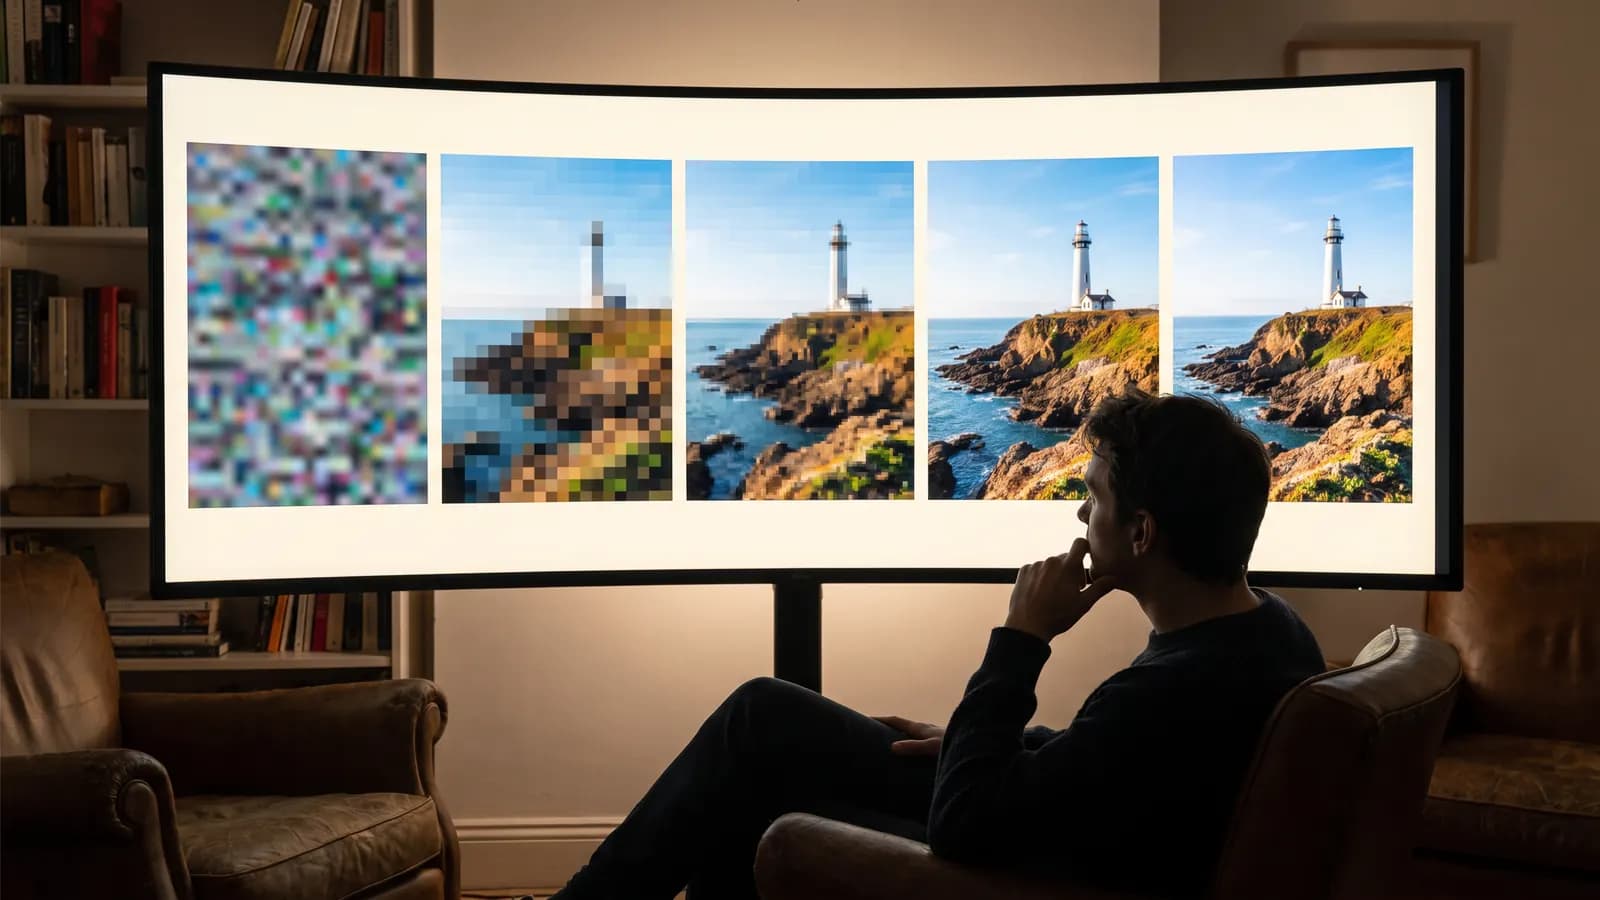
Короткий ответ: большинство современных моделей генерации изображений работают методом, который называется диффузией. Модель начинает с «снега» из случайного шума и, глядя на фразу, которую вы написали, очищает этот шум за десятки шагов; на каждом шаге картинка становится немного четче. В этой статье мы объясняем процесс без лишнего жаргона: как он идет, где в нем участвует промпт и что на самом деле меняют настройки.
Как в общих чертах работает генерация изображений?
Система, которая создает картинку по тексту, состоит из трех взаимодействующих частей:
- Текстовый кодировщик: превращает ваш промпт в числовое представление, с которым может работать модель.
- Сеть для удаления шума: смотрит на зашумленное изображение и предсказывает шум, который в нем есть. Основная нагрузка приходится на нее.
- Декодер: переводит результат, полученный в сжатом пространстве, в пиксели, которые вы видите на экране.
Во время генерации сеть для удаления шума много раз работает с одним и тем же изображением. На каждом шаге она опирается на информацию от текстового кодировщика и подталкивает картинку ближе к вашему промпту. Итог - не готовый снимок из архива, а новое изображение, которое вычисляется шаг за шагом.
Что такое диффузия? Путь от шума к картинке
Идея диффузии появилась в 2015 году в статье Яши Зол-Дикштейна и его коллег: сначала описать процесс, который постепенно разрушает структуру данных, а затем научиться обращать его. Качественно это направление выделилось в 2020 году благодаря работе Джонатана Хо, Аджая Джейна и Пьера Аббеля Denoising Diffusion Probabilistic Models (DDPM).
Обучение: как научиться портить и восстанавливать
При обучении модели показывают настоящие изображения, но не в чистом виде. К каждому изображению небольшими шагами добавляют случайный (гауссов) шум. В статье DDPM этот процесс порчи был задан из 1000 шагов; к последнему шагу от изображения почти ничего не остается, кроме чистого шума. Задача модели удивительно проста: посмотреть на зашумленное изображение на любом шаге и предсказать шум, который в него добавили. Повторяя это на огромном количестве примеров, модель косвенно узнает, как выглядят настоящие изображения.
Генерация: начало с чистого шума
При создании картинки процесс идет в обратном порядке. Модель начинает с чистого шума, предсказывает его и убирает часть. Получившееся, немного более упорядоченное изображение становится входом для следующего шага. В первых шагах появляются грубые цветовые пятна и композиция; в средних - формируются очертания; в последних - проявляются тонкие детали: фактура, края, свет. Представьте скульптора, который сначала намечает общие формы, а потом прорабатывает мелкие детали.
Модель не вырезает картинки из базы данных и не склеивает их. Из примеров, которые она видела при обучении, она усваивает общие закономерности и при каждой генерации вычисляет новое изображение. Тем не менее исследователи показали, что некоторые изображения из обучающих данных могут быть воспроизведены почти дословно. Поэтому полезно избегать промптов, которые копируют узнаваемое произведение или конкретного человека.
Как модель понимает фразу, которую вы написали?
Направление, в котором идет очистка шума, задает промпт. Для этого текст сначала проходит через текстовый кодировщик. Один из важных шагов в этой области - CLIP, опубликованный в 2021 году: его обучили на 400 миллионах пар «изображение - текст», собранных из интернета, так, чтобы он предсказывал, какое описание относится к какой картинке. Благодаря этому слова и визуальные понятия оказались в одном числовом пространстве.
В работе Google над Imagen был интересный вывод: использование в качестве текстового кодировщика большой языковой модели, обученной только на тексте (T5), дает очень хорошие результаты; а увеличение этого кодировщика дает больше качества и лучшее соответствие текста и изображения, чем увеличение части, которая создает картинку. Это одна из причин, почему новые модели лучше понимают длинные и подробные промпты.
Связь текста и изображения во многих моделях устанавливается через слои перекрестного внимания (cross-attention): каждый участок изображения на каждом шаге вычисляет, на какие слова промпта ему «смотреть». Когда вы пишете «женщина с красным зонтом», то, что красный цвет попадает именно на зонт, - заслуга этого сопоставления. Оно не идеально: иногда цвет или свойство «перескакивает» на другой объект, и это тоже видно в результатах.
Почему не работать напрямую с пикселями? Латентное пространство
Обрабатывать изображение пиксель за пикселем на десятках шагов очень дорого. Статья Robin Rombach и его коллег Latent Diffusion Models (CVPR 2022) популяризовала подход, который решает эту проблему: сначала автокодировщик переводит изображение в гораздо меньшее сжатое представление (латент); диффузия работает с этим маленьким представлением; в конце декодер снова разворачивает результат в изображение полного размера.
Конкретный пример: в описанной в документации diffusers схеме Stable Diffusion изображение 512×512 пикселей обрабатывается как латент 64×64, то есть каждая сторона уменьшена в 8 раз. Вычислительная нагрузка благодаря этому резко снижается. Большинство моделей, которыми вы пользуетесь сегодня, опираются на развитие этой идеи.
Что делают настройки кроме промпта?
Большинство настроек на экранах генерации напрямую управляют частью этого процесса. Не каждая модель показывает все из них, но понимать, что они делают, помогает читать результат и исправлять его.
| Настройка | Какая часть процесса | Практический эффект |
|---|---|---|
| Seed (зерно) | Начальный случайный шум | При одинаковых seed, промпте и настройках обычно получается тот же или очень похожий результат |
| Число шагов | Количество проходов по удалению шума | Слишком мало шагов дает недоработанное изображение; после определенного предела разница уменьшается, а время растет |
| Масштаб руководства (CFG) | Вес промпта на каждом шаге | С ростом значения результат строже следует промпту, разнообразие снижается; чрезмерные значения дают искусственный вид |
| Негативный промпт | Понятия, от которых модель должна уйти | Помогает уменьшить нежелательные черты вроде «размытости» или «мало деталей» |
| Сила (strength) | Объем шума, добавляемого к фото при генерации по изображению | Низкое значение сохраняет близость к фото, высокое дает больше свободы в интерпретации |
| Соотношение сторон | Размер начального шума | Определяет композицию: вертикальный кадр подходит для портрета, горизонтальный - для пейзажа |
Зачем нужен масштаб руководства?
Статья Джонатана Хо и Тима Салимана Classifier-Free Diffusion Guidance описала метод, который сегодня используют многие модели. Во время обучения промпт иногда намеренно оставляют пустым; так одна и та же модель учится предсказывать и с промптом, и без него. При генерации разницу между этими двумя предсказаниями усиливают, и изображение подталкивается к промпту. Статья показывает, почему эта настройка - компромисс: с ростом руководства точность соответствия отдельным изображениям растет, а разнообразие падает. В статье Imagen также отмечается, что слишком высокие значения могут давать пересыщенные и неестественные изображения.
Почему seed дает тот же результат?
Seed - это начальное значение генератора случайных чисел, который создает стартовый шум. Одинаковый seed дает одинаковый шум, а одинаковый шум с тем же промптом и настройками проходит тот же путь. Поэтому, зафиксировав seed и меняя в промпте лишь одно слово, вы хорошо видите, что именно это слово изменило. Небольшое уточнение: как сказано в документации diffusers, одинаковый seed не гарантирует абсолютно идентичного результата на другом оборудовании или в другой версии программного обеспечения.
Как работает генерация по фотографии (image-to-image)?
Если вы загружаете фото и просите «превратить это в акварель», процесс начинается не с чистого шума. Фотография сначала переводится в латентное пространство, к ней добавляется некоторое количество шума, и очистка начинается уже с этого частично испорченного состояния. Эту идею описала статья SDEdit в 2021 году: чем больше добавлено шума, тем свободнее результат; чем меньше, тем он ближе к фото.
Пример из документации diffusers показывает это в числах: при 50 шагах и силе 0,8 к фото добавляется 40 шагов шума, а затем они убираются. При приближении силы к 1,0 фото почти полностью игнорируется. Если нужно сохранить лицо, одежду или товар, начните с низкой или средней силы; если хотите полностью переосмыслить сцену, увеличьте ее.
Что изменилось в новых моделях?
Основная идея осталась прежней, но архитектура быстро меняется:
- Основа на трансформере: ранние модели использовали свёрточную сеть U-Net. Работа Уильяма Пиблса и Сайнина Се о Diffusion Transformers (DiT) показала, что трансформер, работающий с латентными фрагментами, стабильно улучшается при увеличении вычислительной мощности.
- Rectified flow: статья Патрика Эссера и его команды (2024) в большом масштабе испытала подход «выпрямленного потока», который соединяет шум и данные прямой линией. Авторы сообщают, что трансформеры с отдельными весами для текста и изображения улучшили понимание промпта и написание текста внутри изображения (типографику).
- Меньше шагов: методы выборки вроде DDIM позволили получать примеры в 10-50 раз быстрее с той же моделью без переобучения. Это один из предшественников методов, которые стремятся к хорошему результату за малое число шагов.
- Подходы, не основанные на диффузии: не каждая модель изображений использует диффузию. OpenAI сообщила, что встроенная генерация изображений в GPT-4o - авторегрессионная модель, в отличие от DALL·E, которая является диффузионной.
Как эти знания помогают писать промпт?
Понимание логики диффузии помогает строить промпт осознанно. Модель определяет композицию на ранних шагах, а детали - на поздних, поэтому промпт должен описывать и общую картину, и детали. Можно попробовать такой порядок:
- Тема: что вы хотите увидеть? Выберите один главный объект.
- Место и свет: где это происходит, в какое время суток, каким светом?
- Кадрирование: крупный план, широкий угол или вид сверху?
- Стиль: фотография, акварель, 3D-рендер, старая пленка...
- Детали: цветовая палитра, фактура, материалы.
Слабый промпт:
красивое кафе
Более сильный промпт:
Небольшое районное кафе при утреннем свете, у окна - чашка чая с поднимающимся паром, деревянный стол, теплые тона, широкий угол, стиль документальной фотографии
Во втором промпте у модели меньше пространства для догадок: свет, кадр и стиль заданы, поэтому руководство на каждом шаге тянет в одном направлении. Если результат не нравится, зафиксируйте seed и меняйте одну вещь: сначала свет, потом кадр. Так вы увидите, какое слово что меняет.
Типичные ошибки
- Противоречивые требования: выражения вроде «простое, но очень детальное» тянут модель в разные стороны.
- Длинные списки через запятую: второстепенные слова размывают важные; сначала напишите главную мысль.
- Отрицание в основном промпте: многие модели плохо понимают отрицания, и «без шляпы» может напомнить модели о шляпе. Если модель поддерживает, пишите это в негативном промпте.
- Менять все при каждой попытке: сравнения без фиксированного seed и настроек вводят в заблуждение.
- Ожидать безупречный текст на изображении: новые модели пишут гораздо лучше, но в длинных текстах ошибки в буквах еще возможны. Если нужна надпись на картинке, делайте ее короткой.
Итоги
- Большинство AI-моделей изображений работают на диффузии: они начинают с чистого шума и очищают его шаг за шагом.
- В обучении модель учится предсказывать шум; при каждой генерации она вычисляет новое изображение.
- Промпт через текстовый кодировщик направляет очистку на каждом шаге.
- Латентное пространство позволяет считать на маленьком представлении; результат в конце разворачивается в пиксели.
- Seed задает начальный шум, масштаб руководства - вес промпта, сила - близость к фото.
- Для хорошего результата опишите тему, свет, кадр и стиль; меняйте за раз одну вещь при фиксированном seed.
Частые вопросы
Модели генерации изображений копируют картинки из интернета?
В целом нет: модель усваивает закономерности из примеров обучения и каждый раз вычисляет новое изображение. Однако исследователи показали, что некоторые изображения из обучающих данных (среди них есть фото людей и логотипы) могут быть воспроизведены почти дословно. Поэтому избегайте промптов, которые копируют известные произведения или конкретных людей.
Почему один и тот же промпт каждый раз дает разный результат?
Потому что каждая генерация начинается со случайного шума. Если зафиксировать seed, начальный шум тоже фиксируется, и при тех же настройках обычно получается тот же или очень похожий результат; на другом оборудовании или в другой версии программы могут быть небольшие отличия.
Всегда ли больше шагов означает лучшее качество?
Нет. Слишком мало шагов дает недоработанное изображение, но после определенного предела дополнительные шаги почти не меняют результат и лишь увеличивают время. Методы вроде DDIM как раз созданы для хорошего результата при меньшем числе шагов.
Нужно ли ставить масштаб руководства (CFG) на максимум?
Обычно нет. Высокие значения сильнее привязывают результат к промпту, но снижают разнообразие, а очень высокие могут дать пересыщенный и искусственный вид. Начните со значения модели по умолчанию и меняйте его небольшими шагами.
Как при генерации по фото не дать лицу измениться?
Держите настройку силы (strength) на низком уровне и в промпте описывайте только то, что должно измениться. Чем выше сила, тем свободнее модель интерпретирует фото, и черты лица могут измениться.
Источники
- Sohl-Dickstein et al. (2015), Deep Unsupervised Learning using Nonequilibrium Thermodynamics
- Ho, Jain, Abbeel (2020), Denoising Diffusion Probabilistic Models
- Song, Meng, Ermon (2020), Denoising Diffusion Implicit Models
- Radford et al. (2021), Learning Transferable Visual Models From Natural Language Supervision (CLIP)
- Meng et al. (2021), SDEdit: Guided Image Synthesis and Editing with Stochastic Differential Equations
- Rombach et al. (2022), High-Resolution Image Synthesis with Latent Diffusion Models
- Saharia et al. (2022), Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding (Imagen)
- Ho, Salimans (2022), Classifier-Free Diffusion Guidance
- Peebles, Xie (2022), Scalable Diffusion Models with Transformers
- Carlini et al. (2023), Extracting Training Data from Diffusion Models
- Esser et al. (2024), Scaling Rectified Flow Transformers for High-Resolution Image Synthesis
- OpenAI (2025), Addendum to GPT-4o System Card: Native image generation
- Hugging Face Diffusers: Understanding pipelines, models and schedulers
- Hugging Face Diffusers: Image-to-image
- Hugging Face Diffusers: Reproducibility
Похожие статьи
Руководства
Как работает генерация AI-видео: идея движения
Модель AI-видео не рисует кадры по одному, а строит движение целиком. Рассказываем, как диффузия распространяется на время, почему клипы остаются короткими и чем отличаются текстовый и фото-вход.
6 мин чтения
Руководства
Стоимость AI-генерации: как работают токены и кредиты?
AI-инструменты тарифицируют генерацию токенами или кредитами, потому что каждый результат - реальные вычисления. Стоимость задают модель, разрешение, длительность и число попыток; собрали способы тратить меньше.
6 мин чтения
Руководства
В браузере или в приложении? Что учесть при выборе AI-инструмента
В браузере удобнее подробная работа на большом экране, а приложение быстрее для генерации с телефона. Сравниваем экран, загрузку, приватность, оплату, уведомления и офлайн-режим и помогаем выбрать.
6 мин чтения