Руководства
Как работает генерация AI-видео: идея движения
Модель AI-видео не рисует кадры по одному, а строит движение целиком. Рассказываем, как диффузия распространяется на время, почему клипы остаются короткими и чем отличаются текстовый и фото-вход.
Команда Zling AI6 мин чтения
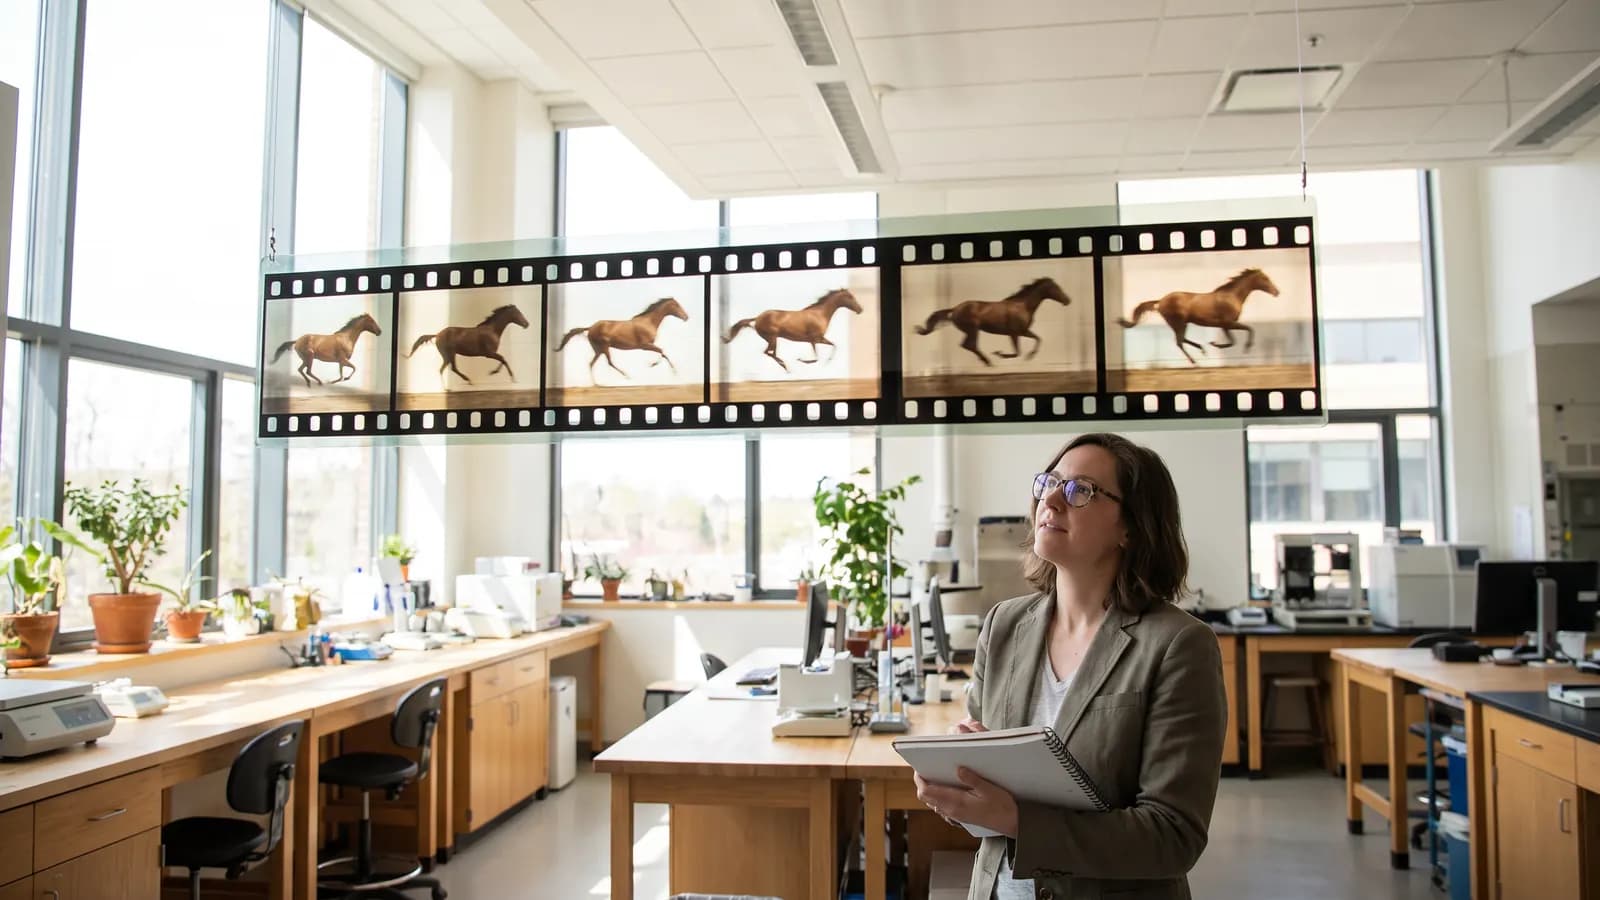
Короткий ответ: модель AI-видео не рисует ролик кадр за кадром как отдельные картинки; она создает кадры как единое целое, учитывая одновременно движение и время. В основе лежит та же идея диффузии, что и в генерации изображений, но данные теперь - не одна картинка, а последовательность кадров, растянутая во времени. В этой статье мы объясняем, как это устроено, почему клипы короткие и чем отличаются текстовый и фото-вход, опираясь на содержание соответствующих научных статей.
Что такое видео с точки зрения модели?
Видео - это последовательность кадров, которые показываются с определенной частотой в секунду. Для модели это блок данных с высотой, шириной и осью времени. Для простого введения в генерацию изображений см. нашу статью Как работает генерация AI-изображений?: там описана логика очистки от шума шаг за шагом, и здесь она тоже действует. Разница в том, что очищается не один кадр, а весь блок, включая связь между кадрами.
Как диффузия распространилась на время?
В статье Хо и соавторов о диффузии для видео подход описан как естественное продолжение стандартной архитектуры диффузии для изображений. В ней подчеркиваются два момента: совместное обучение модели на изображениях и видео ускоряет обучение и снижает вариативность градиентов; а новый метод условной выборки позволяет расширять видео как в пространстве, так и во времени. В той же статье приведены первые результаты генерации видео по тексту в большом масштабе.
Imagen Video строит не одну огромную модель, а цепочку. Сначала базовая модель создает видео в низком разрешении, затем пространственные (которые повышают резкость кадров) и временные (которые делают движение плавнее) модели сверхразрешения по очереди доводят результат. Так разрешение и плавность решаются на разных этапах.
Новые модели: пространственно-временные патчи
Технический отчет OpenAI о Sora суммирует общую идею многих современных систем: текстовые диффузионные модели обучаются на видео и изображениях разной длительности, разрешения и соотношения сторон, а сама модель - трансформер, работающий с пространственно-временными патчами скрытых (латентных) кодов видео и изображений. Сначала сеть сжатия переводит видео в маленькое скрытое пространство, а из него вырезаются патчи, которые для трансформера играют роль «токенов». В конце декодер возвращает латентные коды в пиксели. Отчет утверждает, что самая крупная модель может создавать видео длительностью около минуты. При этом сам отчет содержит качественные результаты и не раскрывает подробностей модели.
Статья Meta о Movie Gen идет в похожем направлении: самая большая видеомодель - трансформер с 30 миллиардами параметров, который создает видео 1080p HD с синхронным звуком. Кроме того, модель может создавать персонализированное видео по изображению пользователя и редактировать видео по инструкции.
Что такое временная согласованность и почему это трудно?
Согласованность означает, что лицо, одежда и сцена персонажа остаются одинаковыми от кадра к кадру, а движение выглядит физически правдоподобным. Если генерировать кадры независимо, в каждом возникнут мелкие различия, и видео начнет мерцать. Именно поэтому модели обрабатывают кадры вместе: каждый кадр создается с учетом того, что содержат соседние.
Но согласованность не гарантирована. При длинных или сложных движениях число пальцев может измениться, предметы могут исчезнуть, один объект может превратиться в другой. Это следствие того, что модель не знает законов физики, а выучивает закономерности из обучающих данных; в лучшем случае она делает очень хорошее предположение.
Почему AI-клипы короткие?
В официальных источниках нет одного предложения, которое объяснило бы это, но цифры дают подсказку. В статье о Movie Gen сказано, что контекст модели ограничен 73 тысячами видеотокенов; при 16 кадрах в секунду это примерно 16 секунд. В сравнении на странице Veo от Google указано, что видео Veo имеют длительность 8 секунд. Если говорить в общем, каждая дополнительная секунда увеличивает и число токенов для обработки, и расход памяти и вычислений; в механизме внимания стоимость быстро растет с увеличением длины последовательности. К тому же ошибки накапливаются: лицо, верное на первой секунде, через десять секунд может «уплыть».
Распространенный способ получить более длинную сцену - продолжить существующий клип. Условная выборка Хо и соавторов, которая опирается на предыдущую часть, дает академическую основу для растяжения видео во времени; страница Veo также говорит, что клипы можно продлевать функцией расширения сцены. На практике это означает последовательную генерацию нескольких коротких клипов и их монтаж.
Чем отличаются текстовый и фото-вход?
| Вход | Что делает модель? | Сильная сторона | Внимание |
|---|---|---|---|
| Только текст | Создает сцену, персонажа и движение с нуля | Свобода творчества | Композицию и персонажа трудно предсказать |
| Фото (+ текст) | Берет ваш кадр за начало и добавляет движение | Внешний вид остается стабильным, контроль выше | Области за пределами фото модель додумывает сама |
| Первый и последний кадр | Создает переход между двумя кадрами | Начало и конец задаете вы | Не каждая модель это поддерживает |
В статье о Stable Video Diffusion сказано, что базовая модель выучивает сильное представление движения, и его можно адаптировать к подзадачам вроде генерации видео по фото. Страница Veo перечисляет как текст-в-видео, так и фото-в-видео, а также входы в виде первого и последнего кадра и референсных изображений. Значит, вход фотографией отвечает на вопрос «как это должно выглядеть», а текст - на вопрос «что должно произойти».
Почему данные для обучения так важны?
В статье о Stable Video Diffusion описаны три этапа обучения видеомоделей: предварительное обучение на тексте и изображениях, предварительное обучение на видео и тонкая настройка на видео высокого качества. Авторы подчеркивают, что для хорошей модели нужен тщательно отобранный набор данных для предварительного обучения, а подписывание и фильтрация данных - часть этого процесса. Итог: что модель умеет делать хорошо, зависит от того, какие движения она видела. На редких движениях и необычных сценах качество снижается.
Что можно сделать, чтобы улучшить результат?
- Просите одно действие: вместо «женщина поворачивается, улыбается, машет рукой и уходит» выберите одно действие.
- Называйте камеру: статичный кадр, медленное приближение, панорама вслед за объектом.
- Задавайте первый кадр сами: если важна согласованность, попробуйте режим «фото в видео».
- Создавайте короткие клипы и соединяйте их: вместо одного длинного запроса - контролируемые короткие клипы.
- Делайте несколько попыток: одинаковый запрос дает разные результаты.
Пример запроса: Статичная камера, в вечернем свете по берегу моря идет женщина в красной куртке, ветер слегка треплет ее волосы, медленный и естественный темп.
Как звук и движение камеры входят в процесс?
Некоторые модели создают не только изображение, но и звук. В статье о Movie Gen сказано, что модель создает синхронный звук наряду с видео 1080p HD; страница Veo говорит, что звук создается нативно и в него можно добавлять звуковые эффекты, фоновые шумы и диалоги. Поскольку звук планируется вместе с изображением, синхронизация губ и совпадение звука с событием выстраиваются легче, чем при добавлении звука отдельно. Однако страница прямо указывает, что согласованная речь все еще развивается.
Что касается движения камеры, в статье о Stable Video Diffusion есть любопытная деталь: базовую модель можно адаптировать к движениям камеры с помощью небольших модулей LoRA, обученных на конкретных типах движения. То есть «медленный наезд» или «сдвиг вбок» - отдельный навык модели, который можно вызвать. Поэтому полезно явно называть камеру в запросе: так вы помогаете модели задействовать нужный навык.
Типичные ошибки
- Много действий в одном запросе: модель смешивает движения или пропускает часть.
- Не указывать камеру: модель выбирает ее случайным образом.
- Ожидать идеальной физики: всегда просматривайте результат кадр за кадром.
- Сразу заказывать длинный клип: с ростом длительности согласованность падает.
- Считать речь гарантированной: страница Veo указывает, что согласованная речь, особенно в коротких репликах, все еще развивается.
- Публиковать без пометки: некоторые системы, например Veo, помечают результат водяным знаком SynthID; при публикации укажите, что видео создано ИИ.
Итоги
- Видеомодели создают кадры совместно, учитывая время; в основе - диффузия, а во многих моделях - трансформер.
- Согласованность между кадрами - это цель, а не гарантия.
- Ограничение длительности связано с вычислительными затратами и накоплением ошибок; длинная сцена собирается из клипов.
- Текст задает, что произойдет, фото - как это будет выглядеть; первый и последний кадр связывают два состояния.
- Одно действие, явная камера и несколько попыток дают лучший результат.
Частые вопросы
Модель AI-видео рисует каждый кадр как отдельную картинку?
Нет. Статья о диффузии для видео описывает подход как расширение диффузии для изображений, в котором кадры обрабатываются вместе. Так стараются добиться согласованности между кадрами, но это не гарантируется.
Почему видео обычно длятся несколько секунд?
Официальные источники не дают одного объяснения. Статья о Movie Gen указывает контекст примерно в 73 тысячи видеотокенов, что соответствует около 16 секундам; страница Veo говорит о 8-секундных видео. В целом с ростом длительности растут вычислительные затраты и накопление ошибок.
Как получить более длинное видео?
Распространенный способ - продлить существующий клип или создать несколько коротких клипов и смонтировать их. Страница Veo говорит, что клипы можно продлевать функцией расширения сцены.
Фото на входе лучше текста?
Если важно, чтобы внешний вид оставался прежним, фото на входе обычно дает больше контроля, потому что начальный кадр задаете вы. Для свободной сцены достаточно текста.
Можно ли считать, что модель Sora из отчета такая же, как в других системах?
Нет. Отчет описывает подход и качественные результаты, но не раскрывает подробностей модели. Трансформер, работающий с пространственно-временными патчами, распространен, но внутреннее устройство разных систем не совпадает.
Источники
- Ho ve ark.: Video Diffusion Models (arXiv:2204.03458)
- Ho ve ark.: Imagen Video: High Definition Video Generation with Diffusion Models
- Blattmann ve ark.: Stable Video Diffusion (arXiv:2311.15127)
- Meta: Movie Gen: A Cast of Media Foundation Models (arXiv:2410.13720)
- OpenAI: Video generation models as world simulators
- Google DeepMind: Veo
Похожие статьи
Руководства
Как работает генерация изображений AI: простое введение в диффузию
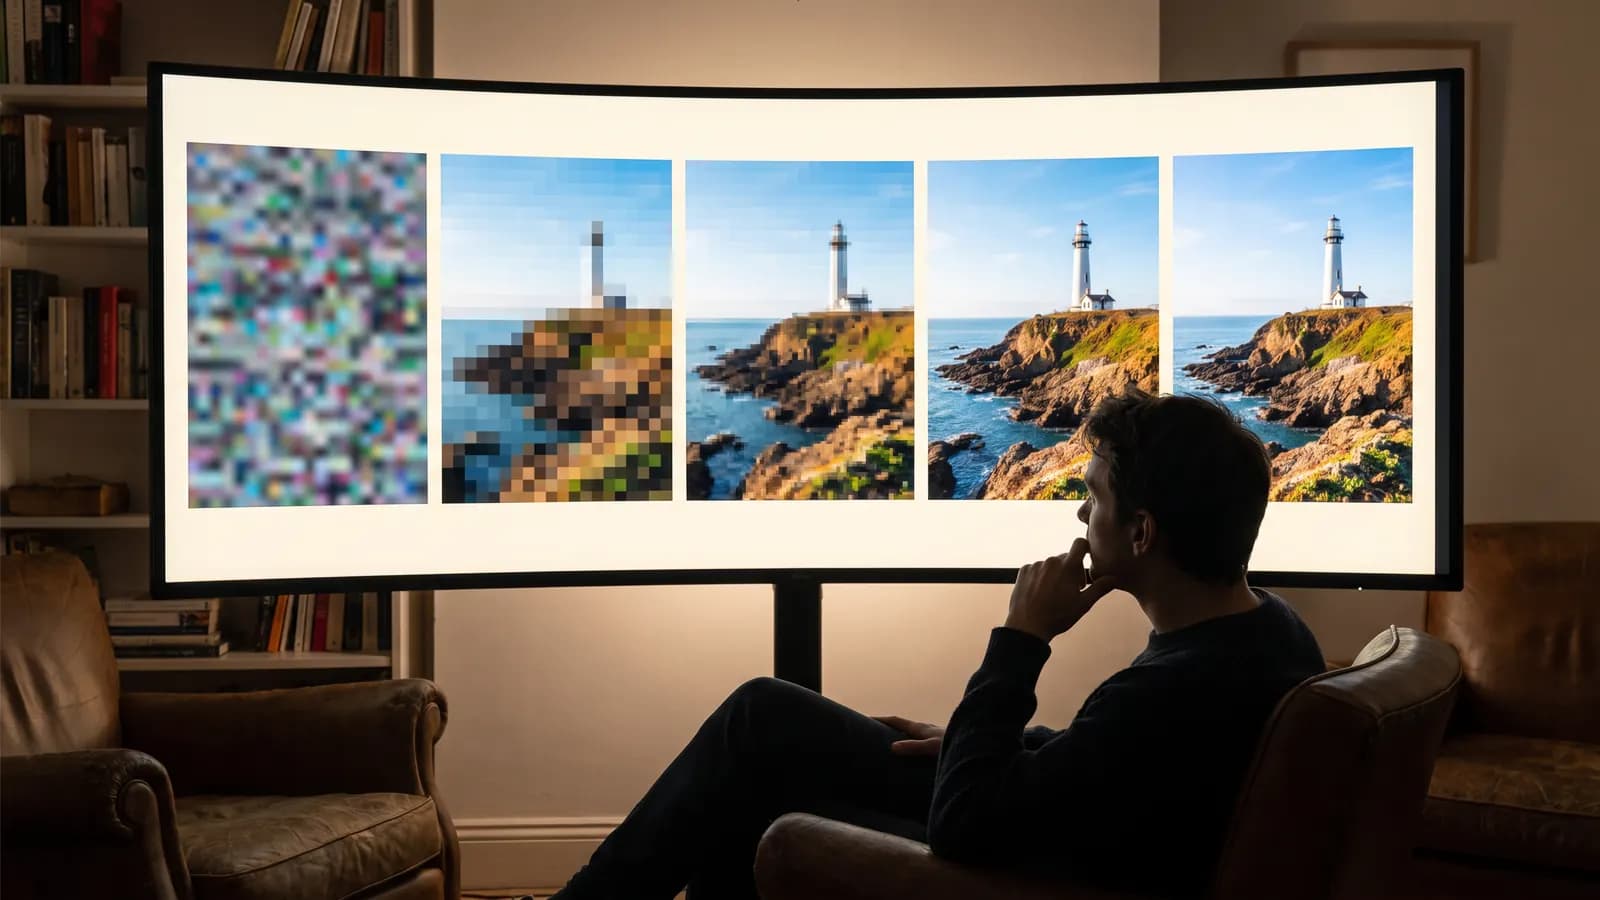
ИИ не вырезает картинки из архива: он начинает со случайного шума и шаг за шагом его очищает. Объясняем логику диффузии, место промпта в этом процессе и то, что меняют настройки.
8 мин чтения
Руководства
Стоимость AI-генерации: как работают токены и кредиты?
AI-инструменты тарифицируют генерацию токенами или кредитами, потому что каждый результат - реальные вычисления. Стоимость задают модель, разрешение, длительность и число попыток; собрали способы тратить меньше.
6 мин чтения
Руководства
В браузере или в приложении? Что учесть при выборе AI-инструмента
В браузере удобнее подробная работа на большом экране, а приложение быстрее для генерации с телефона. Сравниваем экран, загрузку, приватность, оплату, уведомления и офлайн-режим и помогаем выбрать.
6 мин чтения