Rehberler
AI görsel üretimi nasıl çalışır? Difüzyona sade giriş
Yapay zekâ görselleri bir arşivden kesip biçmez: rastgele gürültüyle başlar ve onu adım adım temizler. Difüzyonun mantığını, promptun bu süreçteki yerini ve ayarların neyi değiştirdiğini öğren.
Zling AI Ekibi8 dk okuma
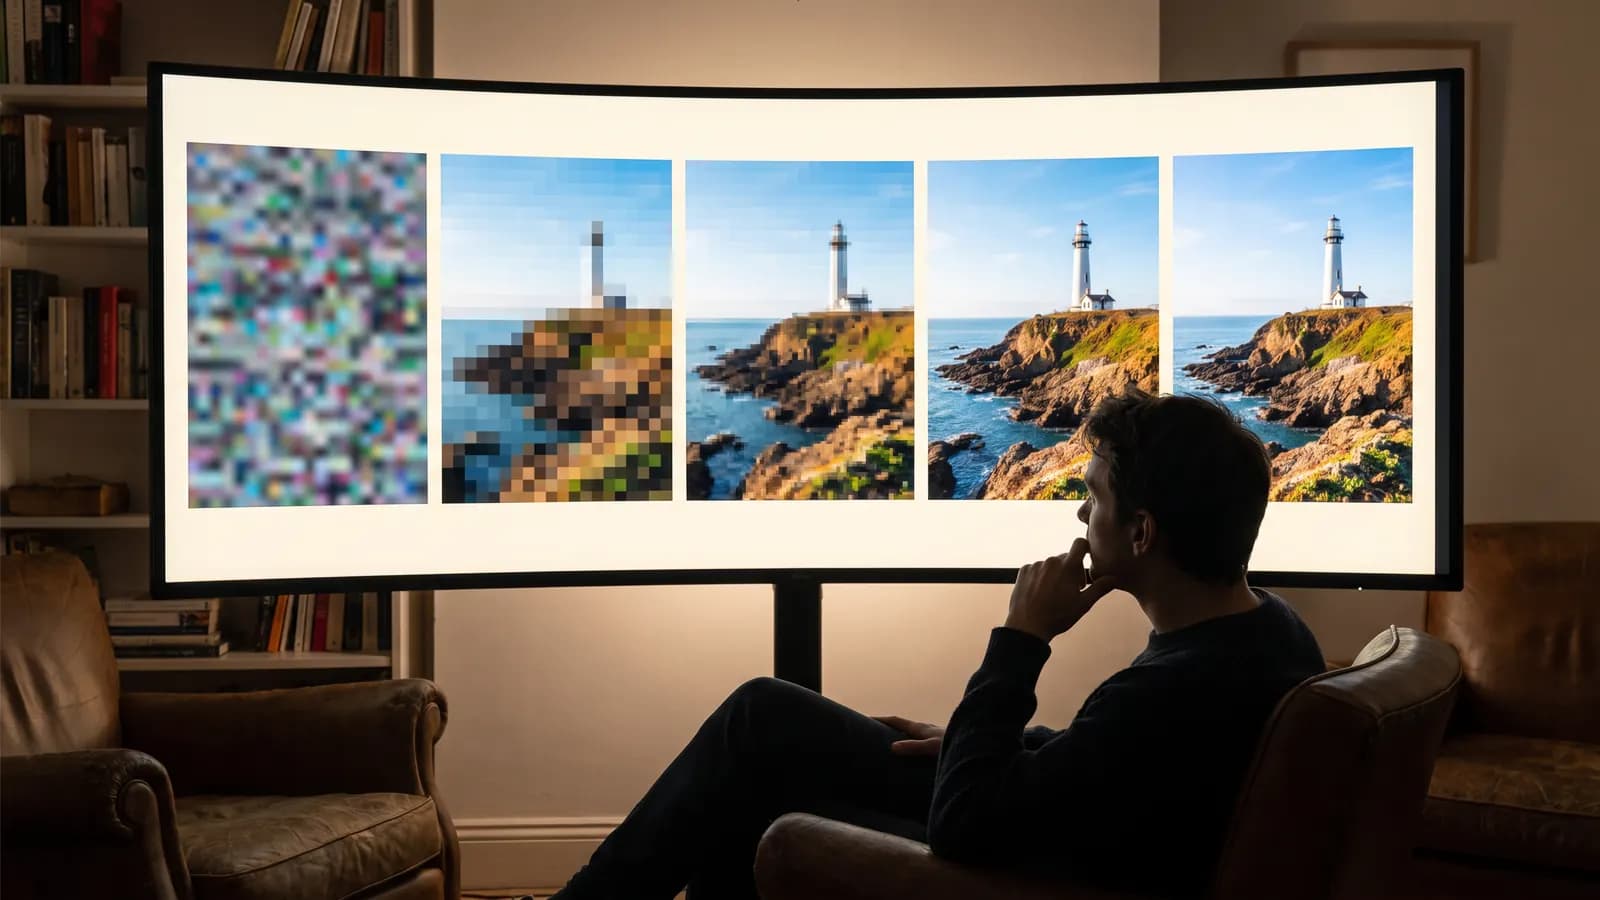
Kısa cevap: Bugünkü AI görsel modellerinin çoğu difüzyon adı verilen bir yöntemle çalışır. Model, rastgele gürültüden oluşan bir “kar” ekranıyla başlar ve yazdığın cümleye bakarak bu gürültüyü onlarca adımda temizler; her adımda görüntü biraz daha netleşir. Bu yazıda sürecin nasıl işlediğini, promptun nerede devreye girdiğini ve ayarların gerçekte neyi değiştirdiğini jargona boğulmadan anlatıyoruz.
AI görsel üretimi kısaca nasıl çalışır?
Metinden görsel üreten bir sistem, birlikte çalışan üç parçadan oluşur:
- Metin kodlayıcı: Yazdığın promptu, modelin işleyebileceği sayısal bir temsile çevirir.
- Gürültü giderici ağ: Gürültülü bir görüntüye bakıp içindeki gürültüyü tahmin eder. İşin asıl yükü buradadır.
- Kod çözücü: Modelin sıkıştırılmış bir uzayda ürettiği sonucu, ekranda gördüğün piksellere dönüştürür.
Üretim sırasında gürültü giderici ağ aynı görüntü üzerinde defalarca çalışır. Her turda metin kodlayıcının verdiği bilgiye bakar ve görüntüyü promptuna biraz daha yaklaştırır. Sonuç, bir arşivden bulunup getirilen hazır bir resim değil; o an, adım adım hesaplanan yeni bir görseldir.
Difüzyon nedir? Gürültüden resme giden yol
Difüzyon fikri 2015'te Jascha Sohl-Dickstein ve arkadaşlarının makalesiyle ortaya çıktı: verideki yapıyı yavaş yavaş bozan bir süreç tanımla, sonra bu süreci tersine çevirmeyi öğren. Yöntemin görsel kalitesiyle öne çıkması ise 2020'de Jonathan Ho, Ajay Jain ve Pieter Abbeel'in Denoising Diffusion Probabilistic Models (DDPM) makalesiyle oldu.
Eğitim: resmi bozmak ve onarmayı öğrenmek
Eğitimde modele gerçek görseller gösterilir, ama temiz hâlleriyle değil. Her görsele küçük adımlarla rastgele (Gauss) gürültü eklenir. DDPM makalesinde bu bozma süreci 1.000 adım olarak ayarlanmıştı; son adıma gelindiğinde görselden geriye neredeyse saf gürültü kalır. Modelin görevi şaşırtıcı derecede basittir: herhangi bir adımdaki gürültülü görüntüye bakıp içine eklenen gürültüyü tahmin etmek. Bu tahmini çok sayıda örnek üzerinde tekrar tekrar yaptıkça model, gerçek bir görüntünün neye benzediğini dolaylı yoldan öğrenir.
Üretim: saf gürültüden başlamak
Görsel üretirken süreç tersine işler. Model saf gürültüyle başlar, içindeki gürültüyü tahmin eder ve bir kısmını çıkarır. Ortaya çıkan, biraz daha düzenli görüntü bir sonraki adımın girdisi olur. İlk adımlarda kaba renk lekeleri ve kompozisyon belirir; ortadaki adımlarda biçimler oturur; son adımlarda doku, kenar ve ışık gibi ince ayrıntılar netleşir. Önce kaba hatları, sonra ince ayrıntıları yontan bir heykeltıraşı düşünebilirsin.
Model, görselleri bir veri tabanından kesip yapıştırmaz; eğitimde gördüğü örneklerden genel kalıplar öğrenir ve her üretimde yeni bir görüntü hesaplar. Yine de araştırmacılar, eğitim verisindeki bazı görsellerin neredeyse aynen yeniden üretilebildiğini de gösterdi. Bu yüzden tanınmış bir eseri ya da kişiyi birebir taklit etmeye çalışan promptlardan uzak durmak iyi bir alışkanlıktır.
Model yazdığın cümleyi nasıl anlıyor?
Gürültü giderilirken görüntünün hangi yöne gideceğini prompt belirler. Bunun için metin önce bir metin kodlayıcıdan geçer. Bu alandaki önemli adımlardan biri 2021'de yayımlanan CLIP oldu: internetten toplanan 400 milyon görsel-metin çifti üzerinde, hangi açıklamanın hangi görsele ait olduğunu tahmin edecek biçimde eğitildi. Böylece kelimeler ve görsel kavramlar aynı sayısal uzayda buluştu.
Google araştırmacılarının Imagen çalışması ilginç bir bulgu paylaştı: yalnız metinle eğitilmiş büyük bir dil modelini (T5) metin kodlayıcı olarak kullanmak çok iyi sonuç veriyor; bu kodlayıcıyı büyütmek de görseli üreten kısmı büyütmekten daha fazla kalite ve metin-görsel uyumu kazandırıyor. Yeni modellerin uzun ve ayrıntılı promptları daha iyi anlamasının bir nedeni bu.
Metin ile görüntü arasındaki bağ çoğu modelde çapraz dikkat (cross-attention) katmanlarıyla kurulur: görüntünün her bölgesi, her adımda promptun hangi kelimelerine “bakacağını” hesaplar. “Kırmızı şemsiyeli bir kadın” yazdığında kırmızının şemsiyeye gitmesi bu eşleştirmenin işidir. Eşleştirme kusursuz değildir; bir rengin ya da özelliğin yanlış nesneye kayması bu yüzden görülür.
Neden doğrudan piksellerle çalışılmıyor? Latent uzay
Bir görseli piksel piksel ve onlarca adımda işlemek çok pahalıdır. Robin Rombach ve ekibinin Latent Diffusion Models makalesi (CVPR 2022) bu sorunu çözen yaklaşımı yaygınlaştırdı: önce bir otomatik kodlayıcı görseli çok daha küçük, sıkıştırılmış bir temsile (latent) çevirir; difüzyon bu küçük temsil üzerinde çalışır; en sonda kod çözücü sonucu yeniden tam boyutlu bir görsele açar.
Somut bir örnek: Hugging Face'in diffusers belgelerinde anlatılan Stable Diffusion akışında 512×512 piksellik bir görsel, her kenarı 8 kat küçültülmüş 64×64'lük bir latent olarak işlenir. Hesap yükü bu sayede ciddi biçimde azalır. Bugün kullandığın modellerin çoğu bu fikrin bir türevine dayanır.
Prompt dışındaki ayarlar ne işe yarar?
Üretim ekranlarında gördüğün ayarların çoğu, yukarıdaki sürecin bir parçasını doğrudan kontrol eder. Her model bunların hepsini göstermez; ama ne yaptıklarını bilmek, sonucu okumanı ve düzeltmeni kolaylaştırır.
| Ayar | Sürecin hangi parçası | Pratik etkisi |
|---|---|---|
| Seed (tohum) | Başlangıçtaki rastgele gürültü | Aynı seed, prompt ve ayarlarla genellikle aynı ya da çok benzer sonuç alınır |
| Adım sayısı | Gürültü giderme turlarının sayısı | Çok az adım yarım kalmış görüntü verir; belli bir noktadan sonra fark azalır, süre uzar |
| Rehberlik ölçeği (CFG) | Promptun her adımdaki ağırlığı | Yükseldikçe sonuç prompta daha sıkı uyar, çeşitlilik azalır; aşırı değerler yapay görünüm verebilir |
| Negatif prompt | Modelin uzaklaşması istenen kavramlar | “Bulanık”, “az ayrıntı” gibi istenmeyen özellikleri azaltmaya yardım eder |
| Güç (strength) | Fotoğraftan görselde eklenen gürültü miktarı | Düşük değer fotoğrafa sadık kalır, yüksek değer daha serbest yorumlar |
| En-boy oranı | Başlangıç gürültüsünün boyutu | Kompozisyonu belirler; dikey kadraj portreye, yatay kadraj manzaraya uygundur |
Rehberlik ölçeği neden var?
Jonathan Ho ve Tim Salimans'ın Classifier-Free Diffusion Guidance çalışması, bugün pek çok modelde kullanılan yöntemi tanımladı. Eğitim sırasında prompt zaman zaman bilerek boş bırakılır; böylece aynı model hem promptlu hem promptsuz tahmin yapmayı öğrenir. Üretimde iki tahmin arasındaki fark büyütülür ve görüntü prompta doğru itilir. Makalenin bulgusu bu ayarın neden bir denge olduğunu da açıklar: rehberlik arttıkça tek tek görsellerin isabeti artar, çeşitlilik ise azalır. Imagen makalesi de çok yüksek rehberlik değerlerinin aşırı doygun ve doğal olmayan görüntülere yol açabildiğini not eder.
Seed neden aynı sonucu verir?
Seed, başlangıç gürültüsünü üreten rastgele sayı üretecinin başlangıç değeridir. Aynı seed aynı gürültüyü verir; aynı gürültü de aynı prompt ve ayarlarla aynı yolu izler. Bu yüzden seed'i sabitleyip promptta yalnız tek bir kelimeyi değiştirmek, o kelimenin etkisini görmenin en temiz yoludur. Küçük bir not: diffusers belgelerinin de belirttiği gibi, aynı seed farklı donanımda ya da yazılım sürümünde birebir aynı sonucu garanti etmez.
Fotoğraftan görsel (image-to-image) nasıl çalışır?
Bir fotoğraf yükleyip “bunu suluboya tabloya çevir” dediğinde süreç saf gürültüden başlamaz. Fotoğrafın kendisi latent uzaya çevrilir, üzerine bir miktar gürültü eklenir ve gürültü giderme bu yarı bozulmuş hâlden başlar. Bu fikir 2021'de SDEdit makalesinde tanımlandı: eklenen gürültü arttıkça sonuç daha serbest, azaldıkça fotoğrafa daha sadık olur.
diffusers belgelerindeki örnek bunu sayılarla gösterir: 50 adımlık bir ayarda güç 0,8 ise fotoğrafa 40 adımlık gürültü eklenir ve 40 adım boyunca temizlenir. Güç 1,0'a yaklaştıkça fotoğraf neredeyse tamamen yok sayılır. Yüzün, kıyafetin ya da ürünün korunmasını istiyorsan düşük ya da orta bir güçle başla; sahneyi baştan değiştirmek istiyorsan gücü artır.
Yeni nesil modellerde ne değişti?
Temel fikir aynı kalsa da mimari hızla değişiyor:
- Transformer omurgası: İlk modeller U-Net adlı evrişimli bir ağ kullanıyordu. William Peebles ve Saining Xie'nin Diffusion Transformers (DiT) çalışması, latent parçalar üzerinde çalışan bir transformer'ın daha fazla hesap gücüyle düzenli biçimde iyileştiğini gösterdi.
- Rectified flow: Patrick Esser ve ekibinin 2024 tarihli makalesi, gürültü ile veriyi düz bir çizgiyle bağlayan “rectified flow” yaklaşımını büyük ölçekte denedi. Yazarlar, metin ve görsel için ayrı ağırlıklar kullanan transformer mimarilerinin prompt anlamada ve görselin içine yazı yazmada (tipografi) iyileşme sağladığını bildiriyor.
- Daha az adım: DDIM gibi örnekleme yöntemleri, eğitimi değiştirmeden aynı modelden 10 ila 50 kat daha hızlı örnek almayı mümkün kıldı. Az adımla sonuç almayı hedefleyen yöntemlerin öncülerinden biri budur.
- Difüzyon dışı yaklaşımlar: Her görsel modeli difüzyon kullanmaz. OpenAI, GPT-4o'nun yerleşik görsel üretiminin, difüzyon modeli olan DALL·E'den farklı olarak otoregresif bir model olduğunu açıkladı.
Bu bilgi prompt yazarken nasıl işine yarar?
Difüzyonun mantığını bilmek, promptunu daha bilinçli kurmanı sağlar. Model ilk adımlarda kompozisyonu, son adımlarda ayrıntıyı belirlediği için promptun hem büyük resmi hem ayrıntıyı anlatmalı. Şu sırayı deneyebilirsin:
- Konu: Ne görmek istiyorsun? Tek bir ana öğe seç.
- Ortam ve ışık: Nerede, günün hangi saatinde, nasıl bir ışıkta?
- Kadraj: Yakın çekim mi, geniş açı mı, kuş bakışı mı?
- Stil: Fotoğraf, suluboya, 3B çizim, eski film...
- Ayrıntı: Renk paleti, doku, malzeme.
Zayıf bir prompt:
güzel bir kafe
Daha güçlü bir prompt:
Sabah ışığında küçük bir mahalle kafesi, pencere kenarında buharı tüten bir fincan çay, ahşap masa, sıcak tonlar, geniş açı, belgesel fotoğraf tarzı
İkinci promptta modelin tahmin etmesi gereken boşluk azalır: ışık, kadraj ve stil belli olduğu için rehberlik her adımda aynı yöne iter. Sonucu beğenmezsen seed'i sabitleyip tek bir şeyi değiştir: önce ışığı, sonra kadrajı. Böylece hangi kelimenin neyi değiştirdiğini görürsün.
Sık yapılan hatalar
- Çelişkili istekler: “Sade ama çok ayrıntılı” gibi ifadeler modeli iki yöne birden çeker.
- Uzun virgül listeleri: Önemsiz kelimeler önemli olanların ağırlığını sulandırır; önce ana fikri yaz.
- Olumsuz ifadeyi ana prompta yazmak: Pek çok model olumsuz cümleleri iyi anlamaz ve “şapka olmasın” demek şapkayı akla getirebilir. Model destekliyorsa bunu negatif prompta yaz.
- Her denemede her şeyi değiştirmek: Seed ve ayarlar sabitlenmeden yapılan karşılaştırmalar yanıltıcıdır.
- Görselin içindeki yazıdan kusursuzluk beklemek: Yeni modeller yazıda çok daha iyi, ama uzun metinlerde harf hataları hâlâ görülebilir. Görselde yazı istiyorsan kısa tut.
Özet
- Çoğu AI görsel modeli difüzyonla çalışır: saf gürültüden başlar ve gürültüyü adım adım temizler.
- Model eğitimde gürültüyü tahmin etmeyi öğrenir; her üretimde yeni bir görüntü hesaplar.
- Prompt, metin kodlayıcıdan geçerek her adımda gürültü gidermeyi yönlendirir.
- Latent uzay sayesinde hesap küçük bir temsil üzerinde yapılır; sonuç en sonda piksellere açılır.
- Seed başlangıç gürültüsünü, rehberlik ölçeği promptun ağırlığını, güç ise fotoğrafa ne kadar sadık kalınacağını belirler.
- İyi sonuç için konuyu, ışığı, kadrajı ve stili açıkça yaz; denerken her seferinde tek bir şeyi değiştir.
Sık sorulan sorular
AI görsel modelleri internetteki resimleri kopyalıyor mu?
Genel olarak hayır: model eğitimde gördüğü örneklerden kalıplar öğrenir ve her üretimde yeni bir görüntüyü adım adım hesaplar. Ancak araştırmacılar, eğitim verisindeki bazı görsellerin (aralarında kişi fotoğrafları ve logolar da olan binden fazla örnek) neredeyse aynen yeniden üretilebildiğini gösterdi. Tanınmış eserleri ya da kişileri birebir taklit eden promptlardan kaçınmak bu yüzden de iyi bir alışkanlıktır.
Aynı promptla neden her seferinde farklı görsel çıkıyor?
Çünkü her üretim farklı bir rastgele gürültüyle başlar. Seed'i sabitlersen başlangıç gürültüsü de sabitlenir ve aynı ayarlarla genellikle aynı ya da çok benzer sonucu alırsın; farklı donanım ya da yazılım sürümlerinde küçük farklar yine de çıkabilir.
Adım sayısını artırmak her zaman daha iyi mi?
Hayır. Çok az adım yarım kalmış bir görüntü verir, ama belli bir noktadan sonra ek adımlar belirgin bir fark yaratmaz, yalnız süreyi uzatır. DDIM gibi örnekleme yöntemleri de zaten daha az adımla iyi sonuç almak için geliştirildi.
Rehberlik ölçeğini (CFG) en yükseğe çekmeli miyim?
Genellikle hayır. Yüksek değerler sonucu prompta daha sıkı bağlar ama çeşitliliği azaltır; çok yüksek değerler aşırı doygun ve yapay görünümlü görüntülere yol açabilir. Modelin varsayılan değeriyle başlayıp küçük adımlarla değiştirmek en güvenli yoldur.
Fotoğraftan görsel üretirken yüzün değişmemesi için ne yapmalıyım?
Fotoğrafa eklenen gürültüyü belirleyen güç (strength) ayarını düşük tut ve promptta yalnız değişmesini istediğin şeyi anlat. Güç arttıkça model fotoğrafı daha serbest yorumlar ve yüz hatları değişebilir.
Kaynaklar
- Sohl-Dickstein et al. (2015), Deep Unsupervised Learning using Nonequilibrium Thermodynamics
- Ho, Jain, Abbeel (2020), Denoising Diffusion Probabilistic Models
- Song, Meng, Ermon (2020), Denoising Diffusion Implicit Models
- Radford et al. (2021), Learning Transferable Visual Models From Natural Language Supervision (CLIP)
- Meng et al. (2021), SDEdit: Guided Image Synthesis and Editing with Stochastic Differential Equations
- Rombach et al. (2022), High-Resolution Image Synthesis with Latent Diffusion Models
- Saharia et al. (2022), Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding (Imagen)
- Ho, Salimans (2022), Classifier-Free Diffusion Guidance
- Peebles, Xie (2022), Scalable Diffusion Models with Transformers
- Carlini et al. (2023), Extracting Training Data from Diffusion Models
- Esser et al. (2024), Scaling Rectified Flow Transformers for High-Resolution Image Synthesis
- OpenAI (2025), Addendum to GPT-4o System Card: Native image generation
- Hugging Face Diffusers: Understanding pipelines, models and schedulers
- Hugging Face Diffusers: Image-to-image
- Hugging Face Diffusers: Reproducibility
İlgili yazılar
Rehberler
AI video üretimi nasıl çalışır? Hareketin arkasındaki fikir
Bir AI video modeli kareleri tek tek çizmez, hareketi bütün olarak kurar. Difüzyonun zamana nasıl genişletildiğini, klipler neden kısa kaldığını ve metinle fotoğraf girdisinin farkını anlattık.
6 dk okuma
Rehberler
AI üretim maliyeti: jeton ve kredi sistemleri nasıl işler?
AI araçları üretimi jeton ya da krediyle fiyatlıyor, çünkü her üretim gerçek hesaplama demek. Maliyeti çözünürlük, süre ve model belirliyor; daha az harcamanın yollarını da topladık.
5 dk okuma
Rehberler
Tarayıcıda mı, uygulamada mı? AI aracı seçerken bakılacaklar
Tarayıcı geniş ekranda ayrıntılı iş, uygulama telefondan hızlı üretim için daha rahat. Ekran, yükleme, gizlilik, ödeme, bildirim ve çevrimdışı farklarını ve doğru seçimi anlattık.
5 dk okuma