Rehberler
AI video üretimi nasıl çalışır? Hareketin arkasındaki fikir
Bir AI video modeli kareleri tek tek çizmez, hareketi bütün olarak kurar. Difüzyonun zamana nasıl genişletildiğini, klipler neden kısa kaldığını ve metinle fotoğraf girdisinin farkını anlattık.
Zling AI Ekibi6 dk okuma
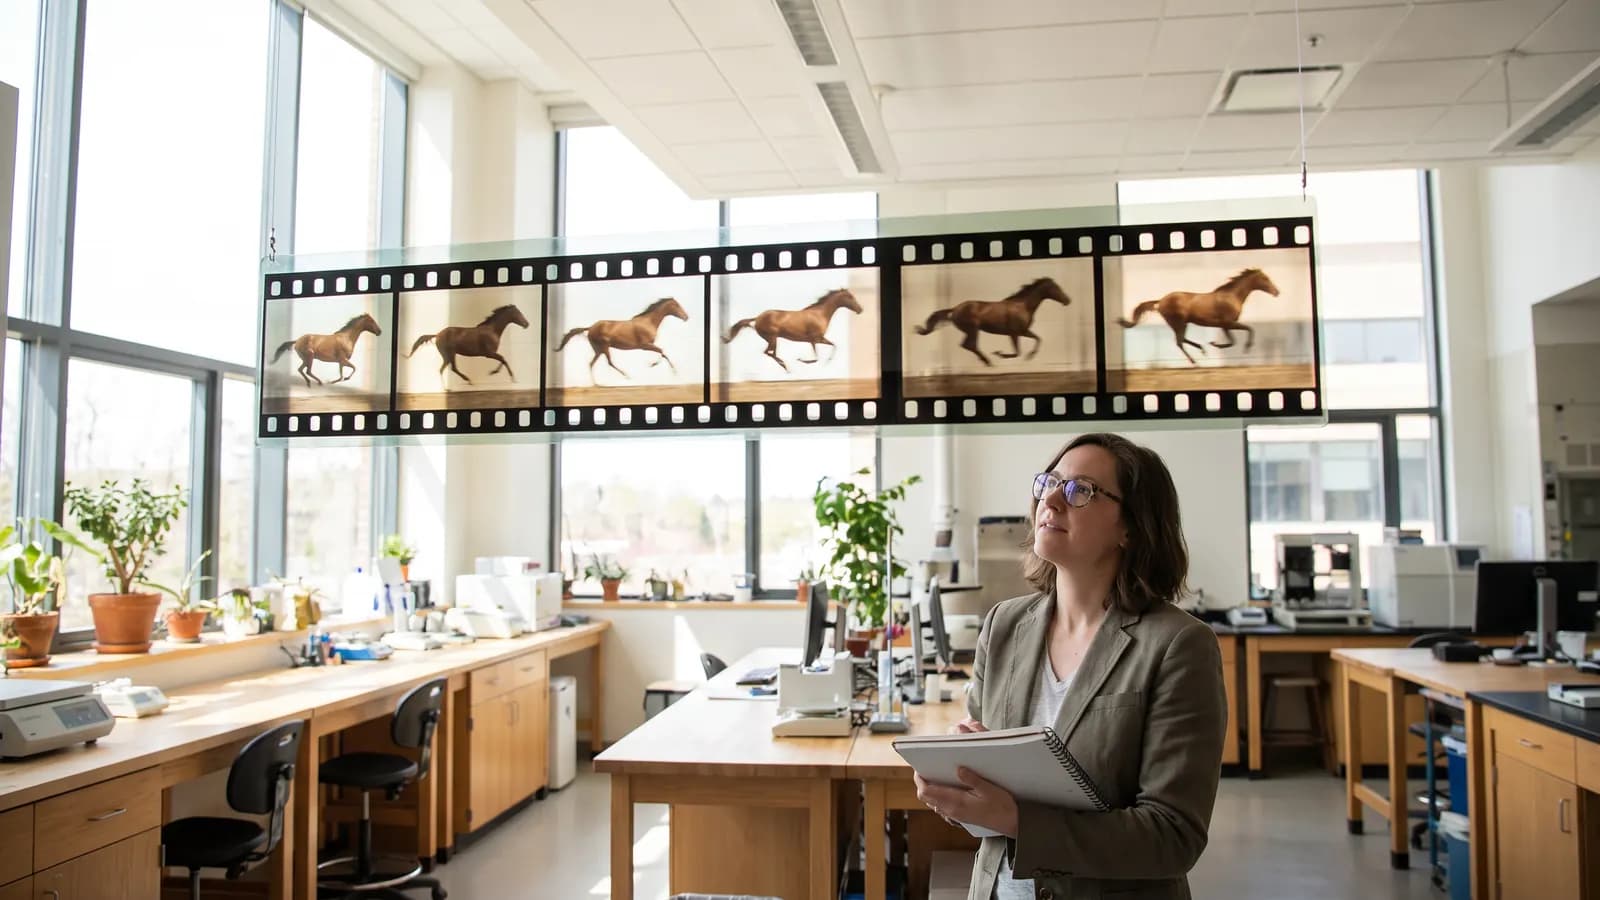
Kısa cevap: bir AI video modeli videoyu kare kare ayrı resimler olarak çizmez; kareleri tek bir paket gibi, hareketi ve zamanı birlikte hesaba katarak üretir. Temelde görsel üretiminin kullandığı difüzyon fikri duruyor, ama veri artık bir resim değil, zamana yayılmış bir kare dizisi. Bu yazıda bunun nasıl yapıldığını, kliplerin neden kısa kaldığını ve metin ile fotoğraf girdisinin farkını, ilgili makalelerin söylediklerine dayanarak anlatıyoruz.
Video aslında nedir, model onu nasıl görür?
Video, saniyede belli sayıda karenin art arda gösterilmesidir. Model için bu, yükseklik, genişlik ve bir de zaman ekseni olan bir veri bloğu demek. Görsel üretimine sade bir giriş için AI görsel üretimi nasıl çalışır? yazımıza bakabilirsin; orada anlatılan gürültüden başlayıp adım adım temizleme mantığı burada da geçerli. Fark, temizlenen şeyin tek bir kare değil, kareler arasındaki ilişkiyi de içeren bütün bir blok olması.
Difüzyon zamana nasıl genişletildi?
Ho ve arkadaşlarının video difüzyon makalesi, yaklaşımı standart görsel difüzyon mimarisinin doğal bir uzantısı olarak tanımlıyor. Makale iki şeyi öne çıkarıyor: modeli hem görsellerle hem videolarla birlikte eğitmek, eğitimi hızlandırıyor ve gradyan değişkenliğini azaltıyor; ayrıca yeni bir koşullu örnekleme yöntemi, videoyu hem uzamsal hem zamansal olarak uzatabiliyor. Aynı makale, geniş ölçekte metne bağlı video üretiminin ilk sonuçlarını bildiriyor.
Imagen Video ise tek bir dev model yerine bir zincir kuruyor. Önce düşük çözünürlüklü bir video üreten temel model çalışıyor, ardından uzamsal (kareleri keskinleştiren) ve zamansal (hareketi akıcılaştıran) süper çözünürlük modelleri dönüşümlü olarak işi büyütüyor. Yani çözünürlük ve akıcılık ayrı aşamalarda çözülebiliyor.
Daha yeni modeller: zaman-uzay yamaları
OpenAI'ın Sora teknik raporu, bugünkü birçok sistemin ortak fikrini özetliyor: metne bağlı difüzyon modelleri, farklı süre, çözünürlük ve en-boy oranına sahip video ve görsellerle birlikte eğitiliyor; model, videonun ve görselin gizli (latent) kodlarının zaman-uzay yamaları üzerinde çalışan bir transformer. Önce bir sıkıştırma ağı videoyu küçük bir gizli uzaya indiriyor, bu uzaydan kesilen yamalar da transformer için “jeton” görevi görüyor. Üretim sonunda bir çözücü gizli kodları yeniden piksele çeviriyor. Rapor ayrıca, en büyük modelin yaklaşık bir dakikalık video üretebildiğini söylüyor. Raporun kendisi nitel sonuçlar veriyor ve model ayrıntılarını paylaşmıyor.
Meta'nın Movie Gen makalesi de benzer bir yöne işaret ediyor: en büyük video modeli 30 milyar parametreli bir transformer, 1080p HD video ve senkron ses üretiyor, ayrıca bir kullanıcının görselinden kişiselleştirilmiş video ve talimata dayalı düzenleme yapabiliyor.
Zamansal tutarlılık nedir, neden zor?
Tutarlılık, karakterin yüzünün, kıyafetinin ve sahnenin kareler boyunca aynı kalması, hareketin de fiziksel olarak mantıklı görünmesi demek. Kareleri birbirinden bağımsız üretsen her karede küçük farklar çıkar ve video titrer. Modellerin kareleri birlikte işlemesinin ana nedeni bu: her kare, komşu karelerin ne içerdiğini “görerek” üretiliyor.
Yine de tutarlılık garanti değil. Uzun veya karmaşık hareketlerde elin parmak sayısı değişebilir, nesneler kaybolabilir, bir nesne başka bir şeye dönüşebilir. Bu, modelin fizik kurallarını bilmediği, yalnızca eğitim verisindeki örüntüleri öğrendiği gerçeğinin sonucu; en iyi ihtimalle çok iyi bir tahmin.
AI video klipleri neden kısa?
Resmî kaynaklarda bunun tek bir cümlelik açıklaması yok; ama rakamlar ipucu veriyor. Movie Gen makalesi, modelin bağlamının en çok 73 bin video jetonu olduğunu, bunun saniyede 16 kareyle yaklaşık 16 saniyeye denk geldiğini yazıyor. Google'ın Veo sayfasındaki karşılaştırma notu da Veo videolarının 8 saniye uzunluğunda olduğunu belirtiyor. Genel bilgi olarak, her ek saniye hem işlenecek jeton sayısını hem bellek ve hesaplama maliyetini artırıyor; dikkat mekanizmasında maliyet dizi uzadıkça hızla büyüyor. Hatalar da uzadıkça birikiyor: ilk saniyede doğru olan yüz, on saniye sonra sürüklenebiliyor.
Daha uzun sahne için yaygın çözüm, mevcut klibi devam ettirmek. Ho ve arkadaşlarının koşullu örneklemesi, önceki parçaya bağlanarak videoyu zamanda uzatmanın akademik temelini gösteriyor; Veo sayfası da kliplerin sahne uzatma özelliğiyle uzatılabildiğini söylüyor. Pratikte bu, birkaç kısa klibi art arda üretip montajlamak anlamına geliyor.
Metinden video ile fotoğraftan video arasındaki fark
| Girdi | Model ne yapar? | Güçlü yanı | Dikkat |
|---|---|---|---|
| Yalnız metin | Sahneyi, kişiyi ve hareketi sıfırdan kurar | Serbest yaratıcılık | Kompozisyon ve karakter tahmin edilmesi zor |
| Fotoğraf (+ metin) | Verdiğin kareyi başlangıç alır, hareketi ekler | Görünüm sabit kalır, kontrol artar | Fotoğrafın dışındaki yeni alanları model uydurur |
| İlk ve son kare | İki kare arasındaki geçişi üretir | Başlangıç ve bitişi sen belirlersin | Her model desteklemez |
Stable Video Diffusion makalesi, temel modelin güçlü bir hareket temsili öğrendiğini ve bunun fotoğraftan videoya gibi alt görevlere uyarlanabildiğini söylüyor. Veo sayfası ise metinden videonun yanında fotoğraftan video, ilk ve son kare ile referans görsel girdilerini sayıyor. Yani fotoğraf girdisi, modele “nasıl görünsün” sorusunun cevabını veriyor; metin ise “ne olsun” kısmını.
Eğitim verisi neden bu kadar önemli?
Stable Video Diffusion makalesi, video modelleri eğitmenin üç aşamasını sayıyor: metinden görsel ön eğitimi, video ön eğitimi ve yüksek kaliteli videoyla ince ayar. Yazarlar iyi bir model için iyi seçilmiş bir ön eğitim veri kümesinin şart olduğunu, altyazılama ve filtrelemenin bu sürecin parçası olduğunu belirtiyor. Sonuç: modelin neyi iyi yaptığı, hangi tür hareketi gördüğüne bağlı. Nadir hareketlerde veya alışılmadık sahnelerde kalite düşüyor.
Sonucu iyileştirmek için ne yapabilirsin?
- Tek bir hareket iste: “Kadın döner, gülümser, el sallar ve uzaklaşır” yerine tek eylem seç.
- Kamerayı adlandır: sabit çekim, yavaş yaklaşma, yandan takip gibi.
- Başlangıç karesini sen ver: tutarlılık önemliyse fotoğraftan video modunu dene.
- Kısa üret, sonra birleştir: uzun tek istek yerine kontrollü kısa klipler.
- Birkaç deneme yap: aynı istekten çıkan sonuçlar farklılaşır.
Örnek istek: Sabit kamera, akşam ışığında bir sahil kenarında yürüyen kırmızı ceketli kadın, rüzgârda saçları hafifçe savruluyor, yavaş ve doğal tempo.
Ses ve kamera hareketi nasıl işin içine giriyor?
Bazı modeller yalnız görüntü değil, ses de üretiyor. Movie Gen makalesi 1080p HD videonun yanında senkron ses ürettiğini söylüyor; Veo sayfası da sesin yerel olarak üretildiğini, ses efektleri, ortam sesi ve diyalog eklenebildiğini belirtiyor. Ses, görüntüyle birlikte planlandığı için dudak hareketi ve olay anı uyumu, ayrı bir ses eklemeye göre daha kolay kurulabiliyor. Yine de sayfa, tutarlı konuşmanın hâlâ gelişen bir alan olduğunu açıkça yazıyor.
Kamera hareketi için ise Stable Video Diffusion makalesi ilginç bir ayrıntı veriyor: temel model, kameraya özgü hareketler için eğitilmiş küçük LoRA modüllerine uyarlanabiliyor. Yani “yavaş yaklaşma” ya da “yandan kayma” gibi hareketler, modelin öğrenebildiği ayrı bir beceri. Bu yüzden istekte kamerayı açıkça adlandırmak, modelin bu beceriyi devreye sokmasına yardım ediyor.
Sık yapılan hatalar
- Tek istekte çok eylem yazmak: Model hareketleri karıştırır veya atlar.
- Kamera hareketini belirtmemek: Model rastgele bir kamera seçer.
- Metne mükemmel fizik beklemek: Sonucu hep kare kare izle.
- Uzun klibi tek seferde istemek: Süre arttıkça tutarlılık düşer.
- Konuşmayı garanti saymak: Veo sayfası, tutarlı konuşma sesinin özellikle kısa parçalarda hâlâ gelişen bir alan olduğunu söylüyor.
- Üretimi gerçek sanmak veya etiketsiz paylaşmak: Veo gibi bazı sistemler çıktıyı SynthID ile işaretlediğini belirtiyor; paylaşırken yapay olduğunu sen de belirt.
Özet
- Video modelleri kareleri birlikte, zamanı da hesaba katarak üretir; temelinde difüzyon ve çoğunda transformer var.
- Kareler arası tutarlılık hedeflenen şey, garanti edilen değil.
- Süre kısıtı hesaplama maliyeti ve hata birikiminden gelir; uzun sahne, klipleri uzatarak veya birleştirerek kurulur.
- Metin neyin olacağını, fotoğraf nasıl görüneceğini belirler; ilk-son kare ikisini bağlar.
- Tek hareket, net kamera ve birkaç deneme çoğu zaman en iyi sonucu verir.
Sık sorulan sorular
AI video modeli her kareyi ayrı resim gibi mi çiziyor?
Hayır. Video difüzyon makalesi yaklaşımı görsel difüzyonun uzantısı olarak tanımlıyor ve kareleri birlikte işliyor. Böylece kareler arasında tutarlılık sağlanmaya çalışılıyor, ama bu garanti edilmiyor.
Videolar neden genelde birkaç saniyelik?
Resmî kaynaklar tek bir neden yazmıyor. Movie Gen makalesi bağlamın yaklaşık 16 saniyeye denk gelen 73 bin jetonla sınırlı olduğunu, Veo sayfası ise Veo videolarının 8 saniye uzunluğunda olduğunu belirtiyor. Genel olarak süre uzadıkça hesaplama maliyeti ve hata birikimi artıyor.
Daha uzun video nasıl elde edilir?
Yaygın yol, mevcut klibi devam ettirmek veya kısa klipleri art arda üretip birleştirmek. Veo sayfası kliplerin sahne uzatma özelliğiyle uzatılabildiğini söylüyor.
Fotoğraftan video mu daha iyi, metinden video mu?
Görünümün sabit kalması önemliyse fotoğraftan video genellikle daha kontrollüdür, çünkü başlangıç karesini sen verirsin. Serbest bir sahne istiyorsan metinden video yeterlidir.
Sora raporundaki modelin her sistemde aynı olduğu söylenebilir mi?
Hayır. Rapor bir yöntemi ve nitel sonuçları anlatıyor, model ayrıntılarını paylaşmıyor. Zaman-uzay yamalarıyla çalışan transformer, yaygın bir yaklaşım olsa da her sistemin içi aynı değildir.
Kaynaklar
- Ho ve ark.: Video Diffusion Models (arXiv:2204.03458)
- Ho ve ark.: Imagen Video: High Definition Video Generation with Diffusion Models
- Blattmann ve ark.: Stable Video Diffusion (arXiv:2311.15127)
- Meta: Movie Gen: A Cast of Media Foundation Models (arXiv:2410.13720)
- OpenAI: Video generation models as world simulators
- Google DeepMind: Veo
İlgili yazılar
Rehberler
AI görsel üretimi nasıl çalışır? Difüzyona sade giriş
Yapay zekâ görselleri bir arşivden kesip biçmez: rastgele gürültüyle başlar ve onu adım adım temizler. Difüzyonun mantığını, promptun bu süreçteki yerini ve ayarların neyi değiştirdiğini öğren.
8 dk okuma
Rehberler
AI üretim maliyeti: jeton ve kredi sistemleri nasıl işler?
AI araçları üretimi jeton ya da krediyle fiyatlıyor, çünkü her üretim gerçek hesaplama demek. Maliyeti çözünürlük, süre ve model belirliyor; daha az harcamanın yollarını da topladık.
5 dk okuma
Rehberler
Tarayıcıda mı, uygulamada mı? AI aracı seçerken bakılacaklar
Tarayıcı geniş ekranda ayrıntılı iş, uygulama telefondan hızlı üretim için daha rahat. Ekran, yükleme, gizlilik, ödeme, bildirim ve çevrimdışı farklarını ve doğru seçimi anlattık.
5 dk okuma