أدلة
كيف يعمل توليد الصور بالذكاء الاصطناعي؟ مدخل مبسّط إلى الانتشار
نماذج الصور بالذكاء الاصطناعي لا تقتطع صورها من أرشيف، بل تبدأ من ضوضاء عشوائية وتنقّيها خطوة بعد خطوة. شرحنا منطق الانتشار، ودور الموجّه في العملية، وما الذي تغيّره كل إعدادات.
فريق Zling AI8 دقائق للقراءة
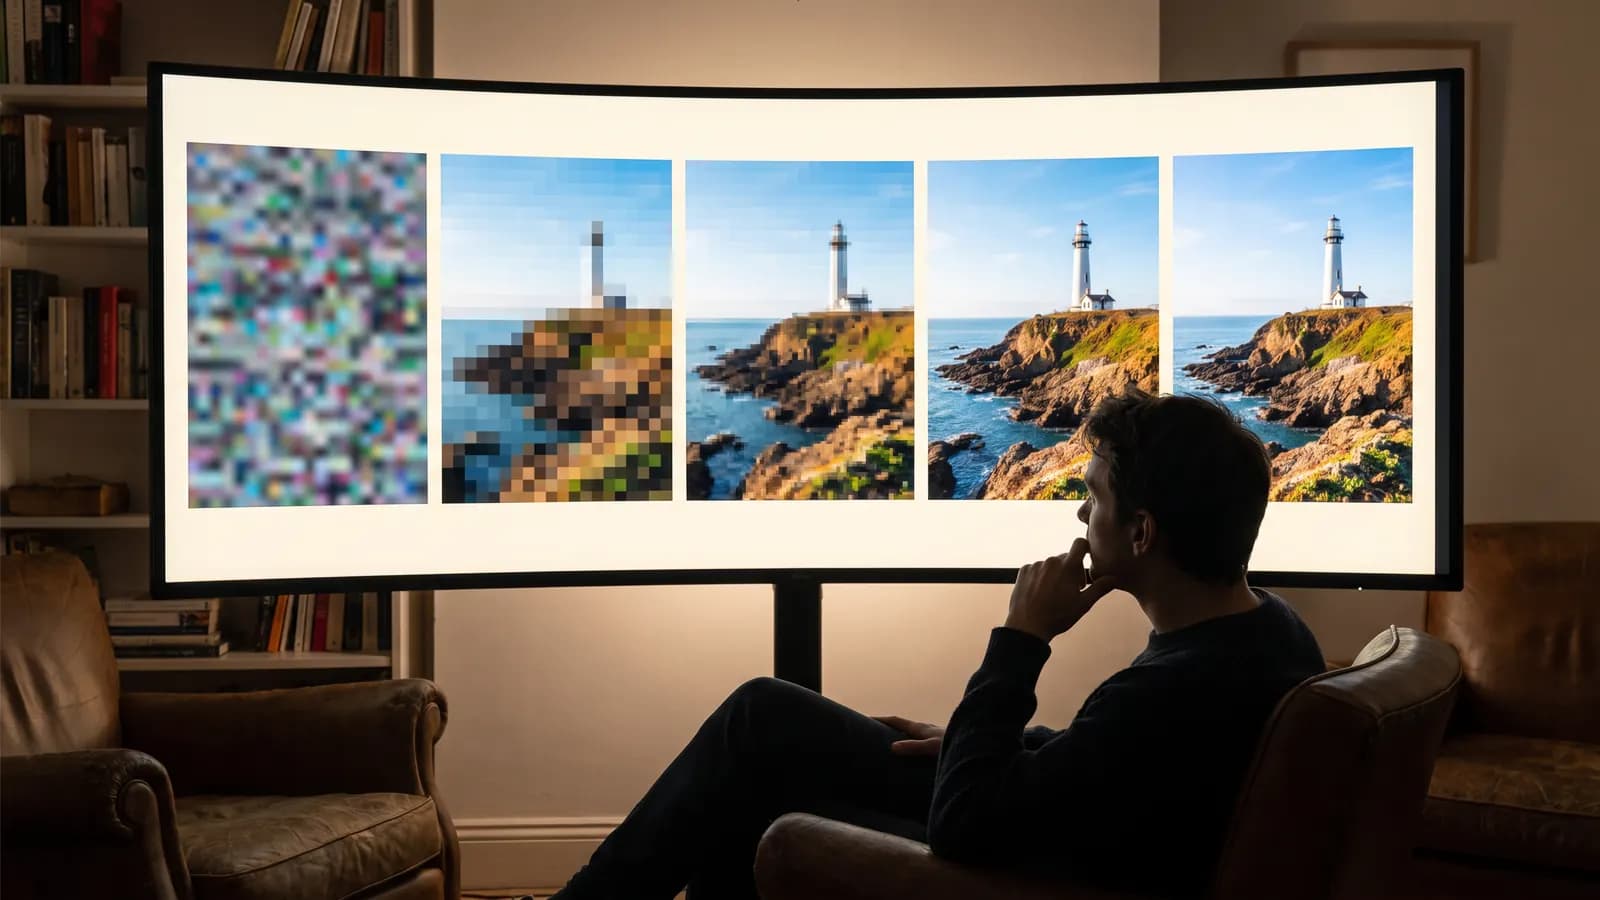
الجواب المختصر: معظم نماذج الصور بالذكاء الاصطناعي الحالية تعمل بطريقة تُسمى الانتشار (diffusion). يبدأ النموذج بشاشة «ثلج» مكوّنة من ضوضاء عشوائية، ثم ينقّي هذه الضوضاء على عشرات الخطوات بالاستناد إلى الجملة التي كتبتها؛ وفي كل خطوة تزداد الصورة وضوحًا. في هذه المقالة نشرح كيف تسير العملية، وأين يدخل الموجّه، وما الذي تغيّره الإعدادات فعليًا، دون الغرق في المصطلحات.
كيف يعمل توليد الصور بالذكاء الاصطناعي باختصار؟
يتكون نظام توليد الصور من النص من ثلاثة أجزاء تعمل معًا:
- مُرمِّز النص: يحوّل الموجّه الذي كتبته إلى تمثيل عددي يستطيع النموذج معالجته.
- شبكة إزالة الضوضاء: تنظر إلى صورة مليئة بالضوضاء وتخمّن الضوضاء الموجودة فيها. وهنا يكمن العبء الأكبر من العمل.
- المُفكّك: يحوّل النتيجة التي أنتجها النموذج في فضاء مضغوط إلى البكسلات التي تراها على الشاشة.
أثناء التوليد تعمل شبكة إزالة الضوضاء على الصورة نفسها مرات عديدة. في كل جولة تنظر إلى المعلومات القادمة من مُرمِّز النص، وتقرّب الصورة قليلًا من موجّهك. والنتيجة ليست صورة جاهزة سُحبت من أرشيف، بل صورة جديدة تُحسب خطوة بخطوة في تلك اللحظة.
ما الانتشار؟ الطريق من الضوضاء إلى الصورة
ظهرت فكرة الانتشار عام 2015 في ورقة بحثية لـ Jascha Sohl-Dickstein وزملائه: عرّف عملية تُفسد بنية البيانات تدريجيًا، ثم تعلّم عكس هذه العملية. وأصبحت هذه الطريقة لافتة في جودة الصور عام 2020 بعد ورقة Denoising Diffusion Probabilistic Models (DDPM) لـ Jonathan Ho و Ajay Jain و Pieter Abbeel.
التدريب: تعلّم إفساد الصورة ثم إصلاحها
في التدريب تُعرض على النموذج صور حقيقية، لكن ليس في أفضل حالاتها. فكل صورة تُضاف إليها ضوضاء عشوائية (غاوسية) على خطوات صغيرة. وفي ورقة DDPM ضُبطت عملية الإفساد على 1000 خطوة؛ وعند الخطوة الأخيرة لا يبقى من الصورة تقريبًا سوى ضوضاء خالصة. ومهمة النموذج بسيطة بشكل مدهش: أن ينظر إلى صورة مليئة بالضوضاء في أي خطوة، ويخمّن الضوضاء التي أُضيفت إليها. وبتكرار هذا التخمين على عدد هائل من الأمثلة يتعلم النموذج بشكل غير مباشر كيف تبدو الصورة الحقيقية.
التوليد: البدء من ضوضاء خالصة
عند توليد صورة تسير العملية بالعكس. يبدأ النموذج من ضوضاء خالصة، ويخمّن الضوضاء الموجودة فيها، ويزيل جزءًا منها. والصورة الناتجة، وهي أكثر انتظامًا قليلًا، تصبح مدخل الخطوة التالية. في الخطوات الأولى تظهر بقع ألوان خشنة وتكوين عام، وفي الخطوات الوسطى تتشكل الأشكال، وفي الخطوات الأخيرة تتضح التفاصيل الدقيقة كالملمس والحواف والضوء. ويمكنك أن تتخيل نحّاتًا يبدأ بالخطوط الكبيرة ثم ينحت التفاصيل الصغيرة.
لا يقتطع النموذج الصور من قاعدة بيانات ويلصقها، بل يتعلم أنماطًا عامة من الأمثلة التي رآها، ويحسب في كل توليد صورة جديدة. ومع ذلك أظهر باحثون أن بعض الصور في بيانات التدريب يمكن إعادة إنتاجها تقريبًا كما هي. لذلك فإن تجنب الموجّهات التي تحاول تقليد عمل معروف أو شخص بعينه بشكل حرفي عادة جيدة.
كيف يفهم النموذج ما كتبته؟
أثناء إزالة الضوضاء تحدد الموجّهات الاتجاه الذي ستسير إليه الصورة. ولذلك يمر النص أولًا عبر مُرمِّز نص. ومن الخطوات المهمة في هذا المجال نموذج CLIP الذي نُشر عام 2021: دُرّب على 400 مليون زوج من الصورة والنص جُمعت من الإنترنت، ليتوقع أي وصف ينتمي إلى أي صورة. وهكذا التقت الكلمات والمفاهيم البصرية في فضاء عددي واحد.
وقد لاحظ باحثو Google في عمل Imagen أمرًا مثيرًا: استخدام نموذج لغوي كبير دُرّب على النص فقط (T5) كمُرمِّز نص يعطي نتائج جيدة جدًا، وتكبير هذا المُرمِّز يمنح جودة وتطابقًا بين النص والصورة أكثر من تكبير الجزء الذي ينتج الصورة. وهذا أحد أسباب فهم النماذج الحديثة للموجّهات الطويلة والمفصّلة بشكل أفضل.
الرابط بين النص والصورة في معظم النماذج يُبنى بطبقات الانتباه المتقاطع (cross-attention): تحسب كل منطقة من الصورة، في كل خطوة، الكلمات التي ينبغي أن «تنظر» إليها من الموجّه. فحين تكتب «امرأة ترتدي مظلة حمراء» يكون انتقال اللون الأحمر إلى المظلة هو عمل هذا الربط. والربط ليس مثاليًا؛ لذلك نرى أحيانًا أن لونًا أو صفة تنتقل إلى عنصر خاطئ.
لماذا لا تُعالج البكسلات مباشرة؟ الفضاء الكامن (latent)
معالجة صورة بكسلًا بكسل عبر عشرات الخطوات مكلفة جدًا. ورقة Latent Diffusion Models لـ Robin Rombach وفريقه (CVPR 2022) عمّمت الحل: يحوّل مُشفِّر تلقائي الصورة أولًا إلى تمثيل مضغوط أصغر بكثير (latent)، ثم يعمل الانتشار على هذا التمثيل الصغير، وفي النهاية يفكّ المُفكّك النتيجة إلى صورة بالحجم الكامل.
مثال ملموس: في مسار Stable Diffusion الموصوف في وثائق diffusers من Hugging Face، تُعالج صورة 512×512 بكسل كتمثيل كامن بحجم 64×64، إذ يُقلَّص كل ضلع ثماني مرات. وبهذا ينخفض العبء الحسابي بشكل كبير. ومعظم النماذج التي تستخدمها اليوم تستند إلى مشتق لهذه الفكرة.
ما فائدة الإعدادات غير الموجّه؟
معظم الإعدادات التي تراها في شاشات التوليد تتحكم مباشرة في جزء من العملية السابقة. لا يعرض كل نموذج كل هذه الإعدادات، لكن معرفة وظيفتها تساعدك على قراءة النتيجة وتصحيحها.
| الإعداد | الجزء من العملية | الأثر العملي |
|---|---|---|
| Seed (البذرة) | الضوضاء العشوائية الأولى | بالبذرة والموجّه والإعدادات نفسها يُنتج عادةً النتيجة نفسها أو شبيهة جدًا |
| عدد الخطوات | عدد جولات إزالة الضوضاء | عدد قليل جدًا من الخطوات ينتج صورة لم تكتمل، وبعد نقطة معينة يقل الفرق ويطول الوقت |
| مقياس التوجيه (CFG) | وزن الموجّه في كل خطوة | كلما ارتفع يلتزم الناتج بالموجّه أكثر، ويقل التنوع، والقيم المبالغ فيها قد تعطي مظهرًا مصطنعًا |
| الموجّه السلبي | المفاهيم التي يُطلب من النموذج الابتعاد عنها | يساعد على تقليل صفات غير مرغوبة مثل «غير واضح» أو «تفاصيل قليلة» |
| القوة (strength) | كمية الضوضاء المضافة إلى الصورة المرجعية | القيمة المنخفضة تبقي الصورة قريبة من الأصل، والعالية تسمح بتفسيرات أحر |
| نسبة الأبعاد | حجم الضوضاء الابتدائية | تحدد التكوين؛ الكادر العمودي يناسب البورتريه، والأفقي يناسب المناظر الطبيعية |
لماذا يوجد مقياس التوجيه؟
وصف عمل Jonathan Ho و Tim Salimans بعنوان Classifier-Free Diffusion Guidance الطريقة المستخدمة اليوم في كثير من النماذج. أثناء التدريب يُترك الموجّه فارغًا أحيانًا عن قصد، فيتعلم النموذج التنبؤ بالموجّه وبدونه. وفي التوليد تُضخَّم الفروق بين التنبؤين، فتُدفع الصورة نحو الموجّه. وتفسّر الورقة لماذا هذا الإعداد توازن: كلما زاد التوجيه تحسّن التطابق مع الموجّه في كل صورة على حدة، لكن التنوع يقل. وتذكر ورقة Imagen أيضًا أن قيم التوجيه المرتفعة جدًا قد تؤدي إلى صور مشبعة بالألوان بشكل مفرط وغير طبيعية.
لماذا يعطي الـseed النتيجة نفسها؟
الـseed هو القيمة الابتدائية لمولّد الأعداد العشوائية الذي ينتج ضوضاء البداية. فالبذرة نفسها تنتج الضوضاء نفسها، والضوضاء نفسها تسلك المسار نفسه مع الموجّه والإعدادات نفسها. لذلك فإن تثبيت الـseed وتغيير كلمة واحدة في الموجّه هو أنظف طريقة لترى أثر تلك الكلمة. ملاحظة صغيرة: كما تذكر وثائق diffusers، قد لا تضمن البذرة نفسها النتيجة نفسها بالضبط على عتاد أو إصدار برمجي مختلف.
كيف يعمل التوليد من صورة (image-to-image)؟
عندما ترفع صورة وتقول «حوّلها إلى لوحة بالألوان المائية»، لا تبدأ العملية من ضوضاء خالصة. تُحوَّل الصورة نفسها إلى الفضاء الكامن، ثم تُضاف إليها كمية من الضوضاء، وتبدأ إزالة الضوضاء من هذه الحالة المشوّشة جزئيًا. وقد وُصفت هذه الفكرة عام 2021 في ورقة SDEdit: كلما زادت الضوضاء المضافة صار الناتج أكثر حرية، وكلما قلّت بقي أقرب إلى الصورة الأصلية.
يوضح مثال في وثائق diffusers ذلك بالأرقام: في إعداد من 50 خطوة، إذا كانت القوة 0,8 تُضاف إلى الصورة ضوضاء لـ40 خطوة وتُنقّى خلال 40 خطوة. وكلما اقتربت القوة من 1,0 تُتجاهل الصورة تقريبًا. إذا أردت الحفاظ على وجه أو ملابس أو منتج فابدأ بقوة منخفضة أو متوسطة، وإذا أردت تغيير المشهد من جذوره فارفع القوة.
ماذا تغيّر في النماذج الجديدة؟
رغم بقاء الفكرة الأساسية كما هي، تتغير العمارة بسرعة:
- العمود الفقري من نوع Transformer: كانت النماذج الأولى تستخدم شبكة التفاف تُسمى U-Net. وبيّنت دراسة Diffusion Transformers (DiT) لـ William Peebles و Saining Xie أن محوّل Transformer يعمل على أجزاء من التمثيل الكامن يتحسن بانتظام مع زيادة القدرة الحسابية.
- التدفق المصحَّح (Rectified flow): جرّبت ورقة Patrick Esser وفريقه عام 2024 نهج «التدفق المصحَّح» الذي يربط الضوضاء بالبيانات بخط مستقيم، على نطاق واسع. ويذكر المؤلفون أن معماريات Transformer التي تستخدم أوزانًا منفصلة للنص والصورة حسّنت فهم الموجّهات والكتابة داخل الصورة (التيبوغرافيا).
- خطوات أقل: سمحت طرق أخذ العينات مثل DDIM بالحصول على عينات أسرع بـ10 إلى 50 مرة من النموذج نفسه دون إعادة تدريبه. وهي من الأسلاف لطرق تهدف إلى نتائج جيدة بعدد أقل من الخطوات.
- ما بعد الانتشار: ليست كل نماذج الصور انتشارية. وأعلنت OpenAI أن توليد الصور المدمج في GPT-4o نموذج انحداري ذاتي (autoregressive)، على خلاف DALL·E الذي يعتمد على نموذج انتشار.
كيف تفيدك هذه المعرفة في كتابة الموجّه؟
معرفة منطق الانتشار تساعدك على بناء موجّهك بوعي أكبر. فالنموذج يحدد التكوين في الخطوات الأولى والتفاصيل في الخطوات الأخيرة، لذلك ينبغي أن يصف موجّهك الصورة الكبيرة والتفصيل معًا. يمكنك تجربة هذا الترتيب:
- الموضوع: ماذا تريد أن ترى؟ اختر عنصرًا رئيسيًا واحدًا.
- المكان والضوء: أين، وفي أي وقت من اليوم، وبأي ضوء؟
- الكادر: لقطة قريبة أم زاوية واسعة أم من الأعلى؟
- الأسلوب: صورة فوتوغرافية، أو ألوان مائية، أو رسم ثلاثي الأبعاد، أو فيلم قديم...
- التفاصيل: لوحة الألوان والملمس والمواد.
موجّه ضعيف:
مقهى جميل
موجّه أقوى:
مقهى حي صغير في ضوء الصباح، فنجان شاي يتصاعد منه البخار عند نافذة، طاولة خشبية، ألوان دافئة، زاوية واسعة، بأسلوب التصوير الوثائقي
في الموجّه الثاني تقل المساحة التي يضطر النموذج فيها إلى التخمين: الضوء والكادر والأسلوب محددة، فيدفع التوجيه في كل خطوة نحو الاتجاه نفسه. وإذا لم تعجبك النتيجة فثبّت الـseed وغيّر شيئًا واحدًا فقط: أولًا الضوء، ثم الكادر. بهذه الطريقة ترى أي كلمة غيّرت أي شيء.
أخطاء شائعة
- طلبات متناقضة: عبارات مثل «بسيط جدًا لكن مليء بالتفاصيل» تشد النموذج في اتجاهين.
- قوائم طويلة مفصولة بفواصل: الكلمات الثانوية تُضعف وزن الكلمات المهمة؛ اكتب الفكرة الرئيسية أولًا.
- كتابة النفي داخل الموجّه الأساسي: كثير من النماذج لا تفهم الجمل السلبية جيدًا، وقول «لا تضع قبعة» قد يستحضر القبعة في الذهن. إذا كان النموذج يدعم ذلك فاكتب هذا في الموجّه السلبي.
- تغيير كل شيء في كل محاولة: المقارنات التي لا تثبت البذرة والإعدادات مضللة.
- توقع الكمال في النص داخل الصورة: النماذج الجديدة أفضل بكثير في الكتابة، لكن أخطاء الحروف في النصوص الطويلة ما زالت تظهر. إذا أردت نصًا في الصورة فاجعله قصيرًا.
الخلاصة
- معظم نماذج الصور تعمل بالانتشار: تبدأ من ضوضاء خالصة وتنقّيها خطوة بخطوة.
- يتعلم النموذج في التدريب تخمين الضوضاء، وينتج في كل توليد صورة جديدة.
- يوجّه الموجّه إزالة الضوضاء في كل خطوة عبر مُرمِّز النص والانتباه المتقاطع.
- الفضاء الكامن يجعل الحساب ممكنًا على تمثيل صغير، والنتيجة تُفكّ إلى بكسلات في النهاية.
- البذرة تحدد الضوضاء الابتدائية، ومقياس التوجيه وزن الموجّه، والقوة مدى الوفاء للصورة الأصلية.
- لنتيجة جيدة صِف الموضوع والضوء والكادر والأسلوب بوضوح، وغيّر في كل مرة شيئًا واحدًا.
الأسئلة الشائعة
هل تنسخ نماذج الصور بالذكاء الاصطناعي صورًا من الإنترنت؟
بشكل عام لا: يتعلم النموذج أنماطًا من الأمثلة التي رآها، ويحسب في كل توليد صورة جديدة خطوة بخطوة. لكن باحثين أظهروا أن بعض الصور في بيانات التدريب يمكن إعادة إنتاجها تقريبًا كما هي، بينها صور لأشخاص وشعارات، وأكثر من ألف مثال. لذلك فإن تجنب الموجّهات التي تقلد عملًا معروفًا أو شخصًا بعينه بشكل حرفي عادة جيدة.
لماذا تختلف الصورة في كل مرة مع الموجّه نفسه؟
لأن كل توليد يبدأ من ضوضاء عشوائية مختلفة. إذا ثبّتّ الـseed تثبت الضوضاء الابتدائية، وبالإعدادات نفسها تحصل غالبًا على النتيجة نفسها أو شبيهة جدًا؛ ومع ذلك قد تظهر فروق صغيرة باختلاف العتاد أو الإصدار البرمجي.
هل زيادة عدد الخطوات تحسّن الصورة دائمًا؟
لا. عدد قليل جدًا من الخطوات ينتج صورة غير مكتملة، لكن بعد نقطة معينة لا تُحدث الخطوات الإضافية فرقًا واضحًا، بل تطيل المدة فقط. وقد طُوّرت طرق أخذ العينات مثل DDIM أصلًا لتحقيق نتائج جيدة بخطوات أقل.
هل يجب أن أرفع مقياس التوجيه (CFG) إلى أقصى حد؟
عادةً لا. القيم المرتفعة تربط الناتج بالموجّه بقوة أكبر لكنها تقلل التنوع، والقيم المرتفعة جدًا قد تنتج صورًا مشبعة بالألوان بشكل مفرط وغير طبيعية. ابدأ بالقيمة الافتراضية للنموذج وغيّرها بخطوات صغيرة.
كيف أحافظ على ملامح الوجه عند التوليد من صورة؟
اخفض إعداد القوة (strength) الذي يحدد كمية الضوضاء المضافة إلى الصورة، واكتب في الموجّه ما تريد تغييره فقط. كلما ارتفعت القوة فسّر النموذج الصورة بحرية أكبر، وقد تتغير ملامح الوجه.
المصادر
- Sohl-Dickstein et al. (2015), Deep Unsupervised Learning using Nonequilibrium Thermodynamics
- Ho, Jain, Abbeel (2020), Denoising Diffusion Probabilistic Models
- Song, Meng, Ermon (2020), Denoising Diffusion Implicit Models
- Radford et al. (2021), Learning Transferable Visual Models From Natural Language Supervision (CLIP)
- Meng et al. (2021), SDEdit: Guided Image Synthesis and Editing with Stochastic Differential Equations
- Rombach et al. (2022), High-Resolution Image Synthesis with Latent Diffusion Models
- Saharia et al. (2022), Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding (Imagen)
- Ho, Salimans (2022), Classifier-Free Diffusion Guidance
- Peebles, Xie (2022), Scalable Diffusion Models with Transformers
- Carlini et al. (2023), Extracting Training Data from Diffusion Models
- Esser et al. (2024), Scaling Rectified Flow Transformers for High-Resolution Image Synthesis
- OpenAI (2025), Addendum to GPT-4o System Card: Native image generation
- Hugging Face Diffusers: Understanding pipelines, models and schedulers
- Hugging Face Diffusers: Image-to-image
- Hugging Face Diffusers: Reproducibility
مقالات ذات صلة
أدلة
كيف يعمل توليد الفيديو بالذكاء الاصطناعي؟ الفكرة وراء الحركة
نموذج الفيديو بالذكاء الاصطناعي لا يرسم الإطارات واحدًا تلو الآخر، بل يبني الحركة ككل. شرحنا كيف امتد الانتشار إلى الزمن، ولماذا تبقى المقاطع قصيرة، والفرق بين النص والصورة مدخلًا.
6 دقائق للقراءة
أدلة
تكلفة توليد الذكاء الاصطناعي: كيف تعمل أنظمة الرموز والاعتمادات؟
تُسعّر أدوات الذكاء الاصطناعي التوليد بالرموز أو الاعتمادات، لأن كل عملية توليد تعني حسابًا فعليًا. تحدد التكلفة الدقة والمدة والنموذج، وقد جمعنا طرق الإنفاق الأقل.
6 دقائق للقراءة
أدلة
المتصفح أم التطبيق؟ معايير اختيار أداة الذكاء الاصطناعي
المتصفح أريح للعمل التفصيلي على شاشة كبيرة، والتطبيق أسرع للتجربة السريعة من الهاتف. شرحنا الفروق في الشاشة والرفع والخصوصية والدفع والإشعارات والعمل دون اتصال، وكيف تختار.
6 دقائق للقراءة