أدلة
كيف يعمل توليد الفيديو بالذكاء الاصطناعي؟ الفكرة وراء الحركة
نموذج الفيديو بالذكاء الاصطناعي لا يرسم الإطارات واحدًا تلو الآخر، بل يبني الحركة ككل. شرحنا كيف امتد الانتشار إلى الزمن، ولماذا تبقى المقاطع قصيرة، والفرق بين النص والصورة مدخلًا.
فريق Zling AI6 دقائق للقراءة
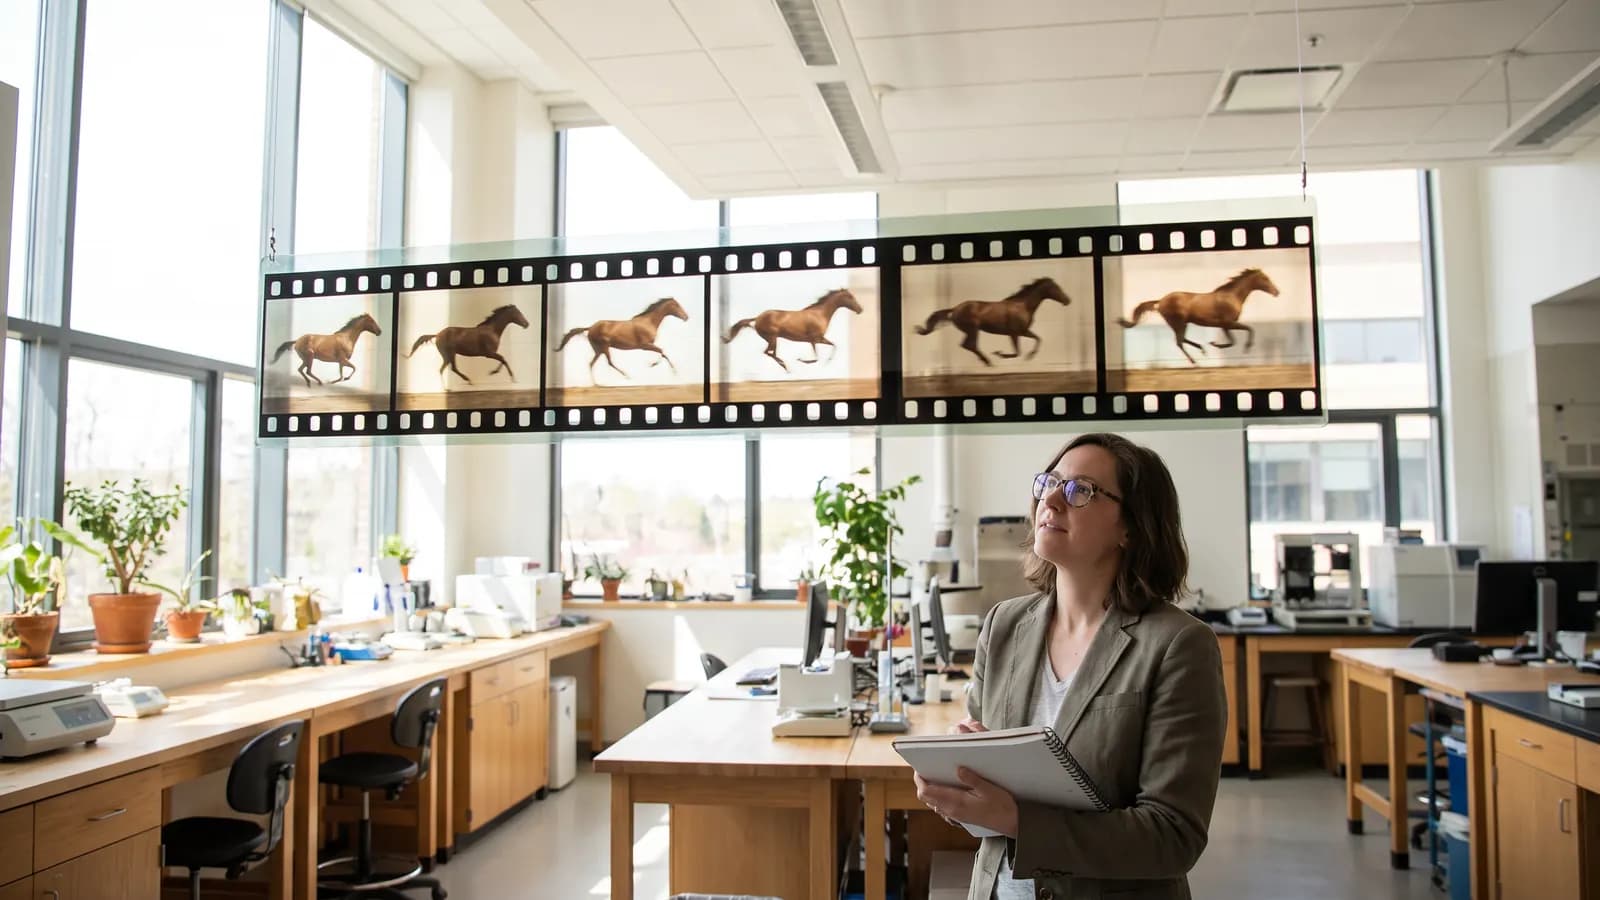
الجواب المختصر: نموذج الفيديو بالذكاء الاصطناعي لا يرسم الفيديو إطارًا بعد إطار كصور منفصلة؛ بل ينتج الإطارات كحزمة واحدة، مع مراعاة الحركة والزمن معًا. وتبقى الفكرة الأساسية هي الانتشار الذي تستخدمه توليدات الصور، لكن البيانات لم تعد صورة واحدة، بل تسلسلًا من الإطارات ممتدًا عبر الزمن. في هذه المقالة نشرح كيف يتم ذلك، ولماذا تبقى المقاطع قصيرة، والفرق بين الإدخال النصي والإدخال بالصورة، استنادًا إلى ما تقوله الأوراق البحثية المعنية.
ما الفيديو في الحقيقة، وكيف يراه النموذج؟
الفيديو تتابع لعدد معين من الإطارات في الثانية. وبالنسبة إلى النموذج فهو كتلة بيانات لها ارتفاع وعرض ومحور زمني. ولمقدمة مبسطة عن توليد الصور راجع مقالتنا كيف يعمل توليد الصور بالذكاء الاصطناعي؟؛ فمنطق البدء من الضوضاء وتنقيتها خطوة بخطوة يسري هنا أيضًا. الفرق أن الشيء الذي يُنقّى ليس إطارًا واحدًا، بل كتلة كاملة تتضمن العلاقة بين الإطارات.
كيف امتد الانتشار إلى الزمن؟
تصف ورقة Ho وزملائه عن انتشار الفيديو النهج بأنه امتداد طبيعي لبنية الانتشار للصور. وتبرز الورقة أمرين: تدريب النموذج على الصور والفيديوهات معًا يسرّع التدريب ويقلل تباين التدرجات؛ كما أن طريقة أخذ عينات شرطية جديدة تستطيع توسيع الفيديو مكانيًا وزمنيًا. وتعرض الورقة نفسها النتائج الأولى للتوليد النصي للفيديو على نطاق واسع.
أما Imagen Video فيبني سلسلة بدل نموذج عملاق واحد. يعمل أولًا نموذج أساس ينتج فيديو منخفض الدقة، ثم تعمل نماذج الدقة الفائقة المكانية (التي تحسّن وضوح الإطارات) والزمنية (التي تجعل الحركة أكثر سلاسة) بالتناوب لتكبير الناتج. أي أن الدقة والسلاسة تُحلّان في مراحل منفصلة.
النماذج الأحدث: رقع الزمان والمكان
يلخص التقرير التقني لـ Sora من OpenAI الفكرة المشتركة لكثير من الأنظمة اليوم: تُدرَّب نماذج الانتشار المعتمدة على النص على فيديوهات وصور بمدد ودقات ونسب أبعاد مختلفة، ويكون النموذج محوّل Transformer يعمل على رقع زمنية-مكانية من التمثيلات الكامنة (latent) للفيديو والصورة. فشبكة ضغط أولًا تنقل الفيديو إلى فضاء كامن صغير، وتُقطع منه رقع تعمل كـ«رموز» للـTransformer. وفي نهاية التوليد يحوّل مُفكّك التمثيلات الكامنة إلى بكسلات. ويذكر التقرير أن أكبر نموذج فيه ينتج فيديو بطول دقيقة تقريبًا. لكن التقرير نفسه يقدم نتائج وصفية ولا يشارك تفاصيل النموذج.
وتشير ورقة Movie Gen من Meta إلى الاتجاه نفسه: أكبر نموذج فيديو فيها محوّل Transformer بـ30 مليار معامل، ينتج فيديو بدقة 1080p وصوتًا متزامنًا، ويستطيع إنتاج فيديو مخصص انطلاقًا من صورة المستخدم، والتعديل بناءً على تعليمة.
ما التناسق الزمني، ولماذا هو صعب؟
التناسق يعني أن يبقى وجه الشخصية وملابسها والمشهد ثابتة عبر الإطارات، وأن تبدو الحركة منطقية فيزيائيًا. فلو أنتجت الإطارات بشكل مستقل لظهرت فروق صغيرة في كل إطار، فيرتجف الفيديو. والسبب الرئيسي في أن النماذج تعالج الإطارات معًا هو هذا: كل إطار يُنتَج وهو «يرى» ما تحتويه الإطارات المجاورة.
ومع ذلك فالتناسق ليس مضمونًا. ففي الحركات الطويلة أو المعقدة قد يتغير عدد أصابع اليد، وقد تختفي أشياء، وقد يتحول شيء إلى شيء آخر. وهذا نتيجة أن النموذج لا يعرف قوانين الفيزياء، بل يتعلم الأنماط الموجودة في بيانات التدريب؛ وأفضل ما يمكنه تقديمه تنبؤ جيد جدًا.
لماذا تكون مقاطع الذكاء الاصطناعي قصيرة؟
لا يوجد في المصادر الرسمية تفسير واحد من جملة واحدة لذلك، لكن الأرقام تعطي دلالة. تذكر ورقة Movie Gen أن سياق النموذج يبلغ في أقصاه 73 ألف رمز فيديو، وأن ذلك يعادل نحو 16 ثانية بمعدل 16 إطارًا في الثانية. كما تذكر ملاحظة المقارنة في صفحة Veo من Google أن فيديوهات Veo مدتها 8 ثوانٍ. وكمعلومة عامة، كل ثانية إضافية ترفع عدد الرموز التي يجب معالجتها وتكلفة الذاكرة والحوسبة؛ وفي آلية الانتباه تنمو التكلفة بسرعة مع طول التسلسل. كما تتراكم الأخطاء مع الطول: الوجه الصحيح في الثانية الأولى قد ينجرف بعد عشر ثوانٍ.
الحل الشائع للمشهد الأطول هو متابعة المقطع الحالي. وتبيّن الكتابة المشروطة لـ Ho وزملائه الأساس الأكاديمي لتوسيع الفيديو زمنيًا عبر الربط بالجزء السابق، كما تقول صفحة Veo إن المقاطع يمكن توسيعها بميزة تمديد المشهد. وعمليًا هذا يعني توليد عدة مقاطع قصيرة متتالية ثم تركيبها في المونتاج.
الفرق بين الفيديو من النص والفيديو من الصورة
| الإدخال | ماذا يفعل النموذج؟ | ميزته | ما يجب الانتباه إليه |
|---|---|---|---|
| النص وحده | يبني المشهد والشخص والحركة من الصفر | حرية إبداعية | التكوين والشخصية يصعب توقعهما |
| صورة (+ نص) | يتخذ الصورة التي أعطيتها بداية، ويضيف الحركة | المظهر ثابت، والتحكم أكبر | المساحات الجديدة خارج الصورة يخترعها النموذج |
| الإطار الأول والأخير | يولّد الانتقال بين الإطارين | أنت تحدد البداية والنهاية | ليس كل نموذج يدعمه |
تقول ورقة Stable Video Diffusion إن النموذج الأساس يتعلم تمثيلًا قويًا للحركة، ويمكن تكييفه لمهام فرعية مثل التحويل من صورة إلى فيديو. وتعدّ صفحة Veo إلى جانب التوليد من النص، التوليد من الصورة ومن الإطارين الأول والأخير، ومدخلات الصور المرجعية. أي أن إدخال الصورة يجيب عن سؤال «كيف يبدو؟»، بينما يجيب النص عن «ماذا يحدث؟».
لماذا تهم بيانات التدريب كثيرًا؟
تحدد ورقة Stable Video Diffusion ثلاث مراحل لتدريب نماذج الفيديو: تدريب مسبق من النص إلى الصورة، وتدريب مسبق على الفيديو، وضبط دقيق بفيديوهات عالية الجودة. ويؤكد المؤلفون أن النموذج الجيد يحتاج إلى مجموعة بيانات تدريب مسبق مختارة بعناية، وأن وضع التعليقات النصية وتصفية البيانات جزء من هذه العملية. والنتيجة أن ما يجيده النموذج يتوقف على نوع الحركات التي رآها: ففي الحركات النادرة أو المشاهد غير المألوفة تنخفض الجودة.
ماذا تفعل لتحسين النتيجة؟
- اطلب حركة واحدة: بدل «تدور المرأة وتبتسم وتلوّح بيدها ثم تبتعد» اختر فعلًا واحدًا.
- سمِّ الكاميرا: لقطة ثابتة، أو اقتراب بطيء، أو تتبع من الجانب.
- حدد الإطار الأول بنفسك: إذا كان التناسق مهمًا فجرّب وضع توليد الفيديو من صورة.
- أنتج قصيرًا ثم ادمج: مقاطع قصيرة مضبوطة بدل طلب واحد طويل.
- جرّب عدة مرات: الطلب نفسه يعطي نتائج متفاوتة.
مثال للطلب: كاميرا ثابتة، امرأة ترتدي معطفًا أحمر تمشي على الكورنيش في ضوء المساء، يتطاير شعرها قليلًا مع الريح، إيقاع بطيء وطبيعي.
كيف يدخل الصوت وحركة الكاميرا في العمل؟
بعض النماذج لا تنتج الصورة فقط، بل الصوت أيضًا. تقول ورقة Movie Gen إنها تنتج صوتًا متزامنًا مع فيديو بدقة 1080p، وتذكر صفحة Veo أن الصوت يُنتج محليًا، ويمكن إضافة مؤثرات صوتية وصوت محيطي وحوار. ولأن الصوت يُخطط مع الصورة، يكون تطابق حركة الشفاه ولحظة الحدث أسهل في البناء مما لو أضفت صوتًا منفصلًا. ومع ذلك تنص الصفحة على أن الحديث المتسق ما زال مجالًا قيد التطور.
أما حركة الكاميرا فتقدم ورقة Stable Video Diffusion تفصيلًا لافتًا: يمكن تكييف النموذج الأساس بوحدات LoRA صغيرة مدرّبة على حركات كاميرا محددة. أي أن حركات مثل «اقتراب بطيء» أو «انزلاق جانبي» مهارة منفصلة يتعلمها النموذج. لذلك فإن تسمية الكاميرا صراحةً في الطلب تساعد النموذج على تفعيل هذه المهارة.
أخطاء شائعة
- كتابة حركات كثيرة في طلب واحد: يخلط النموذج الحركات أو يتجاهل بعضها.
- عدم تحديد حركة الكاميرا: يختار النموذج كاميرا عشوائية.
- انتظار فيزياء مثالية من النص: شاهد النتيجة إطارًا بإطار دائمًا.
- طلب فيديو طويل دفعة واحدة: كلما طالت المدة قل التناسق.
- افتراض أن الحوار مضمون: تشير صفحة Veo إلى أن الحديث المتسق ما زال مجالًا قيد التطور، خاصة في المقاطع القصيرة.
- نشر الإنتاج كأنه حقيقي دون تعليم: تذكر صفحة Veo أن بعض الأنظمة توسم مخرجاتها بـSynthID، فاذكر أنت أيضًا أن المقطع مولّد عند نشره.
الخلاصة
- نماذج الفيديو تنتج الإطارات معًا وفي الاعتبار الزمن؛ وأساسها غالبًا الانتشار، وفي كثير منها محوّل Transformer.
- التناسق بين الإطارات هدف لا يُضمن.
- تقصر المقاطع بسبب تكلفة الحوسبة وتراكم الأخطاء؛ والمشهد الأطول يُبنى بتوسيع المقطع أو بتركيب مقاطع قصيرة.
- النص يحدد ما الذي سيحدث، والصورة تحدد كيف يبدو، والإطاران الأول والأخير يربطان بينهما.
- حركة واحدة، وكاميرا مسماة، وعدة محاولات غالبًا ما تعطي أفضل نتيجة.
الأسئلة الشائعة
هل ينتج نموذج الفيديو بالذكاء الاصطناعي كل إطار كصورة منفصلة؟
لا. تصف ورقة الانتشار للفيديو النهج بأنه امتداد لانتشار الصور، ويعالج الإطارات معًا. وبذلك يسعى النموذج إلى التناسق بين الإطارات، لكنه لا يضمنه.
لماذا تكون مقاطع الفيديو عادةً قصيرة؟
المصادر الرسمية لا تذكر سببًا واحدًا. تذكر ورقة Movie Gen أن السياق محدود بنحو 73 ألف رمز، أي تقريبًا 16 ثانية، وتذكر صفحة Veo أن فيديوهات Veo مدتها 8 ثوانٍ. وعمومًا كلما طالت المدة زادت التكلفة الحسابية وتراكمت الأخطاء.
كيف أحصل على فيديو أطول؟
الطريقة الشائعة هي متابعة المقطع الحالي، أو توليد مقاطع قصيرة متتالية ثم دمجها. وتذكر صفحة Veo أن المقاطع يمكن توسيعها بميزة تمديد المشهد.
هل الفيديو من صورة أفضل أم من نص؟
إذا كان ثبات المظهر مهمًا فالفيديو من صورة عادةً أكثر تحكمًا، لأنك أنت من يحدد الإطار الأول. أما إذا أردت مشهدًا حرًا فالتوليد من النص يكفي.
هل يعني التقرير التقني لـ Sora أن كل الأنظمة تعمل بالطريقة نفسها؟
لا. يصف التقرير طريقة ونتائج وصفية، ولا يشارك تفاصيل النموذج. والمحوّل الذي يعمل على رقع زمنية-مكانية نهج شائع، لكن داخل كل نظام يختلف الأمر.
المصادر
- Ho ve ark.: Video Diffusion Models (arXiv:2204.03458)
- Ho ve ark.: Imagen Video: High Definition Video Generation with Diffusion Models
- Blattmann ve ark.: Stable Video Diffusion (arXiv:2311.15127)
- Meta: Movie Gen: A Cast of Media Foundation Models (arXiv:2410.13720)
- OpenAI: Video generation models as world simulators
- Google DeepMind: Veo
مقالات ذات صلة
أدلة
كيف يعمل توليد الصور بالذكاء الاصطناعي؟ مدخل مبسّط إلى الانتشار
نماذج الصور بالذكاء الاصطناعي لا تقتطع صورها من أرشيف، بل تبدأ من ضوضاء عشوائية وتنقّيها خطوة بعد خطوة. شرحنا منطق الانتشار، ودور الموجّه في العملية، وما الذي تغيّره كل إعدادات.
8 دقائق للقراءة
أدلة
تكلفة توليد الذكاء الاصطناعي: كيف تعمل أنظمة الرموز والاعتمادات؟
تُسعّر أدوات الذكاء الاصطناعي التوليد بالرموز أو الاعتمادات، لأن كل عملية توليد تعني حسابًا فعليًا. تحدد التكلفة الدقة والمدة والنموذج، وقد جمعنا طرق الإنفاق الأقل.
6 دقائق للقراءة
أدلة
المتصفح أم التطبيق؟ معايير اختيار أداة الذكاء الاصطناعي
المتصفح أريح للعمل التفصيلي على شاشة كبيرة، والتطبيق أسرع للتجربة السريعة من الهاتف. شرحنا الفروق في الشاشة والرفع والخصوصية والدفع والإشعارات والعمل دون اتصال، وكيف تختار.
6 دقائق للقراءة