Guías
¿Cómo genera imágenes la IA? Introducción sencilla a la difusión
La IA no recorta ni pega imágenes de un archivo: empieza con ruido aleatorio y lo limpia paso a paso. Explicamos la lógica de la difusión, el lugar del prompt en ese proceso y qué cambia cada ajuste.
Equipo de Zling AI11 min de lectura
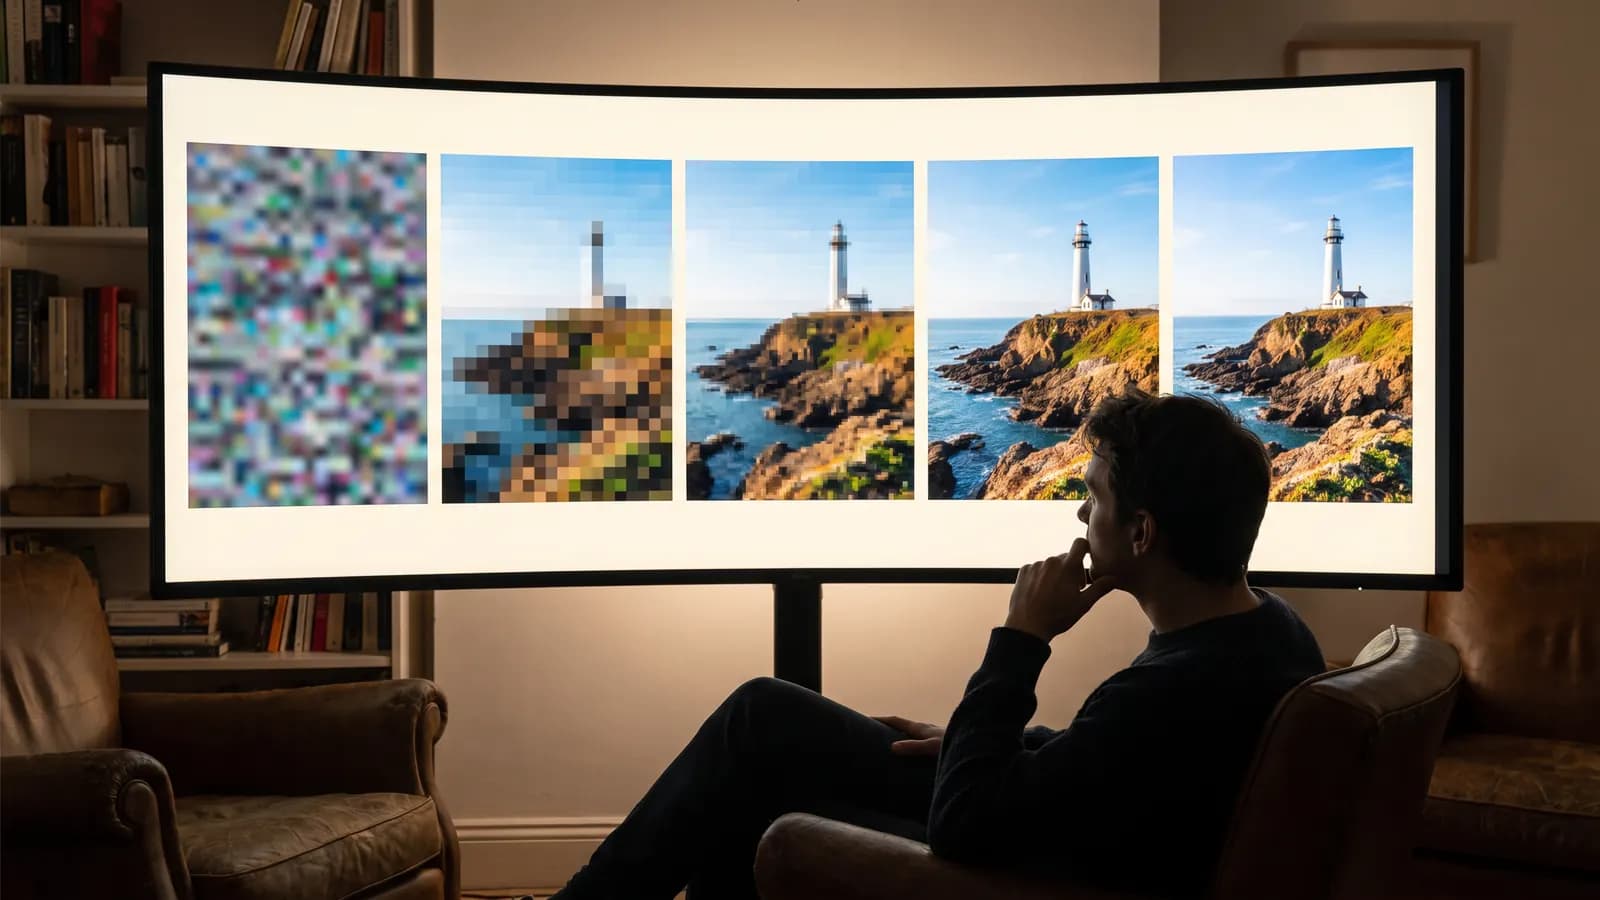
Respuesta corta: la mayoría de los modelos de imagen con IA actuales funcionan con un método llamado difusión. El modelo empieza con una pantalla de «nieve» formada por ruido aleatorio y, mirando la frase que escribiste, limpia ese ruido en decenas de pasos; en cada paso la imagen se vuelve un poco más nítida. En este artículo explicamos cómo funciona el proceso, dónde interviene el prompt y qué cambian realmente los ajustes, sin jerga innecesaria.
¿Cómo funciona a grandes rasgos la generación de imágenes con IA?
Un sistema que genera imágenes a partir de texto tiene tres partes que trabajan juntas:
- Codificador de texto: convierte el prompt que escribiste en una representación numérica que el modelo puede procesar.
- Red de eliminación de ruido: mira una imagen con ruido y predice el ruido que contiene. Aquí está la mayor parte del trabajo.
- Decodificador: convierte el resultado que el modelo produce en un espacio comprimido en los píxeles que ves en pantalla.
Durante la generación, la red de eliminación de ruido trabaja muchas veces sobre la misma imagen. En cada vuelta mira la información que le da el codificador de texto y acerca la imagen a tu prompt un poco más. El resultado no es una imagen existente que se busca y se recupera de un archivo, sino una imagen nueva que se calcula paso a paso en ese momento.
¿Qué es la difusión? El camino del ruido a la imagen
La idea de la difusión apareció en 2015, con el artículo de Jascha Sohl-Dickstein y sus colegas: define un proceso que destruye poco a poco la estructura de los datos y aprende a invertir ese proceso. El método se hizo famoso por su calidad visual en 2020, con el artículo de Jonathan Ho, Ajay Jain y Pieter Abbeel Denoising Diffusion Probabilistic Models (DDPM).
Entrenamiento: aprender a estropear y a reparar una imagen
En el entrenamiento se muestran al modelo imágenes reales, pero no en su versión limpia. A cada imagen se le añade ruido aleatorio (gaussiano) en pequeños pasos. En el artículo de DDPM, este proceso de deterioro se fijó en 1.000 pasos; al llegar al último, de la imagen solo queda ruido casi puro. La tarea del modelo es sorprendentemente sencilla: mirar una imagen con ruido en cualquier paso y predecir el ruido que se le añadió. Al repetir esa predicción con muchísimos ejemplos, el modelo aprende de forma indirecta cómo es una imagen real.
Generación: empezar desde ruido puro
Al generar una imagen, el proceso va en sentido inverso. El modelo parte de ruido puro, predice el ruido que contiene y elimina una parte. La imagen resultante, un poco más ordenada, es la entrada del paso siguiente. En los primeros pasos aparecen manchas de color gruesas y la composición; en los pasos intermedios se asientan las formas; en los últimos se afinan los detalles finos, como la textura, los bordes y la luz. Puedes pensar en un escultor que primero talla las líneas generales y después los detalles.
El modelo no pega fragmentos de una base de datos; aprende patrones generales de los ejemplos que vio en el entrenamiento y calcula una imagen nueva en cada generación. Aun así, los investigadores han mostrado que algunas imágenes del conjunto de entrenamiento pueden reproducirse casi idénticas. Por eso es buena práctica evitar los prompts que intentan imitar al pie de la letra una obra famosa o a una persona concreta.
¿Cómo entiende el modelo la frase que escribiste?
El prompt determina hacia dónde se dirige la eliminación del ruido. Para eso, el texto pasa primero por un codificador de texto. Uno de los pasos importantes en este campo fue CLIP, publicado en 2021: se entrenó con 400 millones de pares de imagen y texto recogidos de internet, para predecir qué descripción corresponde a cada imagen. Así, las palabras y los conceptos visuales acabaron en el mismo espacio numérico.
El trabajo Imagen de Google aportó un hallazgo interesante: usar como codificador de texto un modelo de lenguaje grande entrenado solo con texto (T5) da muy buenos resultados, y ampliar ese codificador mejora la calidad y la coincidencia entre texto e imagen más que ampliar la parte que genera la imagen. Esta es una de las razones por las que los modelos nuevos entienden mejor los prompts largos y detallados.
La conexión entre texto e imagen se construye en la mayoría de los modelos con capas de atención cruzada (cross-attention): en cada paso, cada zona de la imagen calcula a qué palabras del prompt «debe mirar». Cuando escribes «una mujer con un paraguas rojo», que el rojo vaya al paraguas es tarea de esa correspondencia. La correspondencia no es perfecta; por eso se ve a veces un color o una característica que se desplaza al objeto equivocado.
¿Por qué no trabajar directamente con píxeles? El espacio latente
Procesar una imagen píxel a píxel a lo largo de decenas de pasos es muy costoso. El artículo Latent Diffusion Models de Robin Rombach y su equipo (CVPR 2022) popularizó la solución: primero un codificador automático convierte la imagen en una representación mucho más pequeña y comprimida (el latente); la difusión trabaja sobre esa representación pequeña; y al final el decodificador devuelve el resultado a una imagen de tamaño completo.
Un ejemplo concreto: en el flujo de Stable Diffusion que describe la documentación de diffusers de Hugging Face, una imagen de 512×512 píxeles se procesa como un latente de 64×64, con cada lado reducido 8 veces. La carga de cálculo se reduce así de forma notable. La mayoría de los modelos que usas hoy se basan en una variante de esta idea.
¿Para qué sirven los ajustes distintos del prompt?
Muchos de los ajustes que ves en las pantallas de generación controlan directamente una parte del proceso descrito. No todos los modelos muestran los mismos, pero saber qué hacen te ayuda a leer y corregir el resultado.
| Ajuste | Parte del proceso | Efecto práctico |
|---|---|---|
| Semilla (seed) | El ruido aleatorio inicial | Con la misma semilla, prompt y ajustes, suele obtenerse el mismo resultado o uno muy parecido |
| Número de pasos | Número de vueltas de eliminación de ruido | Con muy pocos pasos la imagen queda a medias; a partir de cierto punto la diferencia disminuye y el tiempo aumenta |
| Escala de guía (CFG) | Peso del prompt en cada paso | Al subir, el resultado se ajusta más al prompt pero hay menos variedad; los valores extremos pueden dar un aspecto artificial |
| Prompt negativo | Conceptos de los que el modelo debe alejarse | Ayuda a reducir rasgos no deseados como «borroso» o «poco detalle» |
| Intensidad (strength) | Cantidad de ruido añadida a la foto | Un valor bajo conserva la foto; un valor alto la interpreta con más libertad |
| Proporción | Tamaño del ruido inicial | Determina la composición; el encuadre vertical va bien para retratos y el horizontal para paisajes |
¿Por qué existe la escala de guía?
El estudio Classifier-Free Diffusion Guidance de Jonathan Ho y Tim Salimans describió el método que usan hoy muchos modelos. Durante el entrenamiento, el prompt se deja vacío de forma ocasional; así, el mismo modelo aprende a predecir tanto con prompt como sin él. En la generación se amplifica la diferencia entre las dos predicciones y la imagen se empuja hacia el prompt. El artículo muestra también por qué este ajuste es un equilibrio: al subir la guía, cada imagen se acerca más al prompt, pero la variedad disminuye. El artículo de Imagen señala además que valores de guía muy altos pueden producir imágenes sobresaturadas y poco naturales.
¿Por qué la semilla da el mismo resultado?
La semilla es el valor inicial del generador de números aleatorios que produce el ruido de partida. La misma semilla produce el mismo ruido, y el mismo ruido, con el mismo prompt y los mismos ajustes, sigue el mismo camino. Por eso, fijar la semilla y cambiar una sola palabra del prompt es la forma más limpia de ver el efecto de esa palabra. Una nota: como indica la documentación de diffusers, la misma semilla no garantiza un resultado idéntico en otro hardware o con otra versión del software.
¿Cómo funciona la generación a partir de una foto (image-to-image)?
Cuando subes una foto y pides «conviértela en un cuadro de acuarela», el proceso no empieza desde ruido puro. La foto se convierte en el espacio latente, se le añade una cantidad de ruido y la eliminación del ruido parte de esa versión parcialmente deteriorada. Esta idea se describió en 2021 en el artículo SDEdit: cuanto más ruido se añade, más libre es el resultado; cuanto menos, más fiel es a la foto.
La documentación de diffusers lo muestra con cifras: con 50 pasos y una intensidad de 0,8, se añaden a la foto 40 pasos de ruido y se limpian durante 40 pasos. Cuando la intensidad se acerca a 1,0, la foto prácticamente se ignora. Si quieres conservar el rostro, la prenda o el producto, empieza con una intensidad baja o media; si quieres cambiar la escena por completo, sube la intensidad.
¿Qué ha cambiado en los modelos de nueva generación?
La idea básica sigue igual, pero la arquitectura cambia deprisa:
- Columna vertebral de transformador: los primeros modelos usaban U-Net, una red convolucional. El trabajo Diffusion Transformers (DiT) de William Peebles y Saining Xie mostró que un transformador que trabaja sobre partes del latente mejora de forma regular al aumentar la potencia de cálculo.
- Rectified flow: el artículo de Patrick Esser y su equipo de 2024 probó a gran escala el enfoque de «rectified flow», que une el ruido y los datos con una línea recta. Los autores informan de que las arquitecturas de transformador con pesos separados para el texto y la imagen mejoran la comprensión del prompt y la escritura dentro de la imagen (tipografía).
- Menos pasos: métodos de muestreo como DDIM permiten obtener muestras de 10 a 50 veces más rápido con el mismo modelo, sin cambiar el entrenamiento. Es uno de los antecedentes de los métodos que buscan buenos resultados con pocos pasos.
- Enfoques que no son difusión: no todos los modelos de imagen usan difusión. OpenAI explicó que la generación de imagen integrada en GPT-4o es un modelo autorregresivo, a diferencia de DALL·E, que es un modelo de difusión.
¿Cómo te ayuda esto a escribir prompts?
Conocer la lógica de la difusión te permite construir el prompt con más criterio. Como el modelo define la composición en los primeros pasos y el detalle en los últimos, el prompt debe describir tanto el conjunto como los detalles. Puedes probar este orden:
- Sujeto: ¿qué quieres ver? Elige un elemento principal.
- Entorno y luz: ¿dónde, a qué hora del día, con qué luz?
- Encuadre: ¿primer plano, plano general, cenital?
- Estilo: fotografía, acuarela, render 3D, película antigua...
- Detalle: paleta de colores, textura, material.
Un prompt débil:
un café bonito
Un prompt más sólido:
Una pequeña cafetería de barrio con luz de mañana, una taza de té humeante junto a la ventana, mesa de madera, tonos cálidos, gran angular, estilo de fotografía documental
En el segundo prompt, el espacio que el modelo debe adivinar es menor: la luz, el encuadre y el estilo están definidos, así que la guía empuja en la misma dirección en cada paso. Si el resultado no te convence, fija la semilla y cambia una sola cosa: primero la luz, luego el encuadre. Así verás qué palabra cambia qué.
Errores frecuentes
- Peticiones contradictorias: expresiones como «sencillo pero muy detallado» tiran del modelo en dos direcciones.
- Listas largas separadas por comas: las palabras poco importantes diluyen el peso de las importantes; escribe primero la idea principal.
- Escribir lo negativo en el prompt principal: muchos modelos no entienden bien las frases negativas, y decir «sin sombrero» puede traer el sombrero a la imagen. Si el modelo lo admite, escríbelo en el prompt negativo.
- Cambiarlo todo en cada prueba: las comparaciones sin fijar la semilla y los ajustes son engañosas.
- Esperar perfección en el texto de la imagen: los modelos nuevos escriben mucho mejor, pero en textos largos pueden aparecer errores de letras. Si quieres texto en la imagen, mantenlo corto.
Resumen
- La mayoría de los modelos de imagen con IA usan difusión: empiezan con ruido puro y lo limpian paso a paso.
- El modelo aprende en el entrenamiento a predecir el ruido; en cada generación calcula una imagen nueva.
- El prompt guía la eliminación del ruido en cada paso, a través de un codificador de texto.
- El espacio latente permite hacer los cálculos sobre una representación pequeña; el resultado se devuelve a píxeles al final.
- La semilla fija el ruido inicial, la escala de guía controla el peso del prompt y la intensidad determina cuánta fidelidad se mantiene a la foto.
- Para un buen resultado, describe el sujeto, la luz, el encuadre y el estilo, y cambia una sola cosa cada vez al probar.
Preguntas frecuentes
¿Los modelos de imagen con IA copian imágenes de internet?
En general no: el modelo aprende patrones de los ejemplos del entrenamiento y calcula cada imagen paso a paso. Sin embargo, los investigadores han mostrado que algunas imágenes del conjunto de entrenamiento (entre ellas, fotos de personas y logotipos) pueden reproducirse casi idénticas. Evita los prompts que imitan al pie de la letra una obra o a una persona.
¿Por qué con el mismo prompt salen imágenes distintas?
Porque cada generación empieza con un ruido aleatorio distinto. Si fijas la semilla, el ruido inicial también queda fijo y, con los mismos ajustes, suele obtenerse el mismo o un resultado muy parecido; con distinto hardware o versión de software puede haber pequeñas diferencias.
¿Más pasos significan siempre mejor resultado?
No. Con muy pocos pasos la imagen queda a medias, pero a partir de cierto punto los pasos extra apenas cambian el resultado y solo alargan el tiempo. Los métodos de muestreo como DDIM se desarrollaron precisamente para obtener buenos resultados con menos pasos.
¿Debo subir al máximo la escala de guía (CFG)?
Normalmente no. Los valores altos atan más el resultado al prompt, pero reducen la variedad, y los valores muy altos pueden producir imágenes sobresaturadas y de aspecto artificial. Lo más seguro es empezar con el valor predeterminado del modelo y cambiarlo en pequeños pasos.
¿Cómo evito que cambie el rostro al generar una imagen a partir de una foto?
Mantén baja la intensidad (strength), que determina cuánto ruido se añade a la foto, y en el prompt describe solo lo que quieres que cambie. Cuanto más alta sea la intensidad, más libertad se toma el modelo con la foto y los rasgos del rostro pueden cambiar.
Fuentes
- Sohl-Dickstein et al. (2015), Deep Unsupervised Learning using Nonequilibrium Thermodynamics
- Ho, Jain, Abbeel (2020), Denoising Diffusion Probabilistic Models
- Song, Meng, Ermon (2020), Denoising Diffusion Implicit Models
- Radford et al. (2021), Learning Transferable Visual Models From Natural Language Supervision (CLIP)
- Meng et al. (2021), SDEdit: Guided Image Synthesis and Editing with Stochastic Differential Equations
- Rombach et al. (2022), High-Resolution Image Synthesis with Latent Diffusion Models
- Saharia et al. (2022), Photorealistic Text-to-Image Diffusion Models with Deep Language Understanding (Imagen)
- Ho, Salimans (2022), Classifier-Free Diffusion Guidance
- Peebles, Xie (2022), Scalable Diffusion Models with Transformers
- Carlini et al. (2023), Extracting Training Data from Diffusion Models
- Esser et al. (2024), Scaling Rectified Flow Transformers for High-Resolution Image Synthesis
- OpenAI (2025), Addendum to GPT-4o System Card: Native image generation
- Hugging Face Diffusers: Understanding pipelines, models and schedulers
- Hugging Face Diffusers: Image-to-image
- Hugging Face Diffusers: Reproducibility
Entradas relacionadas
Guías
¿Cómo genera vídeo la IA? La idea detrás del movimiento
Un modelo de vídeo con IA no dibuja los fotogramas uno a uno, sino que construye el movimiento como conjunto. Explicamos cómo se extiende la difusión al tiempo, por qué los clips son cortos y la diferencia entre texto y foto.
8 min de lectura
Guías
Coste de generar con IA: cómo funcionan los créditos y tokens
Las herramientas de IA cobran cada generación con créditos o tokens, porque cada una supone un cálculo real. El coste lo definen el modelo, la resolución y la duración; también reunimos cómo gastar menos.
8 min de lectura
Guías
Navegador o aplicación para IA: qué mirar antes de elegir
El navegador es más cómodo para un trabajo detallado en pantalla grande; la app, para generar rápido desde el teléfono. Te explicamos las diferencias en pantalla, subida, privacidad, pagos, notificaciones y uso sin conexión, y cómo elegir.
8 min de lectura