Guías
¿Cómo genera vídeo la IA? La idea detrás del movimiento
Un modelo de vídeo con IA no dibuja los fotogramas uno a uno, sino que construye el movimiento como conjunto. Explicamos cómo se extiende la difusión al tiempo, por qué los clips son cortos y la diferencia entre texto y foto.
Equipo de Zling AI8 min de lectura
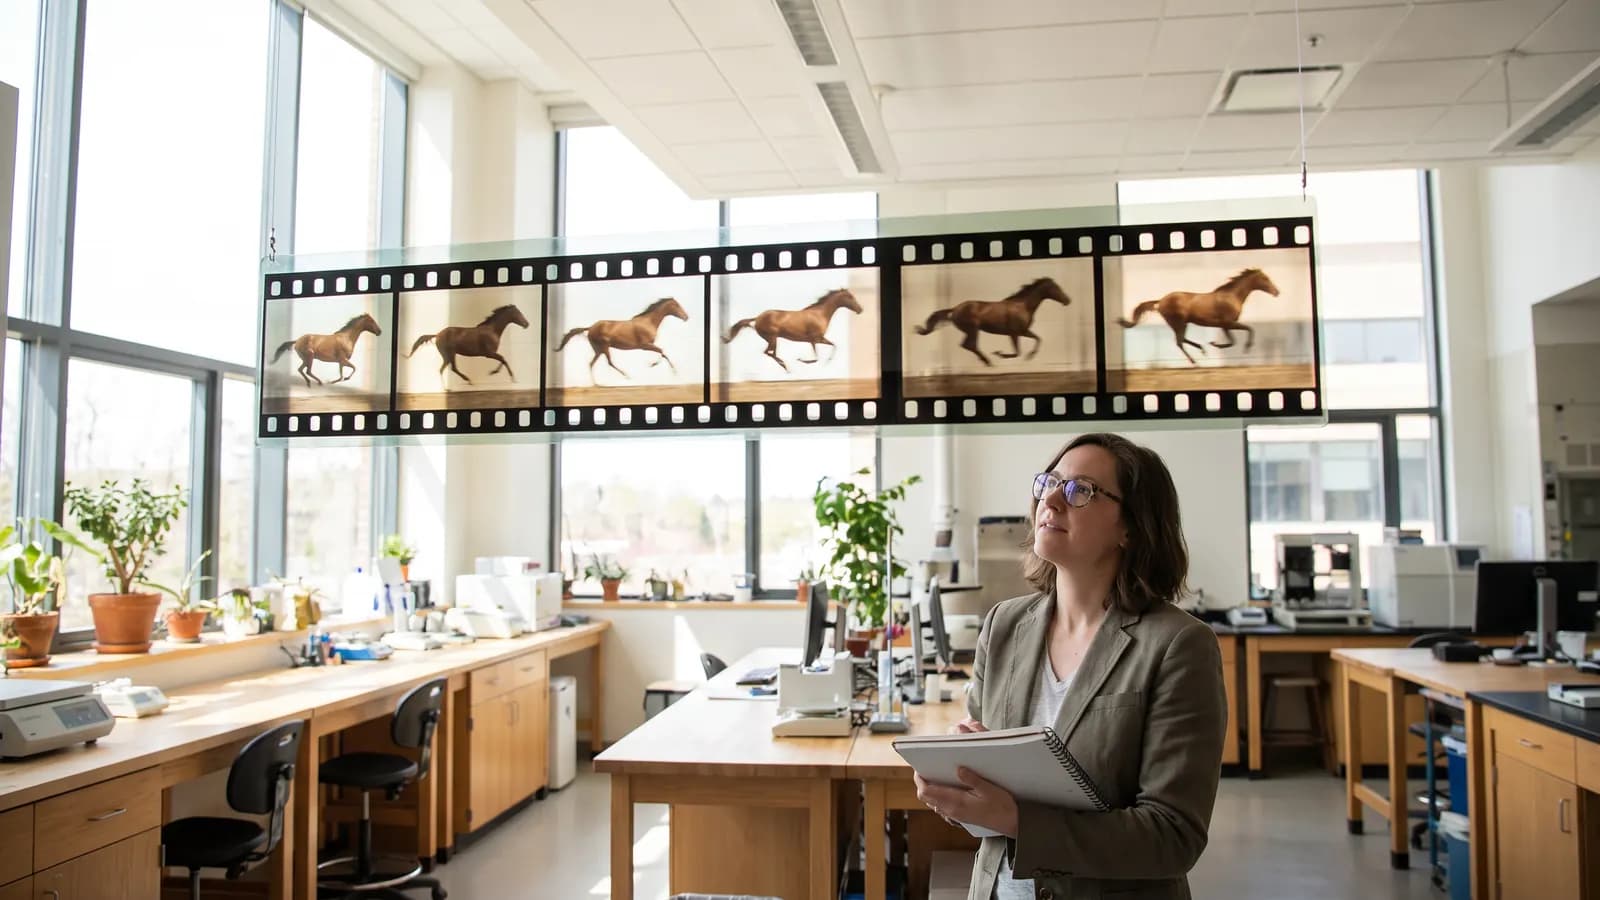
Respuesta corta: un modelo de vídeo con IA no dibuja el vídeo fotograma a fotograma como imágenes sueltas; genera los fotogramas como un solo conjunto, teniendo en cuenta a la vez el movimiento y el tiempo. La idea básica es la misma que usa la generación de imágenes, la difusión, pero el dato ya no es una imagen, sino una secuencia de fotogramas repartida en el tiempo. En este artículo explicamos cómo se hace, por qué los clips son cortos y en qué se diferencian el texto y la foto como entrada, basándonos en lo que dicen los artículos de investigación correspondientes.
¿Qué es realmente un vídeo y cómo lo ve el modelo?
Un vídeo es una sucesión de fotogramas que se muestran uno tras otro a un número determinado por segundo. Para el modelo, eso es un bloque de datos con altura, anchura y un eje de tiempo. Si quieres una introducción sencilla a la generación de imágenes, puedes leer nuestro artículo ¿Cómo genera imágenes la IA?; la lógica de partir del ruido y limpiarlo paso a paso también vale aquí. La diferencia es que lo que se limpia no es un solo fotograma, sino un bloque completo que incluye la relación entre fotogramas.
¿Cómo se extendió la difusión al tiempo?
El artículo de Ho y sus colegas sobre difusión de vídeo describe el enfoque como una extensión natural de la arquitectura de difusión para imágenes. Destaca dos cosas: entrenar el modelo con imágenes y vídeos a la vez acelera el entrenamiento y reduce la variabilidad del gradiente; y un nuevo método de muestreo condicional permite extender el vídeo tanto en el espacio como en el tiempo. El mismo artículo informa de los primeros resultados de generación de vídeo a partir de texto a gran escala.
Imagen Video, por su parte, no usa un único modelo enorme, sino una cadena. Primero trabaja un modelo base que genera vídeo en baja resolución; después, modelos de superresolución espacial (que afinan los fotogramas) y temporal (que suavizan el movimiento) amplían el resultado por turnos. Así, la resolución y la fluidez se resuelven en etapas separadas.
Modelos más recientes: parches de espacio-tiempo
El informe técnico de Sora de OpenAI resume una idea común a muchos sistemas actuales: los modelos de difusión basados en texto se entrenan con vídeos e imágenes de distinta duración, resolución y proporción; el modelo es un transformador que trabaja sobre parches de espacio-tiempo de los códigos latentes del vídeo y de las imágenes. Primero, una red de compresión reduce el vídeo a un espacio latente pequeño, y los parches que se recortan de ese espacio actúan como «tokens» para el transformador. Al final, un decodificador convierte los códigos latentes de nuevo en píxeles. El informe también indica que el modelo más grande puede generar un vídeo de alrededor de un minuto. El propio informe presenta resultados cualitativos y no comparte los detalles del modelo.
El artículo Movie Gen de Meta señala una dirección parecida: su modelo de vídeo más grande, un transformador de 30 000 millones de parámetros, genera vídeo en HD de 1080p con sonido sincronizado, y además puede crear un vídeo personalizado a partir de la imagen de un usuario y editar un vídeo siguiendo instrucciones.
¿Qué es la coherencia temporal y por qué cuesta tanto?
La coherencia consiste en que el rostro del personaje, su ropa y la escena se mantengan iguales de un fotograma a otro, y en que el movimiento tenga sentido físico. Si generaras cada fotograma por separado, aparecerían pequeñas diferencias en cada uno y el vídeo parpadearía. Esta es la razón principal por la que los modelos procesan los fotogramas juntos: cada uno se genera «viendo» lo que contienen los fotogramas vecinos.
Aun así, la coherencia no está garantizada. En movimientos largos o complejos, el número de dedos de una mano puede cambiar, los objetos pueden desaparecer o transformarse en otra cosa. Esto ocurre porque el modelo no conoce las leyes de la física; solo ha aprendido patrones de sus datos de entrenamiento, y en el mejor de los casos hace una predicción muy buena.
¿Por qué los clips de IA son cortos?
Las fuentes oficiales no ofrecen una explicación de una sola frase, pero las cifras dan pistas. El artículo Movie Gen indica que el contexto del modelo llega como máximo a 73 000 tokens de vídeo, lo que equivale a unos 16 segundos a 16 fotogramas por segundo. La página de comparación de Veo de Google señala además que los vídeos de Veo duran 8 segundos. En términos generales, cada segundo adicional aumenta tanto el número de tokens que hay que procesar como el coste de memoria y de cálculo; en la atención, el coste crece deprisa a medida que la secuencia se alarga. Los errores también se acumulan: un rostro que es correcto en el primer segundo puede desviarse diez segundos después.
La solución habitual para una escena más larga es continuar el clip existente. La muestra condicional de Ho y sus colegas da la base académica para extender un vídeo en el tiempo enlazándolo con la parte anterior, y la página de Veo indica que los clips pueden alargarse con la función de extensión de escena. En la práctica, esto significa generar varios clips cortos seguidos y montarlos.
Vídeo a partir de texto y vídeo a partir de foto: la diferencia
| Entrada | Qué hace el modelo | Punto fuerte | Atención |
|---|---|---|---|
| Solo texto | Construye la escena, la persona y el movimiento desde cero | Creatividad libre | La composición y el personaje son difíciles de prever |
| Foto (+ texto) | Toma el fotograma que le das como inicio y añade el movimiento | El aspecto se mantiene y tienes más control | El modelo inventa las zonas nuevas que quedan fuera de la foto |
| Primer y último fotograma | Genera la transición entre dos fotogramas | Tú decides el inicio y el final | No todos los modelos lo admiten |
El artículo de Stable Video Diffusion señala que el modelo base aprende una representación sólida del movimiento, y que puede adaptarse a tareas derivadas como el paso de foto a vídeo. La página de Veo, por su parte, menciona junto a la generación de texto a vídeo las entradas de foto a vídeo, de primer y último fotograma y de imágenes de referencia. Así, la foto responde a la pregunta «cómo debe verse», y el texto, a «qué debe pasar».
¿Por qué son tan importantes los datos de entrenamiento?
El artículo de Stable Video Diffusion describe tres fases para entrenar un modelo de vídeo: preentrenamiento de texto a imagen, preentrenamiento con vídeo y ajuste fino con vídeo de alta calidad. Los autores señalan que para un buen modelo hace falta un conjunto de datos de preentrenamiento bien seleccionado, y que el subtitulado y el filtrado forman parte de ese proceso. En consecuencia, lo que el modelo hace bien depende del tipo de movimiento que ha visto. Con movimientos poco comunes o escenas inusuales, la calidad baja.
¿Qué puedes hacer para mejorar el resultado?
- Pide un solo movimiento: en lugar de «la mujer gira, sonríe, saluda y se aleja», elige una sola acción.
- Nombra la cámara: plano fijo, acercamiento lento, seguimiento lateral, etc.
- Da tú el fotograma inicial: si la coherencia es importante, prueba el modo de foto a vídeo.
- Genera corto y luego une: en lugar de una petición larga, clips cortos y controlados.
- Haz varias pruebas: la misma petición da resultados distintos.
Ejemplo de petición: Cámara fija, una mujer con chaqueta roja caminando por la orilla del mar al atardecer, su pelo se mueve ligeramente con el viento, ritmo lento y natural.
¿Cómo encajan el sonido y el movimiento de cámara?
Algunos modelos generan también sonido, no solo imagen. El artículo Movie Gen dice que, junto al vídeo HD de 1080p, produce sonido sincronizado; la página de Veo señala que el sonido se genera de forma nativa y que pueden añadirse efectos, sonido ambiente y diálogos. Como el sonido se planifica junto con la imagen, la sincronía de los labios y el momento del evento son más fáciles de lograr que cuando se añade un audio aparte. Aun así, la página indica expresamente que la conversación coherente sigue siendo un campo en desarrollo.
En cuanto al movimiento de cámara, el artículo de Stable Video Diffusion ofrece un detalle interesante: el modelo base puede adaptarse a pequeños módulos LoRA entrenados para movimientos de cámara específicos. Es decir, movimientos como «acercamiento lento» o «desplazamiento lateral» son una habilidad aparte que el modelo puede aprender. Por eso, nombrar la cámara en la petición ayuda a activar esa habilidad.
Errores frecuentes
- Escribir muchas acciones en una sola petición: el modelo mezcla los movimientos o los omite.
- No indicar el movimiento de cámara: el modelo elige una cámara al azar.
- Esperar una física perfecta: revisa siempre el resultado fotograma a fotograma.
- Pedir un clip largo de una vez: a más duración, menos coherencia.
- Dar por hecho que la conversación se genera bien: la página de Veo indica que el habla coherente sigue siendo un campo en desarrollo, sobre todo en fragmentos cortos.
- Publicar sin aclarar que es IA: algunos sistemas, como Veo, marcan su resultado con SynthID; al compartirlo, indica tú también que es artificial.
Resumen
- Los modelos de vídeo generan los fotogramas juntos, teniendo en cuenta el tiempo; en su base suele haber difusión y, en muchos casos, un transformador.
- La coherencia entre fotogramas es un objetivo, no una garantía.
- La limitación de duración viene del coste de cálculo y de la acumulación de errores; las escenas largas se construyen alargando o uniendo clips.
- El texto define qué pasa y la foto, cómo se ve; el primer y último fotograma une ambas cosas.
- Un solo movimiento, una cámara bien nombrada y varias pruebas suelen dar el mejor resultado.
Preguntas frecuentes
¿Un modelo de vídeo con IA dibuja cada fotograma como una imagen aparte?
No. El artículo sobre difusión de vídeo describe el enfoque como una extensión de la difusión de imágenes, y los fotogramas se procesan juntos. Así se busca la coherencia entre fotogramas, aunque no está garantizada.
¿Por qué los vídeos suelen durar unos pocos segundos?
Las fuentes oficiales no dan una sola razón. El artículo Movie Gen indica que el contexto está limitado a 73 000 tokens de vídeo, unos 16 segundos, y la página de Veo indica que sus vídeos duran 8 segundos. En general, al aumentar la duración suben el coste de cálculo y la acumulación de errores.
¿Cómo se consigue un vídeo más largo?
La vía habitual es continuar el clip existente o generar varios clips cortos seguidos y unirlos. La página de Veo indica que los clips pueden alargarse con la función de extensión de escena.
¿Es mejor el vídeo a partir de foto o a partir de texto?
Si quieres que el aspecto se mantenga, el vídeo a partir de foto suele ser más controlable, porque tú das el primer fotograma. Si buscas una escena libre, con el texto basta.
¿El informe de Sora describe el modelo que usan todos los sistemas?
No. El informe describe un método y resultados cualitativos, sin compartir los detalles del modelo. El transformador que trabaja con parches de espacio-tiempo es un enfoque habitual, pero el interior de cada sistema no es igual.
Fuentes
- Ho ve ark.: Video Diffusion Models (arXiv:2204.03458)
- Ho ve ark.: Imagen Video: High Definition Video Generation with Diffusion Models
- Blattmann ve ark.: Stable Video Diffusion (arXiv:2311.15127)
- Meta: Movie Gen: A Cast of Media Foundation Models (arXiv:2410.13720)
- OpenAI: Video generation models as world simulators
- Google DeepMind: Veo
Entradas relacionadas
Guías
¿Cómo genera imágenes la IA? Introducción sencilla a la difusión
La IA no recorta ni pega imágenes de un archivo: empieza con ruido aleatorio y lo limpia paso a paso. Explicamos la lógica de la difusión, el lugar del prompt en ese proceso y qué cambia cada ajuste.
11 min de lectura
Guías
Coste de generar con IA: cómo funcionan los créditos y tokens
Las herramientas de IA cobran cada generación con créditos o tokens, porque cada una supone un cálculo real. El coste lo definen el modelo, la resolución y la duración; también reunimos cómo gastar menos.
8 min de lectura
Guías
Navegador o aplicación para IA: qué mirar antes de elegir
El navegador es más cómodo para un trabajo detallado en pantalla grande; la app, para generar rápido desde el teléfono. Te explicamos las diferencias en pantalla, subida, privacidad, pagos, notificaciones y uso sin conexión, y cómo elegir.
8 min de lectura